Videre til indhold

Linux-cgroup’en CPU-controller styrer, hvor meget regnetid tjenester, containere og processer tildeles, og gør det muligt at planlægge ydeevnen målrettet. Jeg forklarer konkret, hvordan vægtning, kvoter og fremgangsmåder spiller sammen, så du kan tildele CPU-tid på en sikker måde og undgå flaskehalse.
Centrale punkter
- vægtning i forhold til Grænse forstå: retfærdig fordeling eller en streng øvre grænse
- cgroup v2 foretrækker: klar semantik, konsistent hierarki
- cpu.vægt og cpu.max: de to betjeningshåndtag
- systemd Fordel: Indstil regler for hver tjeneste
- Overvågning og Gennemsigtighed: aflæsning af cpu.stat og PSI
Forståelse af cgroups: Procesgrupper og mål
Jeg sammenfatter processer i Grupper sammen og styrer derigennem ressourcer som CPU, hukommelse og I/O i klart afgrænsede hierarkier. I stedet for at jonglere med enkelte PID’er tildeler jeg hele tjenester, containere eller worker-pools til en kontrolgruppe og fastlægger klare regler. På den måde forhindrer jeg, at en opblomstrende opgave bremser maskinen, mens vigtige komponenter skal reagere. Især i en hosting-sammenhæng betaler denne tilgang sig, fordi mange kunder og tjenester kører på samme hardware. Dette indlæg giver et godt overblik over den praktiske inddeling: cgroups og hosting, der gør fordelingen af byrder forståelig.
Sådan fungerer CPU-controlleren
CPU-controlleren fordeler beregningstid om to mekanismer: relativ vægtning og absolut båndbreddebegrænsning. Vægtning betyder, at grupper tildeles CPU-andele i forhold til hinanden, så snart der opstår konkurrence; grupper med højere værdier vinder da oftere tidsintervaller. En kvotebegrænsning sætter et loft over forbruget i et fast tidsvindue, selvom der ikke er konkurrence. Jeg vælger vægtning, når retfærdighed og dynamisk udnyttelse er i forgrunden, og indstiller kvoter, når en fast øvre grænse skal forblive urokkelig. Kernel-dokumentationen illustrerer denne forskel tydeligt og viser, hvordan begge mekanismer tilsammen udgør en sammenhængende styringsmodel [1].
cgroup v1 vs. v2: Forskelle og filer
Med cgroup v2 Jeg administrerer CPU-reglerne på en ensartet og mere overskuelig måde sammenlignet med den ældre v1-variant. I v1 brugte jeg forskellige filer for hver controller; i v2 fokuserer jeg på `cpu.weight` til relativ prioritet og `cpu.max` til en fast båndbreddegrænse. Denne klare opdeling forkorter opsætningstiden, undgår misforståelser og letter revisioner. I hosting-scenarier med mange containere sikrer v2-hierarkiet gennemsigtige regler på alle niveauer. En vurdering af praksis findes i artiklen om cgroup v2 i hosting, der omhandler konsistent styring af fælles hardware.
| Emne | cgroup v1 | cgroup v2 | Typiske parametre |
|---|---|---|---|
| CPU-vægtning | cpu.shares | cpu.vægt | cpu.vægt (Standardværdien er ofte 100) |
| CPU-kvote/begrænsninger | cpu.cfs_quota_us + cpu.cfs_period_us | cpu.max | cpu.max (f.eks. 20.000 100.000) |
| Hierarki | Separate controllere | Ensartet træstruktur | Fælles regler for hvert niveau |
| I realtid | Separat rt-controller | Begrænsninger for RT | Se bemærkninger til kernen [1] |
For administratorer er det vigtigt, at Konsistens Reducerer fejl i regelværket og sikrer, at ændringer træder i kraft hurtigere. Jeg dokumenterer parametrene på gruppeknudepunkterne, så alle kan se den aktuelle effekt. Ved migreringer fra v1 tjekker jeg omhyggeligt ækvivalenter, især »Shares« i forhold til »Weight« og »CFS-Quota« i forhold til »cpu.max«. Først når testbelastningerne reagerer som forventet, flytter jeg produktive tjenester over i den nye hierarki. Denne disciplinerede overgang sparer mange supportcyklusser senere hen.
Hierarki, undertræer og delegering
I cgroup v2 styrer jeg controlleren pr. niveau og uddelegér dem efter behov. Via cgroup.subtree_control aktiverer jeg CPU-controlleren for underknudepunkter; systemd klarer det som regel automatisk, når jeg angiver CPU-egenskaber. Vigtigt: I v2 holder jeg helst processerne i Bladgrupper og ikke i mellemliggende knudepunkter. På den måde forbliver reglerne mere entydige, og belastningsfordelingen følger tydeligt træstrukturen. I komplekse opsætninger tildeler jeg hele tjenester til slices (f.eks. tenant-a.slice), herunder tjenester og arbejdspooler. Denne klare opdeling gør det lettere at delegere opgaver til teams, der arbejder i „deres“ undertræer, uden at overtræde globale retningslinjer.
Vigtige parametre: cpu.weight og cpu.max
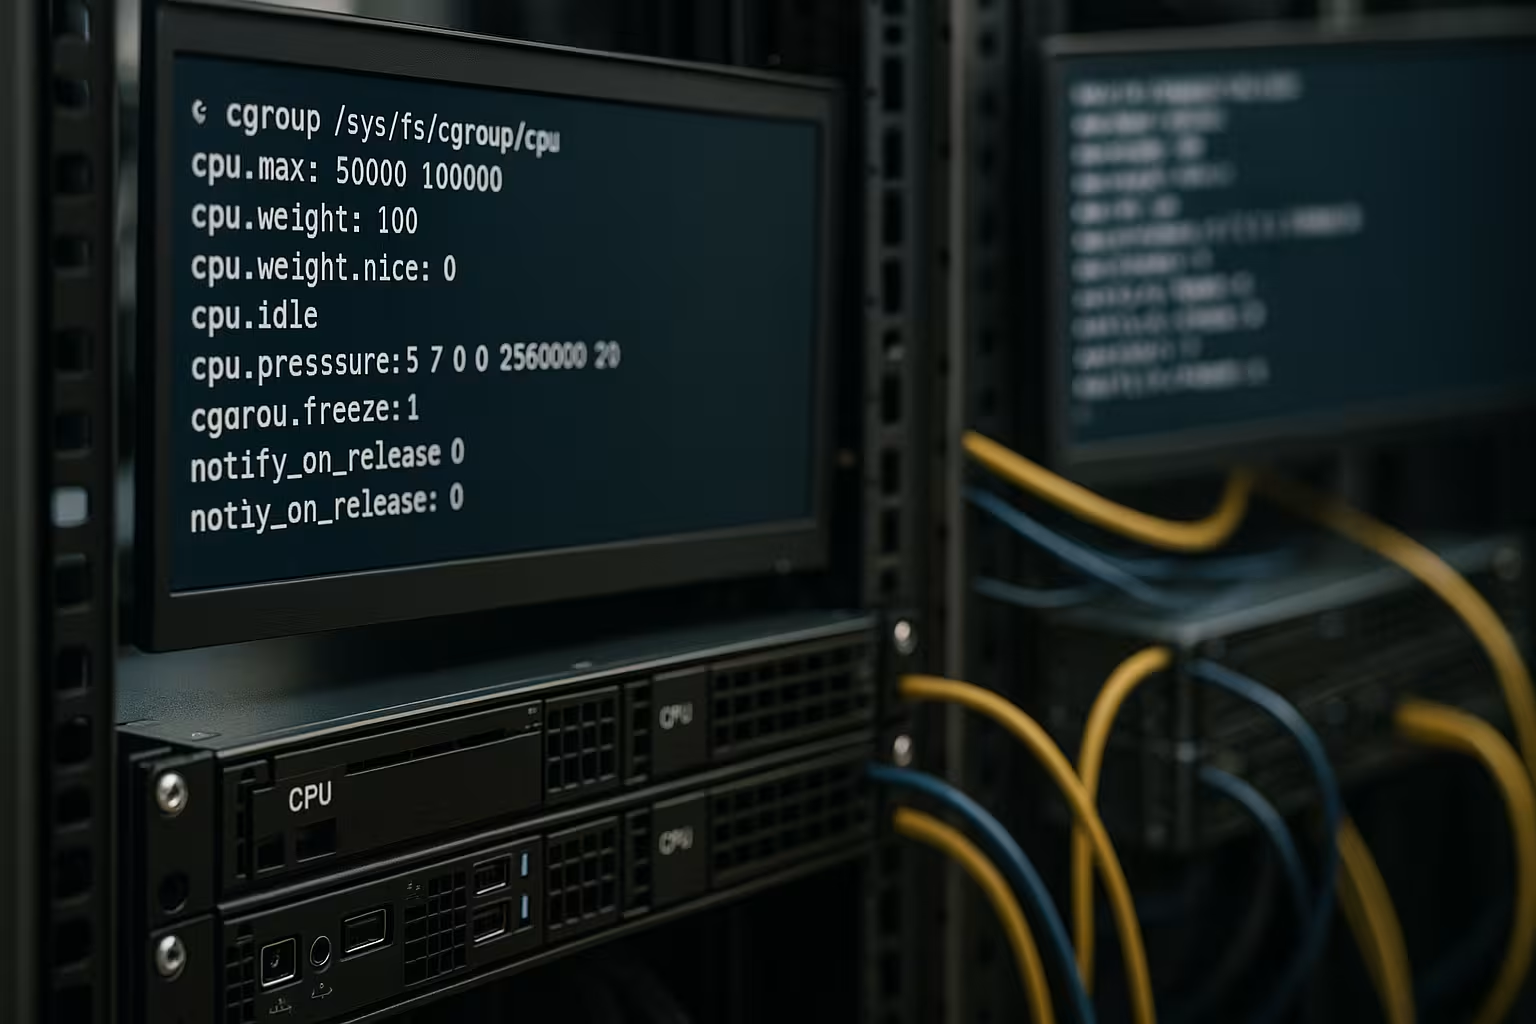
Jeg bruger cpu.vægt, for at prioritere tjenesterne i forhold til hinanden: Hvis tjeneste A tildeles en højere vægt end tjeneste B, får A oftere CPU-tid under belastning. Standardværdien i v2 er ofte 100; højere værdier prioriterer den pågældende gruppe, men jeg holder mig inden for rimelige grænser for at bevare kontrollen over forholdet. For strenge begrænsninger skriver jeg i cpu.max en kvote og en periode, for eksempel 20000 100000 for cirka 20 procent af en vCPU-slot. Med max Som det første fjerner jeg begrænsningen, men lader perioden være, hvilket gør det nemmere at stille diagnoser. Red Hat dokumenterer almindelige indstillinger på en forståelig måde og viser konsekvenserne i drift [2].
Yderligere justeringsparametre: cpu.weight.nice og UClamp
Til hold, der går væk fra den klassiske nice-semantik, tilbyder v2 med cpu.weight.nice en praktisk bro: Jeg kan gruppere inden for området -20..19 klassificere, som internt afspejles i vægtskalaen. På den måde forbliver de relative forventninger („foretrækker lidt“, „dæmper lidt“) konsistente, uden at man hver gang skal fastlægge konkrete vægte. Derudover anvender jeg, hvis det er nødvendigt, Udnyttelsesklemme via cpu.uclamp.min og cpu.uclamp.max, for at fastsætte en minimums- eller maksimumsgrænse for den effektive CPU-udnyttelse på scheduler-niveau. På den måde sikrer jeg f.eks., at en latenstkritisk tjeneste ikke falder under den nødvendige basisudnyttelse, selv ved et lavt antal tråde, eller at batch-jobs ikke får for stor en boost. Denne finjustering supplerer vægtning og kvoter, men erstatter dem ikke: Jeg måler altid, hvordan UClamp fungerer sammen med min governor- og energipolitik, før jeg implementerer det bredt.
Planlægning af arbejdsbelastninger: Retfærdighed kontra strenge grænser
Jeg beslutter bevidst, om Retfærdighed eller strenge øvre grænser har forrang. For webtjenester, hvor ventetiden er afgørende, øger jeg vægten en smule, så de får forrang i konkurrencesituationer uden at stille andre grupper urimeligt dårligt. For beregningsintensive batch-jobs indfører jeg desuden en kvote, så de aldrig optager for meget tid, selvom systemet ellers står i tomgang. Databaser vægter jeg moderat og overvåger, hvordan checkpoints, genopbygninger eller store forespørgsler påvirker systemet; om nødvendigt foretager jeg midlertidige justeringer. Disse regler kombinerer jeg med alarmer, så jeg kan reagere tidligt, inden forsinkelserne eskalerer.
Kvoteadfærd på multicore og valg af periode
En hyppig faldgrube er fortolkningen af Ydeevne på multicore-systemer. En kvote vedrører Samlet regnetid for gruppen pr. periode, ikke for de enkelte kerner. CPUQuota=200% eller cpu.max = 200.000 100.000 tillader groft sagt to CPU-sekunder pr. 100 ms-periode – fordelt på alle tråde/kerner. Det kan betyde, at mange tråde kører parallelt i kort tid, indtil gruppen i den aktuelle periode er „opbrugt“ og bliver bremset. Jeg undgår misforståelser ved altid at tænke på kvoter i form af „CPU-slots“ og tilpasse dem til tjenestens parallelitet.
Standardperioden er ofte på 100 ms. Kortere perioder (z. B. 50 ms) får begrænsningen til at træde hurtigere i kraft, men kan forårsage mikrojitter; længere perioder udjævner, men reagerer langsommere. Under systemd justerer jeg dette med CPUQuotaPeriodSec= og kontrollerer, om det er bedre at opfylde latenstidstoppe eller gennemstrømningsmål. For interaktive tjenester måler jeg ende-til-ende-latenstid, mens jeg for batch-opgaver fokuserer på den samlede gennemstrømning og retfærdighed over for naboer.
Praksis: Konfiguration med systemd og cgroup v2
I systemd opretter jeg regler for hver enkelt tjeneste, fordi Tjenestedokumenter muliggøre en reproducerbar konfiguration. Med systemctl set-property Jeg ændrer dem løbende, og med drop-in-filer versionerer jeg indstillingerne på en overskuelig måde. Et eksempel: systemctl set-property --runtime nginx.service CPUWeight=150 prioriterer NGINX let; systemctl set-property --runtime batch.service CPUQuota=20% afslutter batch-job. Jeg indtaster altid i /etc/systemd/system/service.d/limits.conf Indstil de relevante indstillinger og genindlæs enhederne. For en praktisk introduktion kan det være en god idé at kigge på denne vejledning til systemd-ressourcestyring, der kort opsummerer de mest almindelige muligheder.
# Eksempler på systemd v245+ med cgroup v2
# Relativ prioritering
systemctl set-property --runtime nginx.service CPUWeight=150

# Fast øvre grænse
systemctl set-property --runtime batch.service CPUQuota=20%

# Kombination i en drop-in-fil
mkdir -p /etc/systemd/system/php-fpm.service.d
cat < /etc/systemd/system/php-fpm.service.d/cpu.conf
[Service]
CPUWeight=120
CPUQuota=50%
EOF
systemctl daemon-reload
systemctl restart php-fpm.service
Slices til lejere og teams
Til at afgrænse klienter eller teams bruger jeg Skiver som organisatorisk ramme. Et »slice« omfatter flere tjenester og omfang, der reguleres samlet. På den måde kan jeg tildele budgetter pr. kunde uden at skulle vedligeholde hver enkelt enhed og delegere ændringer på en kontrolleret måde.
# Tenant-Slice med standardregler
mkdir -p /etc/systemd/system/tenant-a.slice.d
cat < /etc/systemd/system/tenant-a.slice.d/cpu.conf
[Slice]
CPUWeight=120
CPUQuota=150%
# Valgfrit: Periode for mere præcis begrænsning
CPUQuotaPeriodSec=100ms
EOF
systemctl daemon-reload
systemctl restart tenant-a.slice
Alle tjenester under tenant-a.slice arver disse indstillinger. Ved kortvarige spidsbelastninger øger jeg vægten midlertidigt, men holder kvoten stabil, så nabosystemerne ikke fortrænges.
Overvågning og fejlfinding
Jeg undersøger virkningen og bivirkningerne ved hjælp af Gennemsigtighed i måleenheder. Filerne cpu.stat og cpu.pressure (PSI) pr. cgroup giver mig andele, ventetider og flaskehalse, der tyder på begrænsninger eller overbelastning. Med top, htop og systemd-cgtop Jeg identificerer fordelingstendenser i realtid og afstemmer dem med mine regler. Hvis latenstiderne stiger, men CPU’en er inaktiv, skyldes problemet snarere I/O eller låse end CPU-begrænsninger; jeg justerer derfor ikke vægtningen forhastet. Efter ændringer dokumenterer jeg måleværdierne over mindst én belastningscyklus for at undgå falske sammenhænge.
Overvågningshåndbog: Hvad jeg konkret læser
cpu.stat: usage_usec, bruger_bruger, system_usec viser forbrug; nr_perioder, nr_throttled, throttled_usec afslører kraftig begrænsning. Stiger nr_throttled/nr_periods mere end et par procent, er intervallet for snævert eller perioden for kort.cpu.pressure: Jeg observerer nogle gange avg10/60/300 for latenstidsrelevante flaskehalse. En vedvarende forhøjet værdi på trods af ledige CPU’er tyder på lock-contention, affinitetskonflikter eller NUMA-fjernadgang.systemd-cgtopogps: Jeg undersøger, om tråde virkelig kan køre parallelt, eller om de venter på eksklusive ressourcer.
For at sikre reproducerbare test bruger jeg stress-ng, sysbench eller egne belastningsgeneratorer og tager måleværdi-snapshots før og efter. Først når måleværdierne stabilt lever op til forventningerne, implementerer jeg ændringerne.
Realtid og særlige forhold
Med I realtid-Når det gælder arbejdsbelastninger, følger jeg anvisningerne i kerne-dokumentationen, da v2 kun i begrænset omfang styrer CPU-controlleren for RT. Visse RT-tråde skal placeres i root-cgroup, og konfigurationen kræver omhyggelig håndtering. Jeg undersøger desuden, hvordan RT-scheduling fungerer sammen med kvoter, så ingen deadline utilsigtet overskrides. Til typiske web- og databasetjenester bruger jeg normale politikker, da denne konstellation er mere pålidelig i dagligdagen. Når jeg har brug for RT, adskiller jeg systemer eller reserverer kerner tydeligt, så der ikke opstår uventede interaktioner [1].
Finstyring på multi-core-systemer
CPU-controlleren fordeler Tidsvindue, ikke klokfrekvens, derfor kombinerer jeg det om nødvendigt med cpuset og affinitet. For at opnå lav latens begrænser jeg skift mellem sockets, binder tråde til NUMA-lokale kerner og optimerer IRQ-fordelingen. Jeg lader batch-tjenester køre mere fleksibelt, så de kan udnytte ledig kapacitet uden at blokere kerner til kritiske frontends. Jeg gennemgår turbo- eller strømbesparelsespolitikker, da frekvensændringer kan ændre adfærden under belastning markant. Først summen af kvoter, vægtninger, CPU-affinitet og energistrategi giver konsistente resultater.
SMT, NUMA og affinitet i praksis
På systemer med SMT/Hyper-Threading Jeg bemærker, at to logiske tråde på en fysisk kerne ikke udgør to fulde CPU-slots. En kvote på „100 %“ dækker et logisk slot, ikke nødvendigvis en fuld fysisk kernes ydeevne. Derfor måler jeg latenstid og gennemstrømning med og uden brug af SMT. På NUMA-systemer begrænser jeg kritiske tjenester med AllowedCPUs= (cpuset) eller CPUAffinitet=. Brug lokale kerner og juster hukommelsesallokeringen i overensstemmelse hermed, så fjernadgang ikke ødelægger al detaljeplanlægningen.
Bedste praksis for hosting og containere
Jeg begynder med moderat Standardindstillinger: Webtjenester vægtes lidt højere, databaser tæt på standard, batch med kvote. For lejere fastsætter jeg øvre grænser pr. kunde og tillader spidsbelastning via vægtning, så længe der ikke er andre behov. Jeg dokumenterer profiler efter use case, f.eks. „latenskritisk“, „blandet“ og „beregningsintensiv“, og fastlægger klare intervaller for weight og cpu.max pr. profil. Ændringer implementerer jeg først i staging og tester dem med syntetisk belastning, der realistisk afspejler spidsbelastningerne. Jeg holder logs og metrics tæt på cgroup-grænserne, så fejlfinding ikke ender i tågen.
Container-orkestrering: Shares, Requests og Limits
I containermiljøer mapper jeg Forespørgsler relativ vægtning og Grænser på strenge kvoter. Dette muliggør burst-trafik, så længe noderne har ledig kapacitet, og sikrer en retfærdig fordeling i henhold til vægt i konkurrencesituationer. Kritiske pods eller tjenester tildeles lidt mere vægt, uden at begrænsningerne går ud over de andre. Jeg sørger for, at summen af begrænsningerne pr. node passer realistisk til den tilgængelige CPU-kapacitet; ellers opstår der trods klare regler en systemomfattende begrænsning, der rammer alle lejere.
Eksempelkonfigurationer og regneeksempler
Jeg omregner altid odds til Aktier pr. vCPU-slot: cpu.max = KVOTE-PERIODE svarer til KVOTE/PERIODE i spilleautomaten. Eksempel: 20000 100000 er 0,2 for en enkelt CPU; fordelt på fire CPU’er er det maksimalt 0,8 samlet slot, men fordelingen er ikke garanteret. For procentangivelser under systemd skriver jeg CPUQuota=20%, hvilket afhængigt af versionen stemmer overens med cpu.max. Hvis man sætter strenge grænser, skal man afveje burst-adfærd mod latenstid: En for kort periode kan forårsage mikrospring, mens en for lang periode fordeler belastningen mere jævnt, men reagerer langsommere. Jeg tester derfor perioder mellem 50–100 ms og vælger den variant, der passer til tjenestens latenstklasse [2].
Overgang fra v1 til v2 uden overraskelser
Når jeg skifter, overfører jeg cpu.shares på cpu.vægt og cpu.cfs_quota_us/period_us på cpu.max. En pragmatisk kortlægning af aktier er: 1024 → ~100, 2048 → ~200, 512 → ~50. Jeg foretager finjusteringer efter belastningstest, da skalaerne er forskellige. Jeg planlægger desuden, at v2-reglerne skal gælde for børn kumulativt virkning: En begrænsende kvote på forældreknudepunktet begrænser alle undergrupper samlet. Derfor ophæver jeg ofte forældrekvoter (max) og justerer detaljeret i lagene for at undgå bivirkninger.
Almindelige fejl og løsninger
- 100 % forveksles med „alle kerner“: 100 % svarer til en logisk CPU-slot, ikke til hele maskinen. Løsning: Beregn kvoten ud fra det nødvendige antal slots (f.eks. 400 % for fire slots).
- For kort cyklus: Små hak i interaktive tjenester. Løsning: Forøg perioden, eller brug vægt i stedet for kvote.
- Vægtning målt uden konkurrence: Vægten udøver først sin virkning under konkurrence. Løsning: Udfør test med reel parallelbelastning.
- Glem forældre-kvoterne: En begrænset forælder begrænser alle børn. Løsning:
cpu.max=maxpå moderen, grænser på bladene. - NUMA/sokkel ignoreres: Latens på trods af ledig CPU. Løsning: Kontroller affinitet/CPUSets og hukommelseslokalitet.
Sammenfatning
Med den CPU-controller Jeg tildeler regnetid målrettet, fastlægger retfærdige prioriteter og sætter strenge grænser, hvor det er nødvendigt. cgroup v2 tilbyder her klare parametre med cpu.weight og cpu.max, som jeg planlægger og måler afhængigt af arbejdsbelastningen. Via systemd fastlægger jeg regler for hver tjeneste, kontrollerer effekten med cpu.stat og PSI og justerer uden at gætte mig frem. For lejere, containere og blandede servermiljøer er denne styring afgørende for at opnå pålidelighed og forudsigelighed. Den, der dokumenterer reglerne, indfører dem trin for trin og sikrer dem med belastningstests, forhindrer flaskehalse og bevarer kontrollen over CPU-tiden.