 Videre til indhold

Jeg viser på en praktisk måde, hvordan IRQ-affinitet på multiprocessorsystemer målrettet knytter netværksinterrupts til CPU-kerner, reducerer latenstiden og øger gennemløbshastigheden. Ved hjælp af klare trin, eksempler og en tabel beskriver jeg, hvordan jeg vælger hex-masker, tager højde for NUMA og tildeler processer korrekt.
Centrale punkter
- IRQ-affinitet dirigerer hardware-interrupts målrettet til CPU’er og reducerer overhead.
- CPU-affinitet Ved at fastgøre tjenester til de samme kerner holdes cacherne lokalt.
- NUMA Bemærk, at adapteren og kernerne bruger den samme node.
- irqbalance afveje: automatisk fordeling eller manuel finjustering.
- Overvågning og iterativ tilpasning sikrer stabile latenstider.
Forståelse af IRQ-affinitet: Grundlæggende principper og virkning
På Linux-værter udløser indgående pakker, disk-I/O og timere IRQ'er som kernen fordeler på CPU-kerner. Jeg angiver via filerne /proc/irq//smp_affinity og .../smp_affinity_list, hvilke CPU'er der må betjene en kilde. En bred standardmaske virker umiddelbart fleksibel, men den medfører ved belastning cache-misses, ressourcekrævende kontekstskift og spredte SoftIRQ'er over mange CPU'er. Jeg knytter kritiske køer fra de enkelte netværkskort til definerede kerner, aflaster hotspots og holder dataveje korte. Denne styring forbedrer stabiliteten mærkbart, så snart der er mange datastrømme aktive på samme tid.
Justering af IRQ- og CPU-affinitet: Hold data lokalt
Det lykkedes mig at koble IRQ-NIC-køernes ansvarsområde i forhold til de relevante worker-tråds tilknytning til CPU'en. Til dette formål fastgør jeg webserver- eller proxy-tråde ved hjælp af opgavesæt eller CPUAffinitet=. i systemd til de kerner, der også behandler RX/TX-interrupts. Dermed forbliver cache-linjerne lokale, og jeg reducerer kommunikationen mellem CPU’erne til et minimum, hvilket Forsinkelse udjævnes. Især API-backends, realtidstjenester og virtualiserede stakke drager fordel af denne sammenhæng. Jeg tester integrationen under produktionsbelastning, indtil flows, SoftIRQ’er og brugerrummet passer perfekt sammen.
Automatisk mod finjustering: irqbalance skal indstilles korrekt
Tjenesten irqbalance fordeler interrupts automatisk på de tilgængelige kerner, hvilket fungerer godt på almindelige servere. I netværksopsætninger med høj belastning hæmmer denne spredning imidlertid cache-lokaliteten og gør målrettet pinning vanskeligere. Jeg begrænser eller deaktiverer irqbalance selektivt, når bestemte køer kræver faste kerner. Denne vejledning hjælper mig med at få en grundlæggende forståelse og finde passende profiler til Konfigurer irqbalance. Resultatet er, at den automatiske funktion styrer de ikke-kritiske IRQ’er, mens jeg manuelt tildeler de følsomme IRQ’er.
Trin: Gør relevante IRQ’er synlige
Jeg begynder med et kig på /proc/afbrydelser og filtrer efter enhedsnavnet, f.eks. ens192, eno1 eller eth0. Moderne adaptere opretter flere RX- og TX-køer, derfor finder jeg en gruppe af IRQ-numre, der er tildelt det samme netværkskort. Jeg holder øje med tællerstande for hurtigt at kunne identificere hotspots og først allokere køer, der er under stor belastning. Jeg tjekker denne oversigt regelmæssigt under belastningstests for at sikre, at allokeringen holder på lang sigt. Derudover kontrollerer jeg driverbetegnelser, da de giver oplysninger om RSS-funktioner og offloading.
# Se alle interrupts
cat /proc/interrupts

# Vis kun linjer, der er relevante for netværkskortet (eksempel: ens192)
grep -i ens192 /proc/interrupts
Udnyt NUMA-topologien klogt
På værter med flere noder foretrækker jeg at flytte IRQ’er til kerner i de NUMA-Den node, som netværkskortet er fysisk tilsluttet. Jeg tjekker det med lscpu og numactl --hardware og markerer relevante CPU-sæt til den senere maskedannelse. Processer, der benytter disse netværksstier, knytter jeg ligeledes til den samme node og sikrer via hukommelsespolitikker, at der er lokal Hukommelse-Tildelinger. På den måde undgår jeg dyre fjernadgange på tværs af QPI/UPI-forbindelserne. Denne disciplin giver hurtigt målbare fordele i latenstests.
Sådan vælger du bitmasker på en sikker måde: Hex-logik på et øjeblik
Filen smp_affinity accepterer hex-bitmasker, der direkte svarer til Core-ID’er og også dækker store systemer. Jeg starter ofte med enkle mønstre: CPU0 er 0x1, CPU1 er 0x2, CPU2 er 0x4, CPU3 er 0x8 osv., mens 0xF dækker kernerne 0–3. På maskiner med mange kerner skriver jeg flere 32-bit-blokke, adskilt af kommaer, så Maske alle ID'er er korrekt angivet. Denne oversigt hjælper mig med at foretage fejlfri tildelinger og undgå utilsigtede flytninger. Jeg bruger ofte nedenstående tabel som huskeseddel.
| CPU-nummer | Bit (binær) | Hex-maske | Hint |
|---|---|---|---|
| 0 | …0001 | 0x1 | CPU0 Ofte skal man aflaste den og kun bruge den sparsomt. |
| 1 | …0010 | 0x2 | IRQ til CPU1 pinnen. |
| 2 | …0100 | 0x4 | Forbind IRQ til CPU2. |
| 3 | …1000 | 0x8 | Forbind IRQ til CPU3. |
| 0–3 | …1111 | 0xF | Hvis alle fire kerner aktiveres, stiger latenstiden ofte en smule. |
| 0–7 | 11111111 | 0xFF | Bred fordeling, hvilket går ud over cache-lokaliteten. |
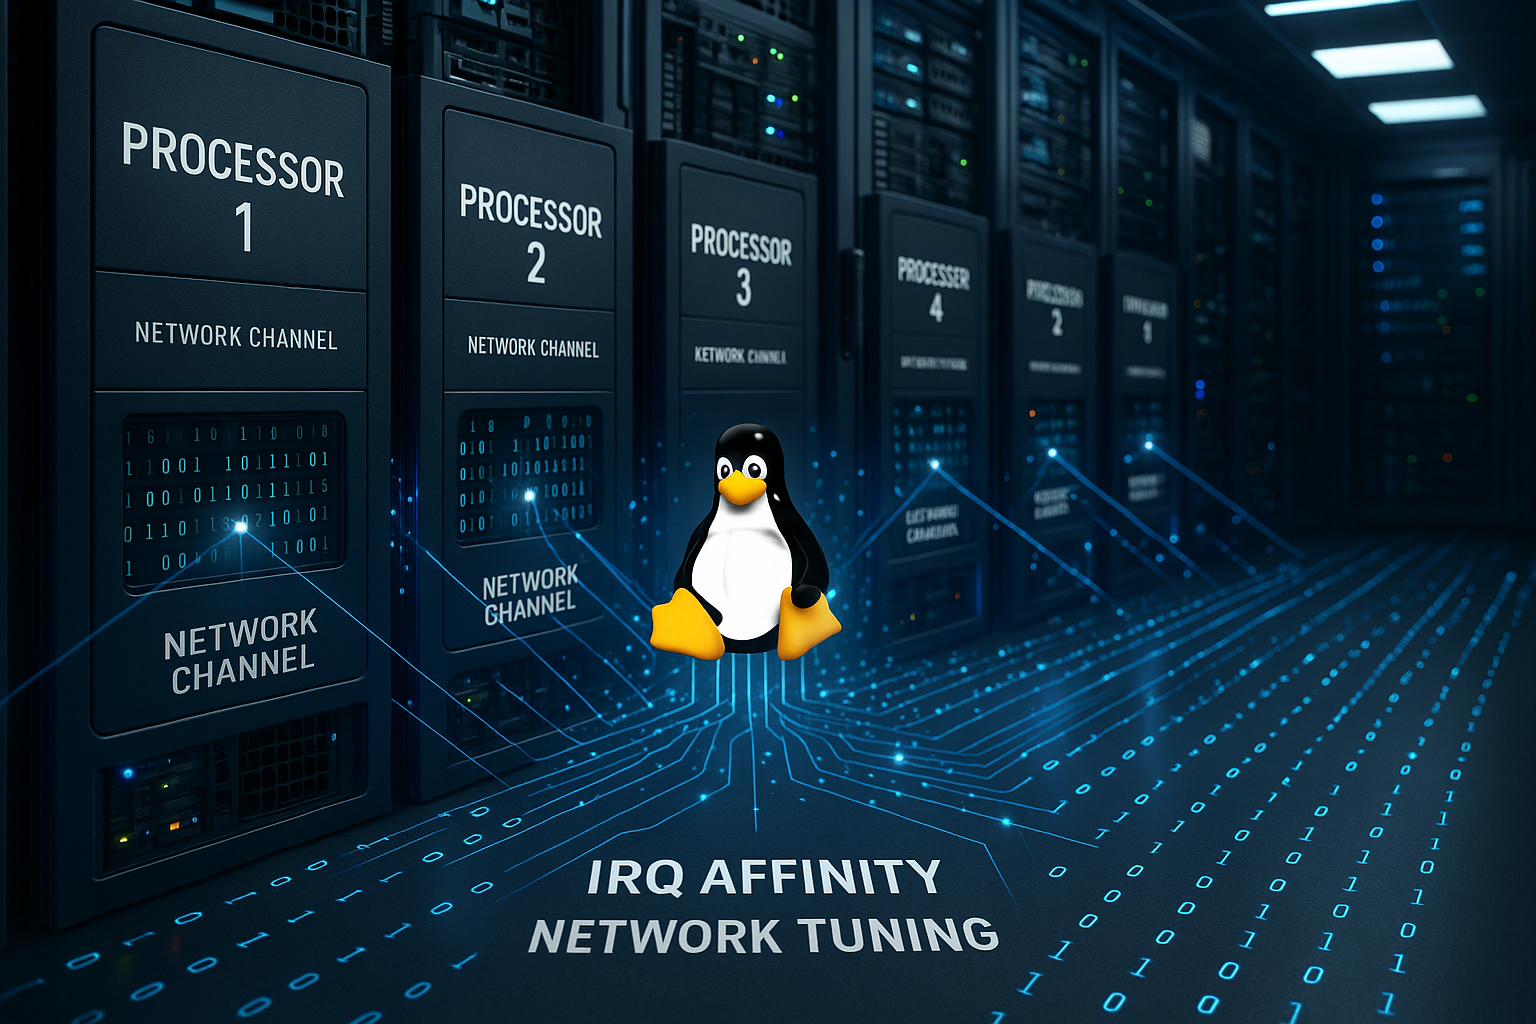
Indstilling af IRQ-affinitet: Sådan knytter jeg køer til kerner
Når jeg har identificeret NIC’ens kø-IRQ’er, fordeler jeg dem på dedikerede Kerner som 1, 2 og 3, for at skalere parallel behandling korrekt. På den måde forbliver hver RX/TX-kø ved sin kerne, hvilket forhindrer krydskommunikation og sikrer, at SoftIRQ-arbejdet forbliver konsistent. Under finjusteringen sammenligner jeg gennemstrømning og latenstid, indtil fordelingen fungerer pålideligt. For en mere dybdegående introduktion hjælper en kort Praktisk vejledning med variationer afhængigt af adapteren. Jeg kører bevidst kommandoerne i vedligeholdelsesvinduer og sikrer dem via et opstartsskript.
# Eksempel: Bind tre kø-IRQ’er til CPU1–3
echo 2 > /proc/irq/181/smp_affinity   # CPU1 (0x2)
echo 4 > /proc/irq/182/smp_affinity   # CPU2 (0x4)
echo 8 > /proc/irq/183/smp_affinity   # CPU3 (0x8)
Proces-pinning: Placering af tjenester på de samme kerner
Jeg knytter applikations-workere til dem CPU'er, som behandler de tilhørende IRQ’er, så dataveje forbliver korte. Under systemd bruger jeg CPUAffinity=1 2 3 eller start én gang med taskset -c 1-3. For multi-worker-servere tildeler jeg faste antal kerner pr. worker-gruppe, så der ikke opstår konkurrence. Denne tilknytning medfører konstant lavere Forsinkelser, fordi CPU-cacherne forbliver optimalt fyldt. Efter ændringer overvåger jeg tråde, sockets og SoftIRQ’er med htop, ss og perf.
Netværksoptimering: Sammenkobling af RSS, RPS/RFS og kerneparametre
Mange netværkskort distribuerer pakker via RSS om køer, som jeg derefter knytter til kerner ved hjælp af IRQ-affinitet. Jeg opsummerer detaljer og funktionsprincipper under Receive Side Scaling kompakt sammen. Derudover styrer jeg RPS/RFS på en sådan måde, at SoftIRQ’er ikke modarbejder den faste pinning-logik. Samtidig justerer jeg buffere via net.core.rmem_max og net.core.wmem_max og kontroller TCP-indstillinger som f.eks. tcp_timestamps. Disse komponenter bidrager til det samme mål: lav latenstid ved høj Bithastighed.
Korrekt fortolkning af MSI-X og kø-layout
Moderne NIC’er bruger MSI-X og opretter egne IRQ’er for hver RX/TX-kø. Jeg tjekker først, hvor mange køer og kanaler driveren aktuelt har aktiveret, og tilpasser dette til kernebudgettet for den relevante NUMA-node. På den måde undgår jeg, at for mange køer presser sig ind på for få kerner, eller omvendt, at kapacitet går til spilde.
Kontroller og juster antallet af køer og kanaler for #
ethtool -l ens192 # aktuelle grænser (RX/TX/combined)
ethtool -L ens192 combined 4  # f.eks. aktivere 4 køer

# Gennemgå RSS-indirektion og hash-indstilling
ethtool -x ens192 # Vis indirektionstabel og hash-nøgle
Mange drivere navngiver IRQ’er på en beskrivende måde (f.eks. ens192-TxRx-0). Jeg sørger for, at Indirection-tabellen er i overensstemmelse med Core-tildelingen, så flows konsekvent havner i „deres“ kø. Hvis hardwarefordelingen afviger, opstår der unødvendige flytninger af SoftIRQ’erne.
Korrekt anvendelse af RPS/RFS og XPS
RPS/RFS kan fordele pakker programmatisk på tværs af kerner – det er godt for netkort uden mange køer, men kontraproduktivt, hvis jeg allerede foretager præcis tilknytning via RSS og IRQ-affinitet. Derfor træffer jeg et bevidst valg: Enten hård tilknytning via RSS+IRQ-affinitet og RPS fra, eller få hardwarekøer og RPS målrettet mod. Derudover konfigurerer jeg XPS til TX-retningen, så udgående pakker sendes fra de „rigtige“ kerner.
IF=ens192

# Deaktiver RPS fuldstændigt (ved korrekt IRQ-pinning via RSS)
for q in /sys/class/net/$IF/queues/rx-*/rps_cpus; do echo 0 > "$q"; done
echo 0 > /proc/sys/net/core/rps_sock_flow_entries

# Alternativ: Aktivere RPS målrettet (eksempel: CPU'er 1-3)
for q in /sys/class/net/$IF/queues/rx-*/rps_cpus; do echo 0-0,0-0,0-0,0-0 > /dev/null; done
# Bedre: Brug en syntaks, der ligner smp_affinity_list:
for q in /sys/class/net/$IF/queues/rx-*/rps_cpus; do echo 1-3 > "$q"; done
echo 32768 > /proc/sys/net/core/rps_sock_flow_entries
echo 32768 > /proc/sys/net/ipv4/tcp_rfs_sock_flow_entries

Indstil # XPS i overensstemmelse med de valgte worker-CPU'er (TX-stier)
for q in /sys/class/net/$IF/queues/tx-*; do echo 1-3 > "$q"/xps_cpus; done
Det vigtigste er sammenhængen: RX-IRQ-kernen, ksoftirqd-belastningen og arbejdstråden bør køre på samme kerne (eller kernepar). På den måde undgår man mange cross-core-bounce-effekter.
Tage højde for SMT/Hyper-Threading og kernepar
På systemer med SMT giver det ofte mening at reservere en fysisk kerne til en RX-IRQ og placere den tilhørende worker på Søskende-tråd at sammenkoble – eller bevidst adskille, hvis arbejdsbyrden er beregningsintensiv. Jeg udleder trådparrene ud fra topologien og træffer derefter en klar beslutning i stedet for en tilfældig fordeling.
Find #-søskendepar
for c in /sys/devices/system/cpu/cpu*/topology/thread_siblings_list; do
  echo "$(basename "$(dirname "$c")") : $(cat "$c")"
done
Hvis jeg fordeler RX-IRQ og user-space-workere på den samme fysiske kerne (forskellige SMT-tråde), opnås der god L1/L2-lokalitet, men der kan opstå flaskehalse ved CPU-bundne arbejdsbelastninger. Alternativt fordeler jeg IRQ på kerne X og worker på kerne Y på samme NUMA-node for at opnå ægte parallelitet. Jeg tester begge varianter ved hjælp af A/B-test og vælger den, der giver den mest stabile latenstid.
Brug smp_affinity_list, effective_affinity og Defaults
Udover Hex-masker skriver jeg gerne i smp_affinity_list, da det dermed omfatter områder som 1-3,6,8-9 kan sættes komfortabelt. For at kontrollere det tjekker jeg effective_affinity hhv. effective_affinity_list, fordi kernen eller driverne kan udelukke visse CPU'er (f.eks. offline-kerner eller „managed interrupts“).
# Menneskeligt læsbar tildeling
echo 1-3 > /proc/irq/181/smp_affinity_list

# Bekræft effektiv tilknytning
cat /proc/irq/181/effective_affinity_list
For at undgå, at nye IRQ’er – eller IRQ’er, der er tilføjet efter en genindlæsning af drivere – igen bliver spredt vidt ud, indstiller jeg om nødvendigt /proc/irq/default_smp_affinity til en fornuftig basisværdi (f.eks. alle kerner i den relevante NUMA-node, dog uden CPU0). Derefter tilsidesætter jeg målrettet enkelte kritiske IRQ'er.
Sikre vedvarende indstillinger på tværs af genstarter og genindlæsninger
Affinity-indstillinger er flygtige. Jeg sikkerhedskopierer dem via en systemd-oneshot-enhed, der kører efter målet for netværksinitialisering, eller via et lille script, der dynamisk identificerer og kortlægger IRQ-lister. På den måde bevares tildelingerne også efter kerneopdateringer og link-resets.
# /usr/local/sbin/net-irq-pin.sh (eksempel)
#!/bin/bash
set -euo pipefail
IF=${1:-ens192}
CPUS="1-3"   #-mål-CPU'er (vælg NUMA-konsistente)
for irq in $(grep -i "$IF" /proc/interrupts | awk '{print $1}' | tr -d ':'); do
  echo "$CPUS" > /proc/irq/$irq/smp_affinity_list || true
done

# systemd-enhed (skitseret)
# /etc/systemd/system/net-irq-pin.service
[Unit]
Description=Fastlåse NIC-IRQ'er
After=network-online.target

[Service]
Type=oneshot
ExecStart=/usr/local/sbin/net-irq-pin.sh ens192

[Install]
WantedBy=multi-user.target
Vigtigt: Jeg kører scriptet igen, hvis driveren genindlæses, eller hvis antallet af køer ændres, da IRQ-numrene i så fald flyttes.
Virtualisering og containere: At betragte vært og gæst som en helhed
I KVM-miljøer monterer jeg på Vært de fysiske NIC-IRQ’er til kerner i den relevante NUMA-node. Samtidig forbinder jeg vhost-net‑Threads og QEMU-processen (eller enkelte vCPU’er) ligeledes der, så datavejene på værtsiden forbliver korte. I Gæst Jeg tilpasser vNIC’ernes IRQ-affinitet til de vCPU’er, som jeg på værtsiden har knyttet til fysiske kerner. Container-workloads (cgroups/cpuset) drager fordel af, at de tilladte CPU'er i containerne overlapper med værtens RX/TX-kerner – ellers opstår der unødvendige fjernadgange.
Uddyb analysen: SoftIRQ’er, NAPI og detektering af overbelastning
Ud over /proc/afbrydelser kigger jeg ind i /proc/softirqs, for at se, om der er meget arbejde i forbindelse med ksoftirqd i stedet for at blive udført direkte i IRQ-handleren – et tegn på vedvarende høj belastning. Med napi_defer_hard_irqs (Afhængigt af kernen) og ved hjælp af korrekte kø-tildelinger justerer jeg, hvor aggressivt NAPI batcher. ethtool -S giver mig statistikker for hver kø vedrørende drops, »busy«-tilstande og pakkehastigheder; her kan jeg identificere ubalancerede køer og justere affinitet eller RSS-indirektion i overensstemmelse hermed.
# Hurtigt overblik over SoftIRQ-fordelingen
cat /proc/softirqs | egrep 'NET_RX|NET_TX'

# Vis driver-/køstatistikker
ethtool -S ens192 | egrep -i 'rx|tx|drop|busy'
Praksis: Kortlægning af 4 køer på en node
En typisk opsætning, som jeg ofte bruger: NIC på NUMA-node 0 med 4 RSS-køer. Jeg undgår CPU0 og knytter køerne til CPU1–4. De tilhørende web- eller proxy-workere placerer jeg ligeledes på 1–4, XPS tildeler jeg på samme måde, mens RPS forbliver slået fra. På den måde opnår jeg korte, konsistente stier i begge retninger.
IF=ens192
QUEUES=(181 182 183 184)   # Eksempel-IRQ'er (skal fastlægges på forhånd)
CPUS="1-4"

Indstil # IRQ-affinitet og XPS
for i in ${!QUEUES[@]}; do
  echo "$CPUS" > /proc/irq/${QUEUES[$i]}/smp_affinity_list
done
for q in /sys/class/net/$IF/queues/tx-*; do echo "$CPUS" > "$q"/xps_cpus; done

# Fastlås worker (systemd eller taskset)
# systemd: CPUAffinity=1 2 3 4
# Engangsopgave: taskset -c 1-4
Hvis belastningen fortsætter med at stige, øger jeg antallet af køer (ethtool -L) op til det fornuftige antal kerner i noden og fordel dem fast efter et genkendeligt mønster (f.eks. kø-ID → kerne-ID), så flows ikke „vandre“ over tid.
Bedste praksis for multi-core-værter
Jeg aflaster CPU0, da der ofte kører timere og kerneinterne tjenester, som kan forårsage forstyrrelser under belastning. Derfor foretrækker jeg at placere kritiske IRQ’er på andre kerner og lader CPU0 kun håndtere få, ikke-kritiske kilder. På NUMA-systemer er jeg konsekvent og holder adaptere, IRQ’er, processer og hukommelsesadgange på samme Knudepunkt. I miljøer med stor belastning adskiller jeg I/O-kerner fra applikationskerner og isolerer dem om nødvendigt. Jeg overvåger alle ændringer løbende og justerer tildelingerne iterativt.
En målbar fremgangsmåde: analyse, scripts og backup-plan
Inden jeg foretager ændringer, dokumenterer jeg den nuværende tilstand med mpstat, htop, /proc/afbrydelser og latensmålinger med iperf3. Jeg opsætter scripts, der automatisk anvender affinity-indstillingerne efter en genstart eller en genindlæsning af drivere. Til rollbacks har jeg neutrale masker klar, så jeg straks kan rulle tilbage, hvis der opstår fejl. I staging-miljøet tester jeg belastningsprofiler, der ligger så tæt på min produktion som muligt, og gentager Måling efter hver justering. Først derefter aktiverer jeg profilen permanent på målværten.
Undgå almindelige snublesten på en ren måde
Masker, der er for brede, fordeler arbejdet på for mange CPU'er og bremser cacherne, mens for snævre masker tilstopper køerne. Glemte NUMA-særlige forhold medfører adgang til fjernhukommelse, hvilket får responstiderne til at svinge. Hård pinning kolliderer lejlighedsvis med RPS/RFS-indstillinger, derfor tjekker jeg SoftIRQ-belastningsfordelingen eksplicit. Efter kerneopdateringer eller driverudskiftninger validerer jeg alle IRQ-numre på ny, da tildelingerne kan ændre sig. Med forsigtige skridt og klar Dokumentarfilm forbliver jeg handlingsdygtig.
Kort opsummeret
Målrettet IRQ-pinning knytter netværksinterrupts til et begrænset antal passende Kerner, reducerer overhead og stabiliserer responstiderne. I den forbindelse tilpasser jeg IRQ- og CPU-affinitet, tager højde for NUMA og kontrollerer effekten ved hjælp af måleserier. Hvor automatikken er tilstrækkelig, lader jeg irqbalance arbejde, mens jeg dirigerer kritiske køer til faste kerner. Med RSS, RPS/RFS og tilpassede kerneparametre udfolder tuningen sin fulde Effekt. Hvis man følger disse trin nøje, kan man opnå en mærkbar forbedring af netværksydelsen på multi-core Linux-servere.


