
Jeg sammenligner de vigtigste metoder til MariaDB-flush og viser, hvordan jeg indstiller innodb flush, så skrivelatensen reduceres, og dataene forbliver sikre. Fokus ligger på indstillingerne for `innodb_flush_method`, holdbarhedsregulatoren `innodb_flush_log_at_trx_commit` samt fornuftige værdier for `Dirty Pages` og I/O-kapacitet på HDD, SSD og NVMe.
Centrale punkter
- innodb_flush_method bestemmer, hvordan InnoDB interagerer med operativsystemets cache og undgår dobbeltcaching.
- innodb_flush_log_at_trx_commit bestemmer holdbarhed kontra ventetid pr. commit.
- Beskidte sider og I/O-kapaciteten udjævner skrivehastighederne og forhindrer flush-storme.
- Flush-naboer skelner mellem strategier, der er optimeret til HDD, og strategier, der er optimeret til SSD/NVMe.
- Cloud-opsætninger kræver O_DIRECT, en passende IOPS-grænse og pålidelig overvågning.
Hvad betyder »innodb_flush_method« helt konkret?
Jeg vælger Flush-metoden afhænger af, hvordan InnoDB samarbejder med operativsystemets cache. Med fsync Dataene havner først i OS-cachen og skrives derefter permanent via fsync; dette kan føre til dobbeltcaching. Hvis jeg indstiller O_DIRECT, omgår InnoDB i vid udstrækning sidecachen, hvilket sparer RAM og næsten altid er en fordel på SSD/NVMe. O_DSYNC bruger write-through og reducerer buffering, hvilket kan være nyttigt i bestemte kombinationer. O_DIRECT_NO_FSYNC bygger videre på O_DIRECT og tilpasser synkroniseringsadfærden, hvilket er et stærkt valg på pålidelig hardware med egen beskyttelsesmekanisme.
Typiske værdier og versioner
Fra og med MariaDB 10.6 er O_DIRECT ofte standardindstillingen, fordi det forhindrer dobbeltcaching. I ældre versioner er det fsync, hvilket stadig kan være acceptabelt for HDD-konfigurationer. Fra version 11.0 styrer yderligere variabler som innodb_data_file_buffering og innodb_log_file_buffering detaljerne i bufferingen. I praksis er innodb_flush_method stadig den centrale parameter, som jeg tjekker først. Derefter finjusterer jeg de detaljerede parametre, indtil latenstiderne falder, og gennemstrømningen forbliver konstant.
Målrettet brug af innodb_flush_log_at_trx_commit
Jeg overvejer Holdbarhed og latenstid adskilt, da innodb_flush_log_at_trx_commit bestemmer begge dele. Værdien 1 skriver og udfører fsync ved hver commit, hvilket giver maksimal sikkerhed, men bremser langsomme diske kraftigt. Værdien 2 skriver til operativsystemets cache ved hver commit og udfører fsync cirka én gang pr. sekund; dette reducerer latenstiden, men medfører en risiko for datatab på op til et sekund i tilfælde af strømsvigt. Værdien 0 udskyder log-skrivninger fuldstændigt til hvert sekund og leverer den højeste skriveydelse med den største risiko. Hvis man desuden tager højde for binlog-strategien, kan man klogt tilpasse commit-latenser til replikeringskravene; jeg forklarer detaljerne om samspillet her: Binære logfiler.
Styring af side-flushing og dirty pages
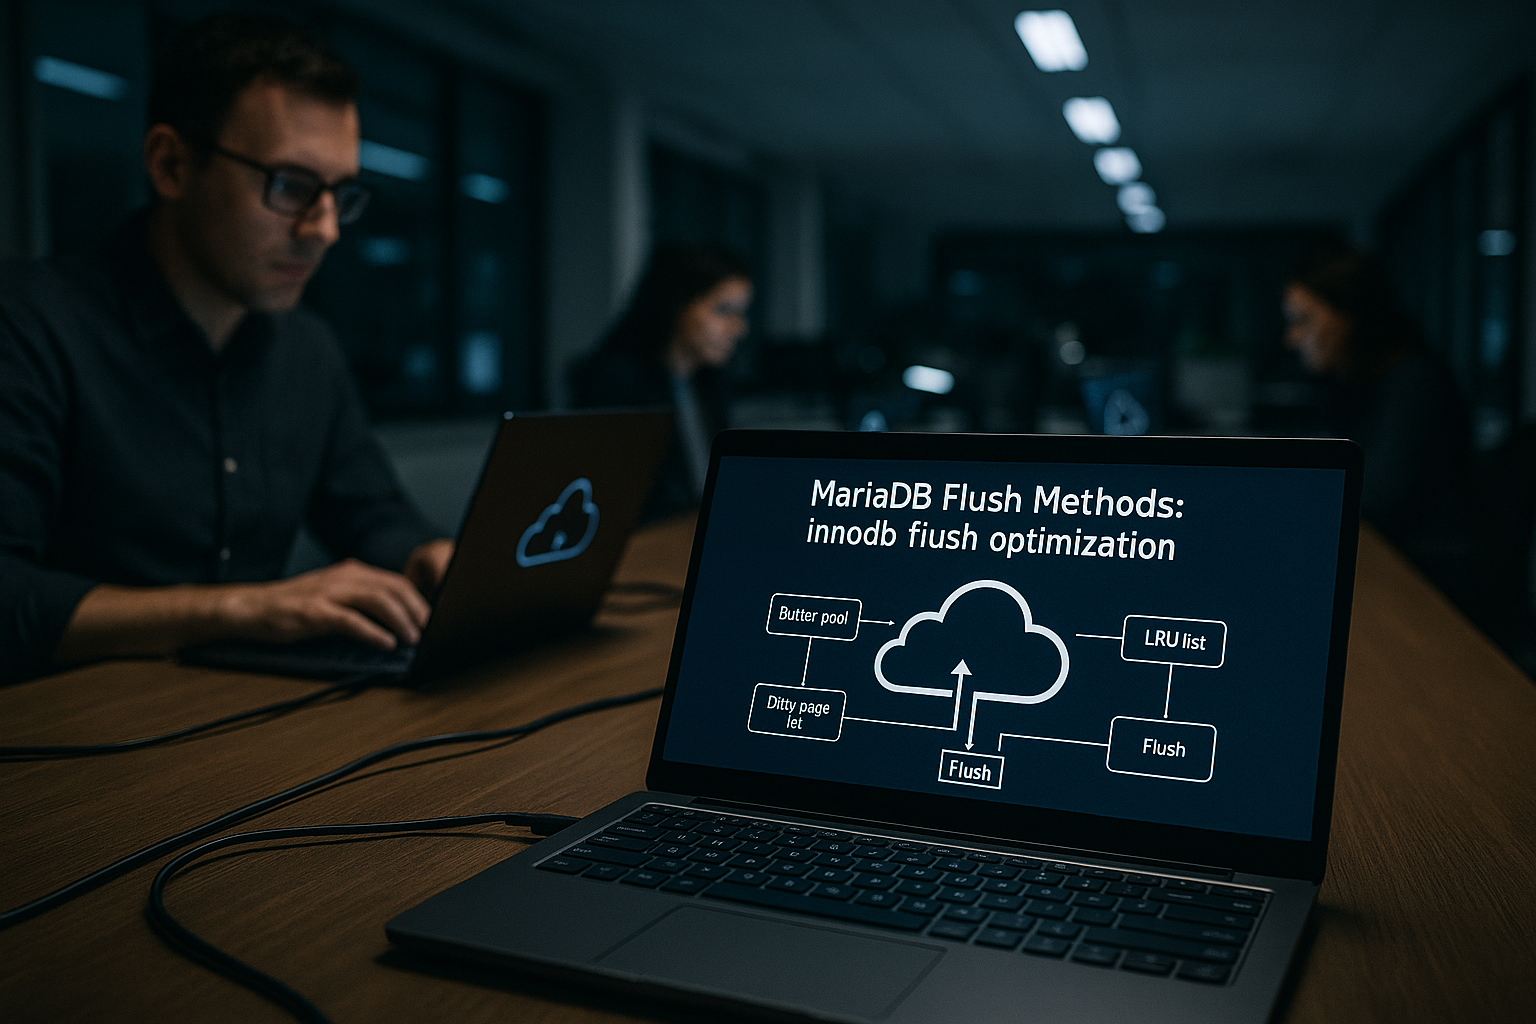
Jeg mener, at andelen af Beskidte sider således at skrivehastighederne forbliver konstante. Til dette formål indstiller jeg innodb_max_dirty_pages_pct til et moderat niveau, så der ikke opstår pludselige flush-spidsbelastninger. Værdierne for innodb_io_capacity og innodb_io_capacity_max tilpasser jeg til lagerets reelle IOPS: lavt for HDD, højere for SSD/NVMe. En velkonfigureret page-cleaner-tråd skriver tilbage i tide set ud fra et LRU-perspektiv, inden siderne fortrænges. Jeg beskriver mere om finjustering af tråde og nyttige målinger her: Page-Cleaner-tråde.
Flush-Neighbors: HDD kontra SSD/NVMe
Med innodb_flush_neighbors Jeg bruger HDD-venlige skrivemønstre eller slår dem fra. På HDD’er øger samtidig skrivning af tilstødende sider effektiviteten, fordi læseren ikke behøver at springe så meget rundt. På SSD/NVMe er placeringen på mediet stort set irrelevant, da skrivning af tilstødende sider der skaber unødvendige skrivninger. For HDD indstiller jeg normalt værdien 1, for SSD/NVMe værdien 0. På den måde reducerer jeg unødvendige skrivninger og skåner levetiden på hurtige drev.
Forstå og begrænse fsync-omkostningerne
Jeg måler på fsync-Latens, fordi hver millisekund forsinker commit-operationer. Skriveintensive arbejdsbelastninger bruger ellers en stor del af tiden på at vente på bekræftelse fra lagringsmediet. Med innodb_flush_log_at_trx_commit=2 eller 0 reducerer jeg antallet af ressourcekrævende synkroniseringer markant. O_DIRECT eller O_DIRECT_NO_FSYNC hjælper med at undgå dobbeltcaching og forenkle I/O-stier. På langsom hardware opnår jeg ofte mærkbare forbedringer, når jeg ser på synkroniseringsfrekvens, flush-metode og andel af beskidte sider samlet.
Anbefalede startværdier efter lagringsmedie
Jeg begynder med meningsfulde Baseline-værdier og justerer dem derefter ud fra måleværdier. Tabellen giver retningslinjer for typiske opsætninger og arbejdsbelastninger. Det afgørende er reelle IOPS, latenstider og andelen af skrivetransaktioner. Efter den første kørsel kontrollerer jeg andelen af beskidte sider, commit-latenstid og antallet af fsync-kald. Derefter finjusterer jeg trin for trin, indtil profilen er ren og stabil.
| Medium | innodb_flush_method | innodb_flush_log_at_trx_commit | innodb_io_kapacitet | innodb_flush_neighbors | Noter |
|---|---|---|---|---|---|
| HDD | fsync eller O_DIRECT | 1 (kritisk) / 2 (balance) | 200–400 | 1 | Større forsinkelse pr. Forpligtelse, det er vigtigt at skylle løbende |
| SSD | O_DIRECT | 1 (kritisk) / 2 (balance) | 1000–2000 | 0 | Undgå dobbeltcaching, hold antallet af »dirty pages« på et moderat niveau |
| NVMe | O_DIRECT eller O_DIRECT_NO_FSYNC | 1 (kritisk) / 2 (balance) / 0 (særligt tilfælde) | 2000–8000+ | 0 | Meget lav Forsinkelse, Vælg synkroniseringsfrekvensen omhyggeligt |
I den forbindelse tager jeg højde for InnoDB Doublewrite-buffer, som mindsker datakorruption ved nedbrud, men medfører yderligere skrivninger; her giver jeg et kort overblik over baggrunden og indstillingsmulighederne: Doublewrite-buffer. I skriveintensive miljøer foretager jeg målinger både med og uden doublewrite-effekter, inden jeg træffer beslutninger. I kritiske systemer prioriteres integritet frem for maksimal skrivehastighed. Test- eller analyseopsætninger må gerne være mere aggressive. Jeg underbygger altid mine beslutninger med reproducerbare benchmarks.
Cloud- og containermiljøer
Jeg undgår dobbelt Side-cache, fordi der er begrænset RAM; O_DIRECT passer derfor ofte godt. Jeg tilpasser innodb_io_capacity til volumenets IOPS-grænser, så jeg ikke udløser en begrænsning. Bufferpoolen skal passe til Cgroup-grænsen, ellers risikerer man OOM-kills. Persistente volumener er et must, da ephemeral storage ikke tilbyder varighed. I meget elastiske opsætninger begrænser jeg for mange samtidige forbindelser og bruger trådpuljen med omtanke.
Indstillinger for sikkerhedskopiering og tømning
Jeg tjekker, om backup-værktøjerne har deres egne Skylle-Brug indstillingerne. mariadb-backup kan indstille innodb_flush_method anderledes for at opnå et konsistent billede. Hvis backup- og serverparametrene ikke stemmer overens, opstår der unødvendige I/O-spidsbelastninger. Under planlagte sikkerhedskopieringer regulerer jeg I/O-kapaciteten forsigtigt, så læse-/skrivestier forbliver rene. Efter kørslen kontrollerer jeg latenstider og andelen af beskidte sider for at udelukke bivirkninger.
Trin-for-trin-tuning i praksis
Jeg begynder med en Inventar: Lagertype, reelle IOPS, ventetider og gennemstrømning. Derefter fastlægger jeg størrelsen på bufferpoolen, så den passer til den tilgængelige RAM eller Cgroup-grænsen. Til sidst vælger jeg flush-metoden (HDD: fsync/O_DIRECT; SSD/NVMe: O_DIRECT eller O_DIRECT_NO_FSYNC). Af hensyn til holdbarheden indstiller jeg innodb_flush_log_at_trx_commit til 1 for kritiske data eller til 2, hvis et sekunds tab er acceptabelt. Til sidst indstiller jeg innodb_io_capacity og innodb_max_dirty_pages_pct, så flushing foregår roligt og stabilt, og jeg kontrollerer målingerne regelmæssigt.
Korrekt dimensionering af redo-log-størrelse og checkpoints
Jeg undgår flush-toppe ved at Redo-logfiler dimensionere dem korrekt. For små logfiler tvinger InnoDB til hyppige checkpoints; det medfører backpressure og ustabile ventetider. Med større logfiler udjævner jeg checkpoint-forløbet, fordi der kan bufferes flere ændringsdata, før de er nødt til at flyttes over i datafilerne. Her tager jeg højde for to begrænsninger: for det første den tilgængelige I/O-kapacitet (en stor buffer beskytter ikke mod for langsomme diske), for det andet crash-recovery-tiden, som stiger med meget store redo-logs. I skriveintensive arbejdsbelastninger indstiller jeg logstørrelsen således, at typiske belastningsspidser absorberes inden for logbudgettet, uden at gendannelsestiden stiger urimeligt.
For at finjustere overvåger jeg målingerne for „checkpoint age“ og forholdet mellem log-skrivehastigheden og flush-hastigheden for datasiderne. Hvis checkpoints gentagne gange når den øvre grænse, skalerer jeg enten logstørrelsen eller øger forsigtigt I/O-kapaciteten for Page Cleaner. Målet er en jævn, kontinuerlig fremdrift i checkpoints uden tvungne handlinger.
Adaptiv skylning og tærskelværdier
InnoDB’s adaptive mekanismer hjælper med at udføre flushing af den aktuelle Skrivhastighed at justere. Jeg sørger for, at LWM-tærsklen (Low Watermark) for Dirty Pages ikke er for lav, så Page-Cleaner ikke hele tiden kører „på kanten“. Samtidig undgår jeg maksimumsværdier, der fører til for aggressive bulk-flushes. I praksis kontrollerer jeg, om forholdet mellem „nye dirty pages pr. sekund“ og „flush-IOPS“ forbliver stabilt på lang sigt. Hvis bufferpoolen konstant overskrider målet for dirty pages, øger jeg gradvist innodb_io_capacity eller reducerer målene for dirty pages.
På NVMe-konfigurationer kan jeg give Page-Cleaner mere spillerum, fordi enhederne opretholder korte ventetider selv under belastning. På HDD’er arbejder jeg med mere konservative tærskelværdier og begrænser store udsving for at undgå ventetidstop forårsaget af søgninger. Samspillet med innodb_flush_neighbors Det udnytter jeg målrettet: HDD drager fordel af den fysiske placering, mens flash ikke gør det.
Binlog og Group-Commit i samspil
Den, der anvender replikering, tager højde for dette Commit-protokol om redo-log og binær log. Jeg indstiller flush-frekvenserne, så group-commit træder i kraft: Mange små transaktioner skal flushes samlet i stedet for at synkronisere hver enkelt commit. Her passer innodb_flush_log_at_trx_commit=1 til maksimal holdbarhed eller 2 til lavere latenstid. Samtidig indstiller jeg binlog-synkroniseringsmekanismen, så den passer til målsystemet. En lav synkroniseringsfrekvens reducerer omkostningerne pr. commit, men kan medføre større tab af binlog ved nedbrud. I miljøer med høj skrivehastighed og en acceptabel forsinkelse mellem master og replika accepterer jeg en moderat afkobling af binlog-synkroniseringerne for at reducere latenstiderne. Den overordnede logik og afvejningerne beskriver jeg i indlægget om Binære logfiler og tilpasser dem derefter til den konkrete flush-profil.
Filsystem, skrivecache og beskyttelse mod strømsvigt
Jeg vurderer Hukommelses- og controller-egenskaber før tuningen. Enheder med Beskyttelse mod strømtab (PLP) kan sikkert benytte skrivecacher; uden PLP er der risiko for, at skrivninger, der er markeret som bekræftede, går tabt ved strømsvigt. I sådanne tilfælde vælger jeg en mere konservativ tilgang: fsync-stier er stadig obligatoriske, og jeg bruger kun O_DIRECT_NO_FSYNC på hardware med pålidelig beskyttelse. På Linux-filsystemer som ext4 eller XFS er disse beskyttelsesmekanismer som standard aktive; jeg deaktiverer dem ikke letfærdigt, men tilpasser optimeringen ud fra de eksisterende garantier. På ZFS tager jeg desuden højde for dets eget Intent Log og caching-strategier; afhængigt af opsætningen kan det betale sig at anvende en separat tilpasset strategi, der ligeledes minimerer dobbeltcaching.
For at sikre ensartet ydeevne tjekker jeg desuden alignments (f.eks. 4K-sider på SSD) og indstilling af kødybden. Korte, deterministiske ventetider er ofte vigtigere for commit-stier end maksimale IOPS i syntetiske benchmarks. Derfor tester jeg med realistiske blokke og forskellige grader af samtidighed i stedet for kun med spidsbelastninger.
Målemetodik: Måleparametre, status og diagnose
Jeg styrer indstillingen via konkrete måleværdier i stedet for følelse. Blandt mine standardindikatorer er:
- Commit-latens (p50/p95/p99) under spidsbelastninger
- fsync-latens og -hastighed for log- og datafiler
- Andelen af »Dirty Pages« over tid og dens varians
- Fremskridt ved kontrolpunkter og forholdet mellem log-skrivningshastighed og flush-hastighed
- Page-Cleaner-backlog (er der konstant udestående flushes?)
Til dette formål bruger jeg statusudskrifterne fra InnoDB og sammenholder dem med OS-metrikker (iostat, vmstat). Jeg holder især øje med disk-latensen i millisekunder, fordelingen mellem læsninger og skrivninger samt andelen af synkrone operationer. For at sikre reproducerbare tests ændrer jeg målrettet kun én parameter pr. trin og registrerer resultatet over længere tidsintervaller, så outliers ikke dominerer.
Almindelige anti-mønstre og modforanstaltninger
- For små redo-logfiler: medfører hyppige checkpoints. Løsning: Forøg logfilstørrelsen og tilpas I/O-kapaciteten til flushing.
- Andelen af »dirty pages« er vedvarende for høj: Page-Cleaner er overbelastet, og der er risiko for flush-storme. Modforanstaltning: Sænk innodb_max_dirty_pages_pct og øg io_capacity.
- O_DIRECT uden overvågning: Undgår ganske vist dobbeltcaching, men kan føre til bursts, hvis I/O-kapaciteten er forkert indstillet. Modforanstaltning: Nøje overvågning og tilpasning af kapacitetsværdierne til de faktiske IOPS.
- Uhensigtsmæssige »flush-neighbors« på SSD/NVMe: skaber unødvendigt arbejde uden nogen fordel. Løsning: Indstil innodb_flush_neighbors=0.
- Commit-synkroniseringer på langsomme medier: Hver transaktion medfører en fsync-omkostning. Modforanstaltning: Fremme group-commit, eventuelt ved at indstille innodb_flush_log_at_trx_commit=2 (efter en risikovurdering).
- Container uden RAM-buffer: Bufferpoolen er for stor, der er risiko for OOM. Løsning: Tilpas bufferpoolen nøje efter Cgroup-grænserne og hold øje med Pressure.
Medregne nedluknings- og gendannelsesforløb
Jeg planlægger, hvordan indstillingerne påvirker Nedlukning og Gendannelse efter nedbrud indvirke. En hurtig og korrekt nedlukning reducerer gendannelsestiderne, fordi der skal anvendes færre redo-logs. Meget store redo-logs fremmer stabile checkpoints, men forlænger gendannelsen i tilfælde af fejl. For produktive systemer vælger jeg en balance, så jeg på den ene side ikke skaber flush-storme i den daglige drift, og på den anden side ikke skal acceptere en alt for lang genopretning i værste fald. Vedligeholdelsesvinduer og sikkerhedskopier tager jeg højde for fra starten.
Praktiske løsninger til typiske arbejdsbelastninger
- OLTP med mange små commits på SSD/NVMe: O_DIRECT, innodb_flush_log_at_trx_commit=1 eller 2 afhængigt af holdbarheden, innodb_io_capacity helst højt, Dirty-Pages moderat, Flush-Neighbors=0. Brug aktivt Binlog-Group-Commit.
- Batch-import med stor skrivebelastning: Øg midlertidigt målet for »dirty pages« en smule, forøg I/O-kapaciteten og sæt indstillingen tilbage efter afslutning. Hvis holdbarheden er acceptabel, kan du midlertidigt indstille innodb_flush_log_at_trx_commit=2.
- HDD-baserede ældre systemer: konservativ I/O-kapacitet, Flush-Neighbors=1, innodb_flush_method=fsync eller O_DIRECT afhængigt af RAM-belastningen. Der skal lægges særlig vægt på kontinuerlig flushing for at undgå søgestorm.
- Cloud-volumener med IOPS-budget: Indstil `innodb_io_capacity` så den nøje overholder den garanterede grænse, undgå bursts, og brug `O_DIRECT` for at spare på RAM. Ved kreditsystemer (burst-I/O) bruger jeg pacing, så budgettet ikke opbruges på én gang.
Tjekliste til fejlfinding
- Lange p95-commit-forsinkelser? Kontroller fsync-varigheden, aktiver Group Commit, reducer om nødvendigt flush-frekvensen (efter en risikovurdering).
- Stor variation i andelen af »Dirty Pages«? Finjuster io_capacity/io_capacity_max, og kontroller de adaptive flushing-tærskler.
- Pludselige latensspidser ved sikkerhedskopiering? Synkroniser parametrene for sikkerhedskopieringsværktøjet og serverværdierne, og juster I/O-begrænsningen midlertidigt.
- Hænger Replica bagefter? Vurder Binlog-flush-strategien, synkroniseringsfrekvenserne og netværksforsinkelsen samlet; for aggressive synkroniseringer bremser masteren.
- RAM-belastning efter overgang til O_DIRECT? Juster balancen mellem bufferpoolen og OS-cachen på ny; O_DIRECT reducerer OS-cachen, men kan påvirke applikationens sidecache.
Kort resumé
Jeg organiserer Flush-strategi altid afhænger af hardwaren og holdbarhedsmålene. O_DIRECT forhindrer dobbeltcaching og giver som regel de bedste resultater på SSD/NVMe. Indstillingen innodb_flush_log_at_trx_commit bestemmer hastigheden pr. commit og risikoen ved strømsvigt. Omhyggeligt valgte værdier for Dirty Pages, I/O-kapacitet og Flush-Neighbors holder skrivehastighederne jævne. Hvis man derudover måler fsync-omkostninger og overholder cloud-begrænsninger, kan man pålideligt få MariaDB op på fuld hastighed uden at gå på kompromis med sikkerheden.


