 Videre til indhold

Jeg viser, hvordan jeg Redis-offset læser og analyserer målrettet og sikrer høj datakvalitetKonsistens udnytter. På den måde opdager jeg replikeringshuller tidligt, vurderer failover-risici og sikrer, at produktive klynger forbliver pålideligt synkroniserede.
Centrale punkter
De følgende hovedpunkter giver en målrettet introduktion til emnet, terminologien og den praktiske gennemførelse.
- Offset måler replikeringsstrømmens fremskridt byte for byte.
- Lag er forskellen mellem master_repl_offset og slave_repl_offset.
- ID+forskydning angiver en præcis dataversion til delvise synkroniseringer.
- Efterslæb beskytter mod fuld synkronisering ved korte forbindelsesafbrydelser.
- Overvågning styrer alarmering og failover ved hjælp af INFO/cluster-metrikker.
Hvad betyder Redis-replikationsforskydningen?
Replikationsforskydningen er en løbende 64-bit-tæller, der for hver overført Byte-strøm mellem primærserveren og replikaen. Her kan jeg se, hvor langt replikeringen er kommet, og om en replika stadig har arbejde foran sig. Den master_repl_offset På primærserveren stiger tallet for hver ny byte, der genereres, mens replikaen øger sin egen tæller, så snart den har udført kommandoer. Forskelle resulterer i en forsinkelse målt i bytes og angiver, om replikaen halter bagefter. Denne enkle, men effektive semantik gør offset til det centrale tal for synkronisering, fejlanalyse og præcise failover-beslutninger.
Udlæsning af offsets: Sådan bruger du INFO-replikering korrekt
Jeg indleder næsten altid diagnosen med INFO replikering, fordi kommandoen leverer de relevante felter i en kompakt form. På primærserveren tjekker jeg master_repl_offset samt status for tilknyttede replikaer, herunder deres offsets. På en replika kontrollerer jeg desuden master_link_status og synkroniseringsstatus for at identificere igangværende fuldstændige synkroniseringer eller delvise synkroniseringer. Til en mere dybdegående analyse benytter jeg strukturerede udskrifter og korrelerer offsets med CPU-, I/O- og netværksværdier. Denne vejledning giver mig en grundig introduktion til kommandoen: Redis INFO til overvågning.
Replikations-ID + offset: entydig dataversion
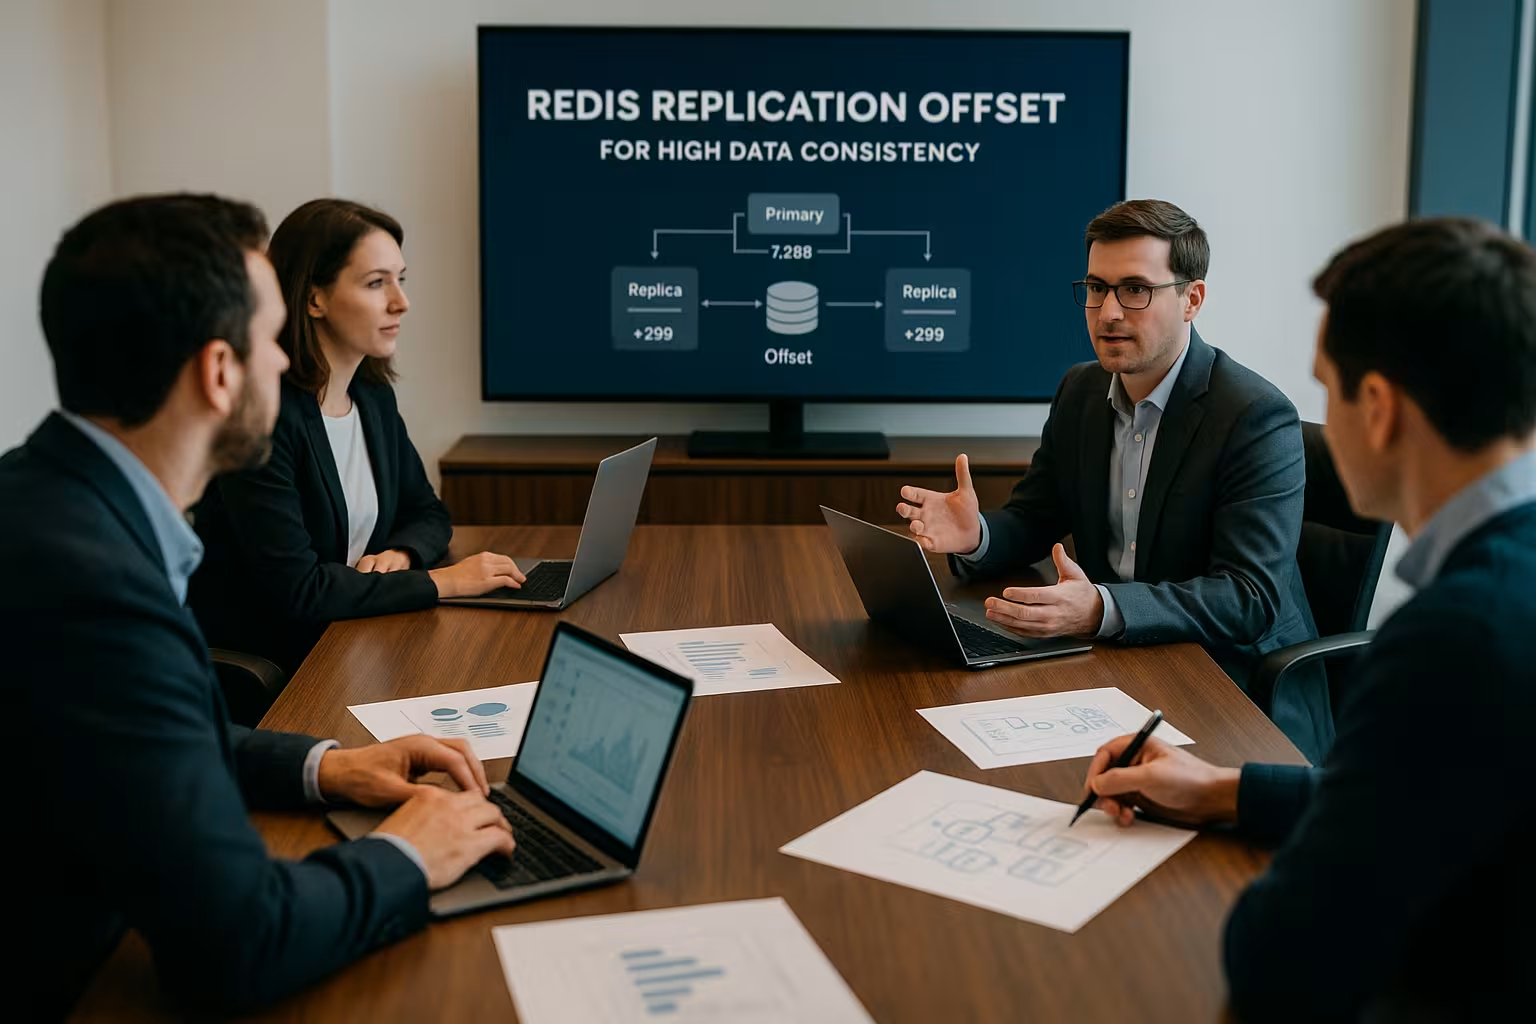
For at sikre en entydig version bruger jeg kombinationen af Replikation ID og offset. ID’et angiver en historik, mens offset’et angiver en position inden for denne historik. Hvis ID’et og offset’et stemmer overens på to instanser, går jeg ud fra, at begge har samme datatilstand. Denne kombination muliggør delvis resynkronisering, fordi en replika præcist kan fortælle primærinstansen, hvor den sidst stod. På den måde kan jeg også se, om en failover lykkes uden dataafvigelser, eller om en fuldstændig synkronisering er nødvendig.
Dimensionering af replikerings-backlog og -gap
Primary holder en Efterslæb som en ringbuffer, der gemmer de seneste skrivninger og muliggør delvis synkronisering. Hvis bufferen er for lille, løber bytes hurtigere ud ved belastningstoppe, og en replika, der kortvarigt har været afbrudt, går glip af den delvise synkronisering. Jeg dimensionerer størrelsen afhængigt af skriveprofilen og RPO-målene, så korte afbrydelser ikke udløser dyre fuldstændige synkroniseringer. Som en grov retningslinje vælger jeg en størrelse, der mindst kan buffe den forventede datamængde i løbet af flere sekunder til minutter. På den måde mindsker jeg forskellen mellem primærserveren og replikaen og holder genopkoblingen strømlinet.
Præcis bestemmelse af størrelsen på ordrebogen
I praksis beregner jeg ikke blot størrelsen af backloggen ud fra en fornemmelse, men på baggrund af den faktisk observerede bytstrøm:
- Jeg bestemmer Gennemstrømning i byte/s, ved at måle stigningen i master_repl_offset med bestemte intervaller (f.eks. 10–60 s) og notere de højeste værdier.
- Jeg definerer en tilladt afbrydelsestid (f.eks. vedligeholdelsesvinduer, netværksafbrydelser) i sekunder.
- Jeg ganger spidsbytes/s med afbrydelsens varighed og tilføjer en Sikkerhedsfaktor (1,5–3×) til.
Eksempel: 80 MB/s spidsbelastning, 20 sekunders forventet afbrydelse, faktor 2 → 80×20×2 = 3.200 MB backlog. På den måde sikrer jeg, at der lykkes en delvis synkronisering, selv ved ugunstig timing. Derefter kontrollerer jeg i overvågningen, om backloggen sjældent når sin kapacitetsgrænse; hvis det er tilfældet, øger jeg den gradvist.
Justering af hz, batchstørrelser og netværk
Ud over backloggen ser jeg også på hz-Indstilling, da den påvirker interne vedligeholdelsescyklusser og dermed den gennemsnitlige forsinkelse. Derudover tjekker jeg skrivebatchstørrelser, pipeline-udnyttelse og TCP-parametre for at gøre replikeringsstrømmen mere jævn. En lav latenstid mellem primærserveren og replikaen bidrager direkte til mindre offset-forskelle. Flaskehalse på replikasiden, f.eks. langsomme lagringsmedier eller begrænset CPU-kapacitet, øger ligeledes forsinkelsen. Derfor ændrer jeg kun én faktor ad gangen, måler effekten på offset-forskellen og dokumenterer resultatet tydeligt.
Diskless Sync og snapshot-effekter på offset
Til fuld synkronisering foretrækker jeg at bruge diskløs synkronisering, fordi primærdatabasen derefter leverer RDB-strømmen direkte via netværket og ikke skaber en ekstra skrivebelastning på lokale lagringsmedier. Dette mindsker I/O-spidsbelastninger og stabiliserer offset under til- og frakoblingsfaser. En moderat forsinkelse (repl-diskless-sync-delay) giver andre replikaer tid til at koble sig på, så en RDB-stream udnyttes flere gange. I den forbindelse overvåger jeg CPU- og netværksudnyttelsen, da selv en diskløs overførsel kan føre til kortvarige forsinkelser ved meget store datamængder.
Snapshots (RDB) udløser »Copy-on-Write« ved en fork. På systemer med høj skriveaktivitet øger dette midlertidigt hukommelsesbehovet og kan Anvendelsesfrekvens bremser replikeringen. Derfor planlægger jeg snapshots til roligere tidspunkter på dagen, tjekker lagerpladsreserverne og sørger for, at replikerings- og AOF-stier ikke kommer i konflikt med hinanden.
Delvis resynkronisering i praksis
Hvis en replika kortvarigt er ude af drift, prøver jeg altid først at Delvis afstemning at opnå. Når forbindelsen genoprettes, melder replikaen sig med replikations-ID og den seneste offset, hvorefter primærserveren leverer de manglende bytes fra backloggen. Hvis backloggen ikke er tilstrækkelig, eller hvis ID’et har ændret sig, starter en fuld synkronisering med RDB-overførsel og indhentningsfase. I dette øjeblik overvåger jeg offsets for at se, hvor hurtigt replikaen kommer op i fart, og fra hvilket tidspunkt de to tællere igen ligger tæt på hinanden. Lykkes delsynkroniseringen, forbliver latenstiderne og I/O-spidsbelastningerne betydeligt lavere.
Replikations-ID'er, PSYNC2 og nulstillingsadfærd
For præcise fortolkninger stoler jeg på PSYNC2-semantikken. Primary-enheden fører en opdateret Replikations-ID samt et historik-ID med tilhørende offset. Ved Nye begyndelser eller lederskift ændres primær-ID’et; det gamle ID bevares som historik med slutoffset. En replika kan dermed fortsat indhente forsinkelsen via delvis synkronisering på trods af ID-ændringen, så længe det nødvendige område ligger i backloggen. Jeg vurderer i INFO replikering Derfor læser jeg begge ID’er sammen med deres offsets og kan på den måde se, om der netop er sket et ID-skift, eller om der er et på vej.
Det er vigtigt at huske: Offset er monoton pr. historik, men et ID-skift definerer en ny tidslinje. Jeg dokumenterer dette skift i driften, så trendanalyserne kan placere springet korrekt. Et 64-bit-offset løber praktisk talt aldrig over; langt mere relevante er genstarter, failover eller backlog-konfigurationer, som påvirker historikken.
Kundekvitteringer og holdbarhed i Offset-sammenhæng
Vis forskydninger Fremskridt, men ingen garantier for holdbarheden. Hvis jeg har brug for bekræftelser vedrørende replikaer, bruger jeg desuden:
- VENT: Primærserveren bekræfter, når N replikaer har modtaget en skrivekommando og gemt den i deres inputbuffer. Dette er hurtigere end »Full Sync«-sikkerhed, men garanterer ikke, at dataene er gemt på lagringsmedierne.
- min-replikater-til-skrivning og min-replicas-max-lag: Primærserveren accepterer kun skrivninger, hvis der er tilstrækkeligt mange replikaer forbundet, og deres forsinkelse ligger under en tærskelværdi. Dette mindsker risikoen for split-brain.
Jeg anvender disse mekanismer i sammenhæng med offset: Offset kontrollerer faktisk Indhentningshastighed og langsigtede tendenser, mens WAIT/min-replikater pr. kommando Yde beskyttelse. Ved strenge RPO’er kombinerer jeg dem og registrerer begge synspunkter i overvågningen.
Alarmer og målinger i overvågningsstakken
Til overvågningen fastlægger jeg klare Tærskelværdier baseret på offset-forskellen i byte. Jeg sammenkæder denne måling med tidsserier fra Prometheus/Grafana og udløser alarmer, hvis forskellen overstiger en defineret varighed. Derudover logger jeg tendenser for at identificere belastningsspidser og planlægge modforanstaltninger. Dashboards visualiserer master_repl_offset, replika-offsets og den beregnede forsinkelse, hvilket væsentligt fremskynder analyser under drift. Praktiske tip til opsætninger med tidsserier finder jeg her: Overvågning af Redis med Prometheus og Grafana.
Runbooks og eskaleringsforløb
Jeg foreslår nogle standardiserede trin, så teams kan handle målrettet, når forsinkelsen stiger:
- Advarsel: Lag > X MB i > Y s → Kontroller replikeringsforbindelsens gennemstrømning og ventetid, og identificer konkurrerende opgaver (snapshots, store Lua-scripts).
- Major: Lag stiger kontinuerligt → Backlog-udnyttelse, Replica-CPU/IO og netværksfejl (retransmissioner, tab) hænger sammen; skrivebelastningen bør eventuelt reduceres.
- Kritisk: Backloggen risikerer at løbe over → Aflast replikaen (f.eks. ved midlertidigt at omdirigere læsebelastningen), planlæg et fuld-synkroniseringsvindue eller sæt en ekstra replika i drift.
Jeg dokumenterer beslutningstræer, så det står klart, hvornår en failover stadig er forbundet med lav risiko, og hvornår jeg bør vente, indtil offset-gapet er udjævnet.
Redis Cluster: Vurdering af offsets pr. shard
I en klynge kontrollerer jeg forskydninger pr. shard, fordi hver shard har sin egen replikeringsstrøm. Kommandoen CLUSTER SHARDS giver mig slot-intervaller, node-roller og de relevante offsets for primær og replika. Store afvigelser i en shard tyder på risici ved en ordnet failover af denne shard. Derfor sammenligner jeg systematisk offset-værdierne for alle shards og prioriterer noder med minimal forsinkelse som kandidater til at fungere som ledende node. På den måde sikrer jeg, at det samlede billede forbliver konsistent, og forhindrer uventede hændelser ved skiftet.
Hverdagen i et cluster: Overvågning af resharding og slot-migration
Med Forskydninger af slotte stiger skrivebelastningen ofte ujævnt. Jeg måler forskydninger pr. shard under MIGRATE-faser for at se, om enkelte replikaer kommer bagud. Længere migrationsvinduer i kombination med små efterslæb er særligt følsomme: Her planlægger jeg enten større backlogs eller spreder migrationerne, så delvise synkroniseringer ikke går tabt. Før hver shard-failover vurderer jeg, om målnoden for nylig har overtaget slot-belastningen, og om dens replika-offset forbliver stabil.
Anvendelsestilfælde: Målrettet fortolkning af offset
For at vurdere replikeringsforsinkelsen sammenligner jeg systematisk master_repl_offset med hvert replika-offset og udleder deraf alderen på potentielt forældede data. Før en planlagt overgang vurderer jeg risikoen for failover ved at identificere den nærmeste replika og bekræfte dens konsistens over flere minutter. Hvis forsinkelsen stiger gentagne gange, sammenholder jeg den med netværksmetrikker, CPU-belastning og I/O for at finde flaskehalse og målrettet afhjælpe dem. Ved strenge holdbarhedsmål kontrollerer jeg desuden, om operationer er bekræftet i AOF, og hvordan offsets forholder sig hertil. Disse mønstre hjælper mig med at basere beslutninger på et objektivt tal og holde nedetiden kort.
Kaskadereplikering og geografiske layouts
I distribuerede opsætninger vælger jeg ofte Replika-halskæder (Replica-of-Replica) for at aflaste langdistance-trafikken. Her tager jeg højde for, at offset gælder separat for hver kant, og WAIT – kun direkte forbundne replikaer tæller. Til georeplikering fastsætter jeg realistiske latenstidsbudgetter og måler afvigelser separat for hver region. En planlagt region-failover er først forsvarlig, når den næste kandidat i rækkefølgen over en længere periode viser et minimalt afvigelsesinterval, og netværksstierne er stabile. Ved store afstande reducerer jeg skrivninger i bursts, bruger pipelining med måde og øger backlogs på de noder med den største RTT.
Praksisorienteret drift i hostingmiljøer
I et managed-miljø lægger jeg vægt på klare Dashboards, der samler offset, forsinkelse og tilstand. For teams, der ønsker at fremskynde fejlfinding, er det værd at se nærmere på værktøjer med dyb indsigt i Redis og overskuelig visualisering. På den måde kan jeg tidligt opdage afvigende offsets og iværksætte modforanstaltninger, inden backlogs løber over, eller fuld synkronisering skaber belastningsspidser. Derudover gennemfører jeg failover-tests i staging-miljøer og måler, hvor hurtigt offset-værdierne nærmer sig hinanden igen efter skiftet. Denne vejledning giver mig en praktisk introduktion til grafisk analyse: Redis Insight til fejlfinding.
Mønstre for fejlfinding ved stigende forsinkelse
Når offset-gapet stiger, følger jeg nogle tilbagevendende mønstre:
- Replica-CPU’en er fuldt udnyttet: Single-thread-flaskehalse eller ressourcekrævende Lua-scripts bremser behandlingen; jeg verificerer dette ud fra behandlingshastigheden og udjævner spidsbelastninger.
- Hukommelses- eller I/O-tryk: AOF-Rewrite, Snapshot eller støjende naboer øger latenstiden; jeg flytter job, optimerer lagringsklasser eller aktiverer diskless-synkronisering.
- Netværksstien varierer: Retransmissioner, tabte pakker eller MTU-uoverensstemmelser; jeg kontrollerer grænsefladefejl og bufferstørrelser og reducerer pakketab.
- Replica-output-buffer: Hvis grænsen for replikaer vælges for lav, afbryder primærserveren forbindelsen; jeg indstiller client-output-buffer-limit til replikaer, der passer til lasten.
- TLS-overhead: På en svag CPU kan kryptering begrænse strømforbruget; jeg måler kryptoomkostningerne og skalerer antallet af kerner eller aflaster systemet ved hjælp af hardwareacceleration.
- Diagnoseværktøjer med bivirkninger: MONITOR eller for hyppig logning gør systemet langsommere; jeg bruger sådanne værktøjer sparsomt og kun i en begrænset periode.
Jeg sørger for, at disse mønstre er til stede i teamet, så vi ikke starter helt forfra, når der dukker advarselssignaler op, men i stedet hurtigt tester og forkaster hypoteser.
Oversigt i tabelform: Nøgletal på et øjeblik
Jeg sammenfatter gerne følgende oversigt under arbejdet, fordi den indeholder de vigtigste Nøgletal og samler tilbud og kampagner ét sted.
| Signal | Betydning | Typisk kilde | Handling/fortolkning |
|---|---|---|---|
| master_repl_offset | Bytes, som den primære instans har genereret i replikeringsstrømmen | INFO replikering | Udgangspunkt for beregning af forsinkelse, overvåg forløbet |
| slave_repl_offset | Bytes, som replikaen allerede har anvendt | INFO replikering, afsnit om replikaer | Træk fra master_repl_offset, fastlæg forskellen |
| Replikations-ID | Markør for dataenes historik/generation | INFO replikering | Kombiner med offset, kontroller delvis afstemning |
| Størrelsen af ordrebestanden | Ringbuffer til de seneste bytestykker | Konfiguration, INFO-replikering | Vælg en større model ved stort skrivevolumen |
| replikationsforskydning (klynge) | Offsets pr. shard for primær/replika | CLUSTER-SHARDS | Vurdering af shard-kandidater til skift |
Resumé: Bliv ekspert i offset – undgå fejl
Jeg indstillede Offset som en central nøglemetrik for at sikre konsistens, delvise synkroniseringer og failover-adfærd. Med INFO-replikering, en passende backlog-størrelse og velfungerende alarmer holder jeg de replikerede noder tæt sammen. I klyngetopologier vurderer jeg offsets for hver shard og prioriterer kandidater med minimal forsinkelse. Finjustering af hz, netværk og hukommelsesveje reducerer forsinkelsen yderligere og forhindrer kostbare fuldstændige synkroniseringer. Ved konsekvent at overvåge offsets reducerer man nedetid og øger pålideligheden af hele Redis-stakken markant.


