Ir al contenido

El cgroup de Linux Controlador de la CPU controla la cantidad de tiempo de procesamiento que reciben los servicios, los contenedores y los procesos, y permite planificar el rendimiento de forma específica. Te explicaré concretamente cómo interactúan la ponderación, las cuotas y las prácticas para que puedas asignar el tiempo de CPU de forma segura y evitar cuellos de botella.
Puntos centrales
- ponderación frente a Límite Entender: ¿reparto justo o límite máximo estricto?
- cgroup v2 Dar prioridad a: una semántica clara y una jerarquía coherente
- peso.cpu y cpu.max: las dos palancas de ajuste
- systemd Uso: establecer reglas por servicio
- Monitoreo y Transparencia: Consultar cpu.stat y PSI
Entender los cgroups: grupos de procesos y objetivos
Resumo los procesos en Grupos y, a través de ellos, gestiono recursos como la CPU, la memoria y las E/S en jerarquías claramente delimitadas. En lugar de tener que lidiar con PID individuales, asigno servicios completos, contenedores o grupos de trabajadores a un grupo de control y establezco reglas claras. De este modo, evito que una tarea desbocada ralentice la máquina mientras hay componentes importantes que deben responder. Este enfoque resulta especialmente útil en el contexto del alojamiento web, ya que muchos clientes y servicios se ejecutan en el mismo hardware. Este artículo ofrece una buena visión general sobre cómo aplicarlo en la práctica: cgroups y alojamiento web, que permite comprender la separación de cargas.
Cómo funciona el controlador de la CPU
El controlador de la CPU divide tiempo de cálculo a través de dos mecanismos: la ponderación relativa y la limitación absoluta del ancho de banda. La ponderación significa que, en cuanto surge la competencia, los grupos reciben porciones de CPU en proporción entre sí; los valores más altos obtienen así intervalos de tiempo con mayor frecuencia. Un límite por cuota restringe el consumo en un intervalo de tiempo fijo, incluso si no hay competencia. Elijo la ponderación cuando priman la equidad y la utilización dinámica de los recursos, y establezco cuotas cuando es necesario mantener un límite máximo estricto e inamovible. La documentación del núcleo explica claramente esta diferencia y muestra cómo ambos mecanismos, combinados, dan lugar a un modelo de control coherente [1].
cgroup v1 frente a v2: diferencias y archivos
Con cgroup v2 Gestiono las reglas de la CPU de forma más uniforme y clara en comparación con la versión anterior, la v1. En la v1 utilizaba distintos archivos para cada controlador; en la v2 me centro en «cpu.weight» para la prioridad relativa y en «cpu.max» para un límite de ancho de banda estricto. Esta clara separación reduce el tiempo de configuración, evita malentendidos y facilita las auditorías. En entornos de alojamiento con muchos contenedores, la jerarquía de la v2 garantiza unas reglas transparentes en todos los niveles. El artículo sobre cgroup v2 en el alojamiento web, que aborda el control coherente en el caso de hardware compartido.
| Tema | cgroup v1 | cgroup v2 | Parámetros típicos |
|---|---|---|---|
| Ponderación de la CPU | cpu.acciones | peso.cpu | peso.cpu (El valor por defecto suele ser 100) |
| Cuota/límites de la CPU | cpu.cfs_quota_us + cpu.cfs_period_us | cpu.max | cpu.max (p. ej., 20 000 100 000) |
| Jerarquía | Controladores independientes | Estructura de árbol uniforme | Normas comunes para cada nivel |
| En tiempo real | Controlador rt independiente | Restricciones para RT | Véanse las notas sobre el núcleo [1] |
Para los administradores, lo importante es que Coherencia Reduzco los errores en la configuración y hago que los cambios surtan efecto más rápidamente. Documento los parámetros en los nodos de grupo para que todo el mundo pueda ver el efecto actual. En las migraciones desde la v1, compruebo minuciosamente los equivalentes, sobre todo los «shares» en «Weight» y las «cuotas CFS» en «cpu.max». Solo cuando las cargas de prueba reaccionan según lo esperado, traspaso los servicios en producción a la nueva jerarquía. Esta transición disciplinada ahorra muchos ciclos de soporte técnico más adelante.
Jerarquía, subárboles y delegación
En cgroup v2 controlo los controladores por nivel y delégalas según sea necesario. A través de cgroup.subtree_control Activo el controlador de CPU para los nodos secundarios; systemd suele encargarse de ello automáticamente cuando configuro las propiedades de la CPU. Importante: en la v2, lo ideal es mantener los procesos en Grupos de hojas y no en nodos intermedios. De este modo, las reglas son más claras y la distribución de la carga sigue claramente la estructura de árbol. En configuraciones complejas, asigno servicios completos a las «slices» (p. ej.,. tenant-a.slice), entre los que se incluyen los servicios y los grupos de trabajadores. Esta clara separación facilita la delegación en equipos que trabajan en „sus“ subárboles sin infringir las políticas globales.
Parámetros importantes: cpu.weight y cpu.max
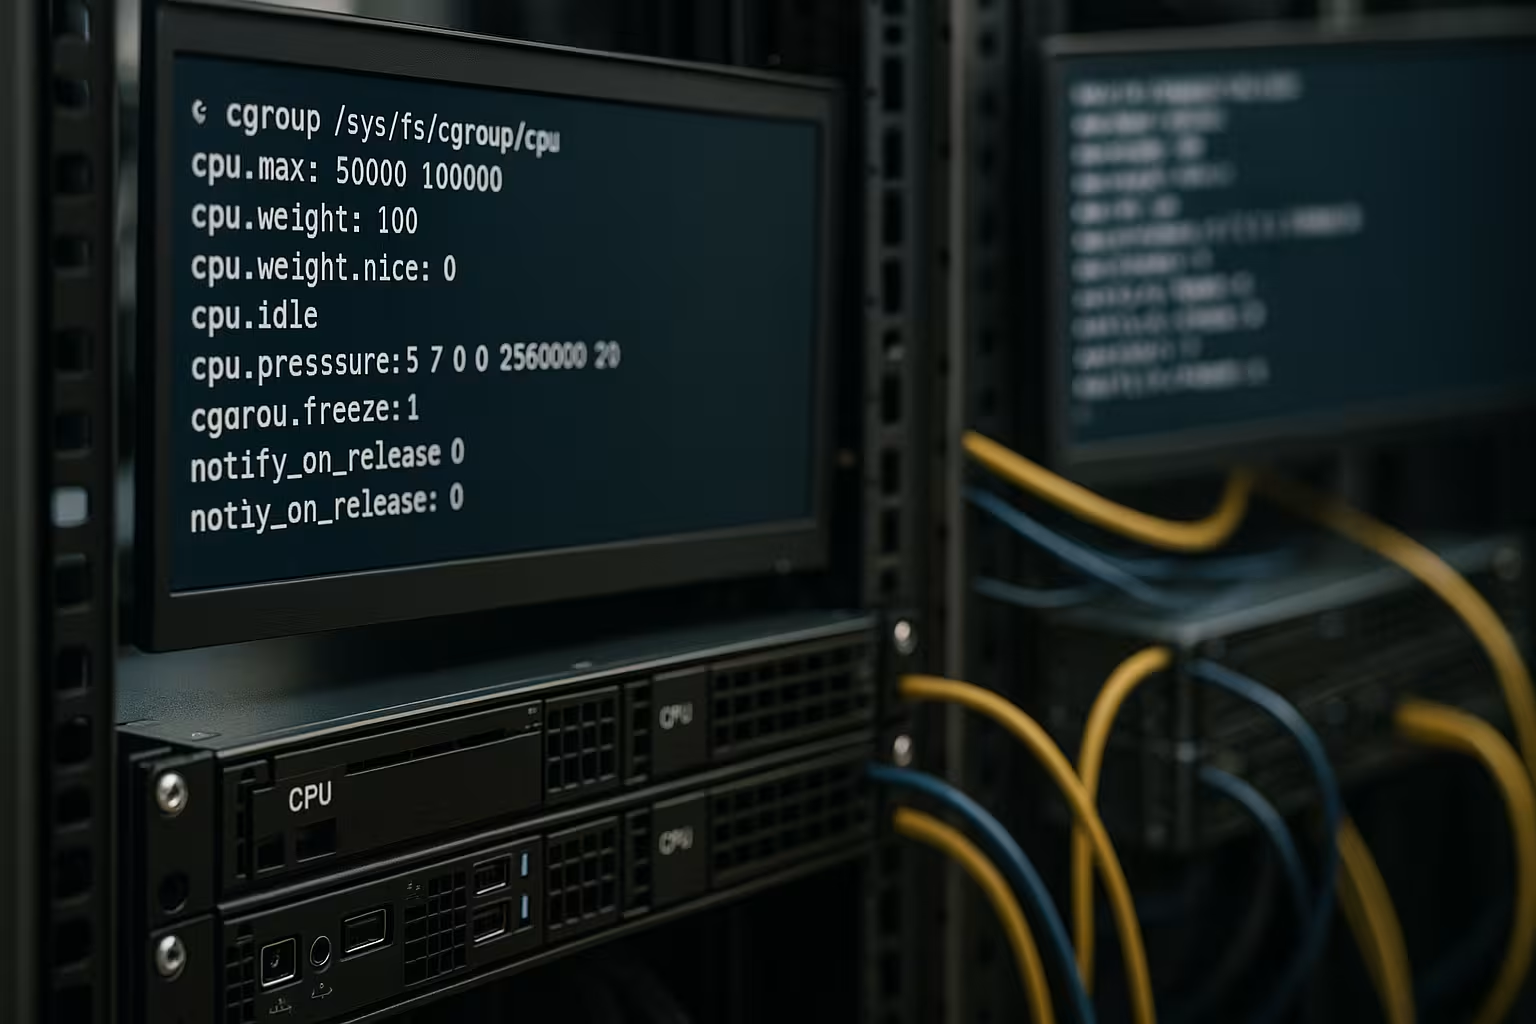
Utilizo peso.cpu, para priorizar los servicios de forma relativa: si al servicio A se le asigna un peso mayor que al servicio B, A obtendrá tiempo de CPU con mayor frecuencia cuando haya carga. El valor por defecto en la v2 suele ser 100; los valores más altos dan prioridad al grupo correspondiente, pero yo me mantengo dentro de unos límites razonables para que la proporción sea controlable. Para establecer límites estrictos, escribo en cpu.max una cuota y un período, por ejemplo 20000 100000 aproximadamente el 20 % de una ranura de vCPU. Con máx. En primer lugar, elimino el límite máximo, pero mantengo el período, lo que facilita los diagnósticos. Red Hat documenta de forma clara las configuraciones habituales y muestra sus efectos en el funcionamiento [2].
Parámetros de ajuste adicionales: cpu.weight.nice y UClamp
Para equipos que partan de la clásica agradable-En cuanto a la semántica, la v2 ofrece cpu.weight.nice un puente práctico: puedo formar grupos en el ámbito de -20..19 clasificar, lo que internamente se corresponde con la escala de ponderación. De este modo, las expectativas relativas („preferir un poco“, „reducir ligeramente“) se mantienen coherentes sin tener que establecer ponderaciones concretas cada vez. Además, si es necesario, establezco Fijación de la utilización a través de cpu.uclamp.min y cpu.uclamp.max, para establecer un límite mínimo o máximo para la utilización efectiva de la CPU a nivel del programador. De este modo, me aseguro, por ejemplo, de que un servicio en el que la latencia es crítica no caiga por debajo de la carga básica necesaria, incluso con un número reducido de subprocesos, o de que los trabajos por lotes no reciban un aumento excesivo de potencia. Este ajuste fino complementa la ponderación y las cuotas, pero no las sustituye: siempre compruebo cómo se integra UClamp con mi política de controladores y de energía antes de implementarlo a gran escala.
Planificación de cargas de trabajo: equidad frente a límites estrictos
Decido conscientemente si Equidad o que tengan prioridad los límites máximos estrictos. Para los servicios web en los que la latencia es crítica, aumento ligeramente la ponderación para que se ejecuten con prioridad en caso de competencia, sin perjudicar en exceso a otros grupos. Para los trabajos por lotes que requieren un gran esfuerzo computacional, establezco además una cuota para que nunca ocupen demasiado tiempo, incluso si el sistema está inactivo. A las bases de datos les asigno una ponderación moderada y observo cómo afectan los puntos de control, las reconstrucciones o las consultas de gran volumen; si es necesario, realizo ajustes temporales. Combino estas reglas con alertas para poder reaccionar a tiempo, antes de que la latencia se agrave.
Comportamiento de las cuotas en procesadores multinúcleo y selección de períodos
Un escollo habitual es la interpretación de Rendimiento en sistemas multinúcleo. Una cuota se refiere a la Tiempo total de cálculo del grupo por período, no a núcleos individuales. CPUQuota=200% o cpu.max = 200 000 100 000 Permiten, a grandes rasgos, dos segundos de CPU por cada periodo de 100 ms, repartidos entre todos los hilos/núcleos. Esto puede significar que muchos hilos se ejecuten en paralelo durante un breve periodo de tiempo, hasta que el grupo se „agote“ en el periodo actual y se limite su rendimiento. Evito malentendidos pensando siempre en las cuotas en términos de „espacios de CPU“ y adaptándolas al grado de paralelismo del servicio.
El período estándar suele ser de 100 ms. Períodos más cortos (z. B. 50 ms) hacen que la limitación surta efecto más rápidamente, pero pueden generar microfluctuaciones; unos períodos más largos suavizan el comportamiento, aunque reaccionan con mayor lentitud. En systemd lo ajusto con CPUQuotaPeriodSec= y compruebo si se alcanzan mejor los picos de latencia o los objetivos de rendimiento. Para los servicios interactivos, mido la latencia de extremo a extremo; para los de procesamiento por lotes, me guío por el rendimiento total y la equidad con respecto a los vecinos.
Práctica: Configuración con systemd y cgroup v2
En systemd configuro reglas para cada servicio, porque Archivos de servicio permitir una configuración reproducible. Con systemctl set-property Las voy modificando continuamente y, con archivos «drop-in», gestiono las versiones de la configuración de forma ordenada. Un ejemplo: systemctl set-property --runtime nginx.service CPUWeight=150 NGINX establece fácilmente las prioridades; systemctl set-property --runtime batch.service CPUQuota=20% limita los trabajos por lotes. De forma permanente, introduzco en /etc/systemd/system/service.d/limits.conf Configura las opciones correspondientes y vuelve a cargar las unidades. Para empezar de forma práctica, te recomendamos que eches un vistazo a esta guía sobre Control de recursos de systemd, que resume brevemente las opciones más habituales.
# Ejemplos para systemd v245+ con cgroup v2
# Priorización relativa
systemctl set-property --runtime nginx.service CPUWeight=150

# Límite máximo estricto
systemctl set-property --runtime batch.service CPUQuota=20%

# Combinación en un archivo 'drop-in'
mkdir -p /etc/systemd/system/php-fpm.service.d
cat < /etc/systemd/system/php-fpm.service.d/cpu.conf
[Service]
CPUWeight=120
CPUQuota=50%
EOF
systemctl daemon-reload
systemctl restart php-fpm.service
Slices para inquilinos y equipos
Para delimitar clientes o equipos, utilizo Rebanadas como marco organizativo. Un «slice» agrupa varios servicios y ámbitos que se regulan de forma conjunta. De este modo, asigno presupuestos por cliente sin tener que gestionar cada unidad por separado y delego los cambios de forma controlada.
#: Slice de inquilino con reglas estándar
mkdir -p /etc/systemd/system/tenant-a.slice.d
cat < /etc/systemd/system/tenant-a.slice.d/cpu.conf
[Slice]
CPUWeight=120
CPUQuota=150%
# Opcional: periodo para una limitación más precisa
CPUQuotaPeriodSec=100ms
EOF
systemctl daemon-reload
systemctl restart tenant-a.slice
Todos los servicios en tenant-a.slice heredan estas especificaciones. En caso de picos puntuales, aumento el peso de forma temporal, pero mantengo la cuota estable para que los sistemas vecinos no se vean desplazados.
Supervisión y resolución de problemas
Compruebo la eficacia y los efectos secundarios con Transparencia en métricas. Los archivos cpu.stat y cpu.pressure (PSI) por cada cgroup me proporciona porcentajes, tiempos de espera y atascos que indican una limitación o una sobrecarga. Con top, htop y systemd-cgtop Detecto las tendencias de distribución en tiempo real y las comparo con mis reglas. Si las latencias aumentan, pero la CPU está inactiva, el problema se debe más bien a la E/S o a los bloqueos que a los límites de la CPU; en ese caso, no ajusto la ponderación de forma precipitada. Tras realizar cambios, documento los valores medidos durante al menos un ciclo de carga para evitar correlaciones erróneas.
Manual de seguimiento: lo que leo concretamente
cpu.stat: usage_usec, user_usec, system_usec muestran el consumo; nr_periods, nr_throttled, throttled_usec ponen al descubierto una fuerte restricción. Aumenta nr_throttled/nr_periods Si la diferencia es de más de un porcentaje, el margen es demasiado estrecho o el período demasiado corto.cpu.pressure: Observo algunos valores medios 10/60/300 para atascos que afectan a la latencia. Un valor elevado de forma persistente, a pesar de que las CPU estén libres, indica contienda por bloqueos, conflictos de afinidad o accesos remotos NUMA.systemd-cgtopyP.D.: Compruebo si los hilos pueden funcionar realmente en paralelo o si tienen que esperar a recursos exclusivos.
Para que las pruebas sean reproducibles, utilizo stress-ng, sysbench o utilizo mis propios generadores de carga y registro instantáneas de métricas antes y después. Solo cuando los valores de medición se ajustan de forma estable a las expectativas, implemento los cambios.
En tiempo real y particularidades
En En tiempo real-En cuanto a las cargas de trabajo, sigo las indicaciones de la documentación del núcleo, ya que la versión 2 gestiona el controlador de la CPU para RT de forma limitada. Ciertos subprocesos RT deben estar en el cgroup raíz, y la configuración requiere un enfoque cauteloso. Además, compruebo cómo se comporta la programación RT con las cuotas, para evitar que se supere involuntariamente algún plazo. Para los servicios típicos de web y bases de datos utilizo políticas normales, ya que esta configuración resulta más predecible en el día a día. Cuando necesito RT, aíslo los sistemas o reservo núcleos de forma clara, para que no se produzcan interacciones inesperadas [1].
Control de precisión en sistemas multinúcleo
El controlador de la CPU divide Ventana de tiempo, no la frecuencia de reloj, por lo que, cuando es necesario, lo combino con cpuset y afinidad. Para lograr una latencia baja en ruido, limito los cambios entre sockets, asigno subprocesos a núcleos locales NUMA y optimizo la distribución de IRQ. Dejo que los servicios por lotes se ejecuten de forma más flexible, para que aprovechen la capacidad restante sin bloquear núcleos destinados a interfaces críticas. Reviso las políticas de turbo o de ahorro de energía, ya que los cambios de frecuencia pueden alterar considerablemente el comportamiento bajo carga. Solo la combinación de cuotas, ponderaciones, afinidad de la CPU y estrategia energética ofrece resultados consistentes.
SMT, NUMA y la afinidad en la práctica
En sistemas con SMT/Hiperroscado Observo que dos subprocesos lógicos en un núcleo físico no proporcionan dos ranuras completas de CPU. Una cuota de „100 %“ cubre una ranura lógica, no necesariamente toda la potencia de un núcleo físico. Por eso mido la latencia y el rendimiento con y sin el uso de SMT. En los sistemas NUMA, limito los servicios críticos con AllowedCPUs= (cpuset) o Afinidad CP= utiliza núcleos locales y configura la asignación de memoria en consecuencia, para que los accesos remotos no echen por tierra toda la planificación detallada.
Buenas prácticas para el alojamiento web y los contenedores
Empiezo con moderación Por defecto: Asigno una ponderación ligeramente superior a los servicios web, las bases de datos se ajustan prácticamente al estándar y los procesos por lotes tienen una cuota. Para los inquilinos, establezco límites máximos por cliente y permito picos de uso mediante la ponderación, siempre que no haya otras necesidades. Documento los perfiles según el caso de uso, por ejemplo, „sensible a la latencia“, „mixto“ y „con gran carga computacional“, y establezco rangos claros para weight y cpu.max por cada perfil. Primero aplico los cambios en el entorno de prueba y los simulo con una carga sintética que refleje de forma realista los picos. Mantengo los registros y las métricas cerca de los límites de los cgroups para que los diagnósticos no se pierdan en la niebla.
Orquestación de contenedores: recursos compartidos, solicitudes y límites
En entornos de contenedores, asigno Solicitudes la ponderación relativa y Límites cuotas estrictas. Esto permite picos de actividad siempre que los nodos dispongan de capacidad libre y garantiza, en situaciones de competencia, una distribución equitativa según la ponderación. Los pods o servicios críticos reciben una ponderación ligeramente superior, sin que los límites limiten el rendimiento de los demás. Me aseguro de que la suma de los límites por nodo se ajuste de forma realista a la CPU disponible; de lo contrario, a pesar de que las reglas sean correctas, se produciría una limitación en todo el sistema que afectaría a todos los inquilinos.
Configuraciones de ejemplo y ejemplos de cálculo
Siempre calculo las cuotas en Acciones por ranura de vCPU: cpu.max = PERÍODO DE CUOTA equivale a CUOTA/PERÍODO de la ranura. Ejemplo: 20000 100000 son 0,2 de una sola CPU; con cuatro CPU, el máximo es de 0,8 de ranura total, pero no se garantiza su distribución. Para los porcentajes en systemd, escribo CPUQuota=20%, lo que, según la versión, se ajusta a cpu.max. Quien establezca límites estrictos debe sopesar el comportamiento en ráfagas frente a la latencia: un periodo demasiado corto puede provocar microtartamudeos, mientras que uno demasiado largo distribuye la carga de forma más uniforme, pero reacciona con mayor lentitud. Por ello, pruebo períodos de entre 50 y 100 ms y elijo la variante que se adapta a la clase de latencia del servicio [2].
Migración de la v1 a la v2 sin sorpresas
Al cambiar de línea, paso a cpu.acciones en peso.cpu y cpu.cfs_quota_us/period_us en cpu.max. Una asignación pragmática para las acciones es: 1024 → ~100, 2048 → ~200, 512 → ~50. Realizo pequeños ajustes tras las pruebas de carga, ya que las escalas difieren. Además, tengo previsto que las normas de la versión 2 para niños acumulativo Efecto: una cuota restrictiva en el nodo padre limita a todos los subgrupos en conjunto. Por eso, a menudo elimino las cuotas de los nodos padres (máx.) y realizo ajustes granulares en las hojas para evitar efectos secundarios.
Problemas habituales y soluciones
- 100 % confundido con „todos los núcleos“: 100 % corresponden a una ranura lógica de la CPU, no a toda la máquina. Solución: calcular la cuota en función de las ranuras necesarias (por ejemplo, 400 % para cuatro ranuras).
- Periodo demasiado corto: Pequeños tirones en los servicios interactivos. Solución: aumentar el período o utilizar el peso en lugar de la cuota.
- Ponderación medida sin competencia: El peso solo surte efecto en condiciones de competición. Solución: realizar pruebas con una carga paralela real.
- Olvídate de las cuotas para padres: Un padre con límite frena a todos los hijos. Solución:
cpu.max=maxen el elemento padre, límites en las hojas. - NUMA/zócalo ignorado: Latencia a pesar de que la CPU está libre. Solución: comprobar la afinidad/los conjuntos de CPU y la localidad de la memoria.
Resumen
Con el Controlador de la CPU Asigno tiempo de computación de forma selectiva, establezco prioridades justas y fijo límites estrictos cuando es necesario. cgroup v2 ofrece parámetros claros como cpu.weight y cpu.max, que planifico y mido en función de la carga de trabajo. A través de systemd establezco reglas para cada servicio, compruebo el efecto con cpu.stat y PSI, y realizo ajustes sin tener que ir a ciegas. Para inquilinos, contenedores y entornos de servidores mixtos, este control sigue siendo clave para lograr fiabilidad y previsibilidad. Quien documenta las reglas, las implementa paso a paso y las valida con pruebas de carga, evita los cuellos de botella y mantiene el control sobre el tiempo de CPU.