 Vai al contenuto

Ti mostrerò come interpretare vmstat su Linux in modo mirato: potrai individuare colli di bottiglia della CPU, pressione sulla memoria, swap e tempi di attesa I/O in pochi secondi. Ecco come interpretare con sicurezza le colonne r, b, free, si/so, bi/bo e us/sy/id/wa/st e dedurre misure concrete dai modelli osservati – senza tirare a indovinare, con chiaro Regole.
Punti centrali
- Coda di esecuzione vs. Blocchi: r indica il carico della CPU, b segnala tempi di attesa I/O.
- Memoria Valutazione realistica: la gratuità da sola non conta, è il «si/so» a fare la differenza.
- I/O In sintesi: bi/bo non destano preoccupazioni se il valore rimane basso.
- Quote di mercato delle CPU Significato: us+sy alto, id basso → carico elevato.
- Linee di base Creare: confrontare i valori della vita quotidiana con le fasi problematiche.
Cosa mostra realmente vmstat?
Vmstat raggruppa lo stato dei processi, la memoria, lo swap, l’I/O a blocchi e le quote di utilizzo della CPU in un output sintetico che in pochi secondi fornisce un a livello di sistema Fornisce un’idea generale. Per prima cosa leggo „procs“ per r/b, poi „memory/swap“ per free, buff, cache e si/so. Successivamente controllo „io“ con bi/bo e concludo con „cpu“ per us, sy, id, wa e, facoltativamente, st. Questa sequenza mi aiuta a distinguere causa ed effetto: un valore elevato di r indica carico di calcolo, un valore elevato di b indica tempi di attesa I/O, mentre wa collega l’inattività della CPU alla latenza I/O. In questo modo capisco se il collo di bottiglia è il carico di calcolo, la carenza di memoria o il supporto di dati – e mi risparmio Deviazioni.
Inizio tra 60 secondi: chiamate e intervalli
Per ottenere un’istantanea a partire dall’avvio del sistema, eseguo il comando „vmstat“ senza parametri; per analisi più approfondite utilizzo „vmstat 1“ oppure „vmstat 5 12“ per ottenere dodici punti di misurazione ogni cinque secondi e ottengo un temporale Riga. Importante: la prima riga riporta i valori medi dal riavvio del sistema, pertanto valuto soprattutto le righe successive. Con Delay/Count controllo la frequenza di campionamento e la durata, ad esempio „vmstat 1 30“ in caso di picchi brevi. Per carichi di lavoro instabili imposto 1–2 secondi, mentre per scenari tranquilli preferisco 5 secondi. Osservo le tendenze, non i singoli fotogrammi, perché sono gli schemi a rivelare le vere Cause spettacolo.
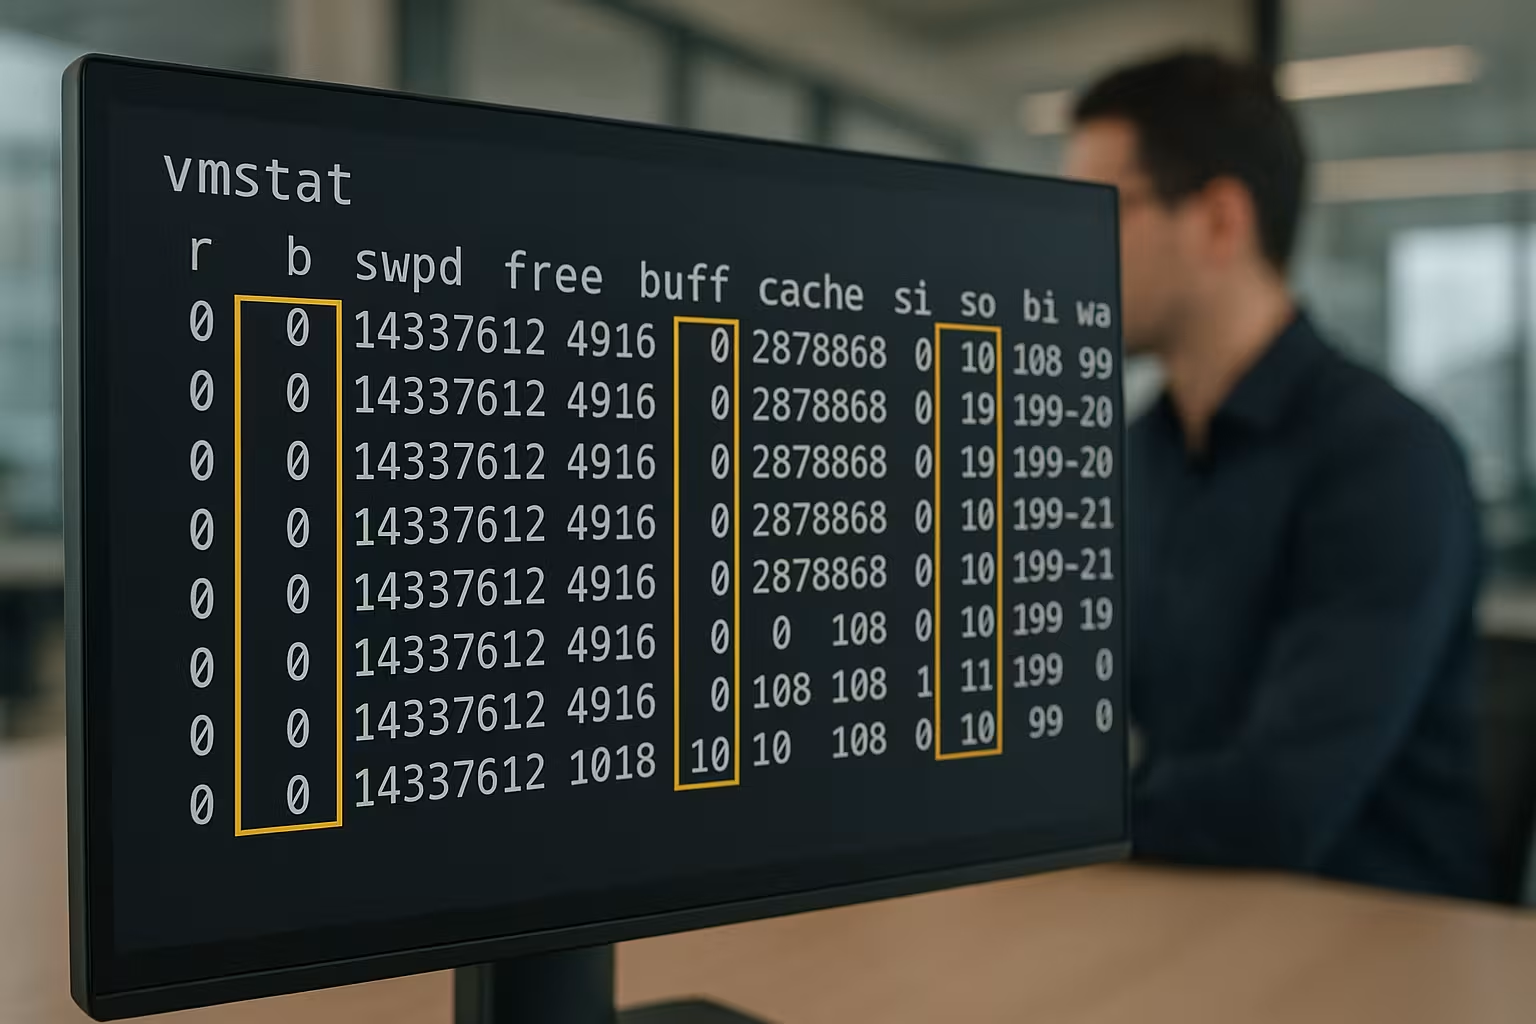
Leggere i processi: r e b nella vita di tutti i giorni
La colonna r mostra i thread pronti all'esecuzione che sono in attesa di tempo CPU, mentre b conta i thread bloccati, spesso in attesa di I/O. Se r rimane nettamente superiore al numero di core fisici, si impone un Colli di bottiglia della CPU ; su quattro core, un valore r=8 mantenuto per un periodo prolungato è considerato un chiaro segnale. Un valore b maggiore di 0 mantenuto per un periodo prolungato indica supporti di dati lenti, database sovraccarichi o percorsi di rete o di archiviazione lenti. Correlando r con us+sy e id: se id è basso e r è alto, la CPU è sotto sforzo; se wa è alto e b è alto, è l’I/O a rallentare il sistema. In questo modo decido se scalare la potenza di calcolo, ottimizzare le query o il Sistema di stoccaggio controllo.
Interpretazione delle memorie: free, buff, cache, swpd
Un valore basso di "free" è normale su Linux, poiché il kernel utilizza in modo intensivo la RAM come cache, il che accelera l'accesso ai file e garantisce un vero Produttività porta. Per questo motivo prendo più in considerazione swpd e gli stream di swap si/so piuttosto che solo free. Un valore elevato di cache va bene, purché si/so rimanga quasi sempre a 0; solo un movimento persistente dello swap indica una pressione reale. Se si verificano anche latenza o addirittura OOM, intervengo: aumento la RAM, ottimizzo i processi per tempo o regolo le dimensioni della cache e della JVM. Il contesto rimane importante: il carico di lavoro, la dimensione della memoria e il layout NUMA determinano ciò che nel tuo ambiente è considerato sano vale.
Attività di swap: classificare in entrambi i casi
Le colonne "si/so" misurano il flusso costante di dati tra la RAM e lo swap in KB/s e mettono in evidenza il carico effettivo sulla memoria, non solo quello percepito carenza. Brevi picchi sono normali, ad esempio quando vengono spostate pagine utilizzate raramente. La situazione diventa critica quando questi valori rimangono costantemente superiori a 0; ciò rallenta tutto, poiché ogni operazione di paging genera costi aggiuntivi di I/O. Valori elevati di «so» indicano uno spostamento attivo in memoria di paging e i tempi di risposta aumentano in modo significativo. A questo punto intervengo sulle cause: riduco il consumo di memoria, espando la RAM o ottimizzo i servizi che richiedono molta memoria sintonia.
Comprendere l'I/O a blocchi: bi e bo
Con bi/bo rilevo la velocità di lettura e scrittura in blocchi al secondo, ma senza contesto non la valuto; ciò che conta è l'interazione con wa. Valori elevati di bi/bo, accompagnati da un valore wa altrettanto elevato, indicano che lo storage non riesce a tenere il passo. Se un valore bi elevato si verifica in un database, controllo i profili delle query e gli hit della cache prima di sostituire l’hardware. Per un'analisi più approfondita dei tempi, utilizzo iostat e analizzo la lunghezza delle code e le latenze, in modo da poter Analisi dell’attesa I/O e affrontare in modo mirato le carenze. Solo se wa rimane basso, ma bi/bo sale alle stelle in modo duraturo, penso a Scala del sistema di archiviazione.
Quote della CPU: us, sy, id, wa, st
Valori US elevati con WA basso indicano un lavoro utile produttivo, mentre valori SY elevati indicano un elevato overhead del kernel, come innumerevoli piccole operazioni di I/O o molte Cambiamento di contesto. Se id scende vicino a 0 e rimane tale, la CPU sta funzionando al limite; se a questo si aggiunge un valore elevato di r, ciò indica un carico di calcolo elevato. Se wa aumenta, la CPU è in attesa di operazioni I/O: in questo caso, l’ottimizzazione dello storage spesso porta a risultati migliori rispetto agli aggiornamenti della CPU. Nelle VM prendo in considerazione st (steal): valori elevati di st indicano che l’hypervisor sottrae tempo di CPU, quindi ne parlo con l’amministratore in merito al carico dell’host. Valuto sempre us+sy come somma, poiché questa mostra l’attività Lavoro nel sistema.
Guida rapida: colonne e valori di riferimento
Utilizzo la tabella seguente come breve promemoria quando analizzo i risultati di vmstat per una prima Valutazione lettura trasversale.
| Colonna | Significato | A cosa faccio attenzione |
|---|---|---|
| r | Thread pronti per l'esecuzione | Permanente > Nuclei → Pressione della CPU |
| b | Discussioni bloccate | Costante > 0 + wa al potere → problema di I/O |
| libero | RAM gratuita | Un valore basso va bene, purché si/so rimanga ≈ 0 |
| buff/cache | Buffer FS/Cache di pagina | Avere molta cache è positivo; può essere condiviso diventare |
| si/so | Swap In/Out | Costante > 0 → pressione effettiva nel serbatoio |
| bi/bo | I/O a blocchi | È critico solo se wa è contemporaneamente elevato |
| us/sy | Utente/Kernel | us+sy costante > 80% → alto Carico |
| id | marcia a vuoto | Valore vicino a 0 nel tempo → CPU satura |
| wa | Attesa I/O | Alto con b alto → Causa: lo storage |
| st | Steal (macchine virtuali) | Alto → L'hypervisor utilizza CPU-Tempo |
Linee di base e monitoraggio continuo
Non mi baso su singoli dati isolati, ma confronto gli stessi valori con i valori di riferimento relativi a periodi tranquilli, in modo da poter individuare con precisione i valori anomali riconoscere. Il comando „vmstat 1 60“ mi fornisce un profilo di carico su un minuto, che confronto con le fasi normali note. Per avere una visione storica utilizzo Monitoraggio sar/sysstat, per valutare l'andamento nel corso dei giorni e affinare i valori limite. Impostiamo gli avvisi in modo prudente: r rispetto ai nuclei, si/so diverso da 0 su più intervalli, wa sensibilmente aumentato. In questo modo interveniamo tempestivamente, prima che gli utenti segnalino ritardi e prima che Picco- Le fasi si aggravano.
Vmstat in combinazione con altri strumenti
Comincio con vmstat, valuto la situazione in base agli andamenti e approfondisco in modo mirato con iostat, mpstat, pidstat o le metriche delle applicazioni, in modo da individuare le cause chiaro assegna. Mentre vmstat mostra i tempi di attesa I/O, io misuro con iostat le latenze e le code per ciascun dispositivo. Se r indica un limite del kernel, mpstat evidenzia le asimmetrie del kernel. In caso di picchi di carico dei processi, fornisce Analisi dei processi pidstat i thread più accesi sul tema del tempo. Solo la correlazione con i log e i tempi delle applicazioni rende il quadro più chiaro e mi porta alla vera Causa.
Riconoscere gli schemi e agire
Se vedo che r è alto, id basso e wa moderato, spesso l'applicazione ottimizza in modo troppo esigente in termini di calcolo, motivo per cui controllo il codice o il parallelismo e pianifico le risorse della CPU prima di Hardware Se i valori di b, wa e bi/bo sono elevati, prendo in considerazione l’ottimizzazione dello storage, l’ottimizzazione delle query e il caching. Se il valore di free è basso (con si/so maggiore di 0), riduco il consumo di memoria, eseguo lo streaming dei risultati o aumento la RAM. Se i valori di us risultano moderati e quelli di sy molto elevati, controllo i filtri dei pacchetti, le opzioni del file system o i driver. Con questa lista di controllo agisco rapidamente e impiego il tempo dove è più conteggi.
Come evitare errori di misurazione: campionamento, unità di misura, prima riga
Ho scelto di non considerare la prima riga per individuare anomalie acute, poiché essa calcola la media sin dall’avvio del sistema e appiana completamente i picchi. Inoltre, baso la frequenza di campionamento sull’ipotesi causale: rilevo i picchi della CPU con intervalli di 1 secondo, mentre le perdite di memoria lente con intervalli di 5–10 secondi. Presto attenzione alle unità di misura: si/so indicano KB/s, bi/bo „blocchi/s“ (storicamente 1 KB per blocco, variabile a seconda della versione di vmstat). Verifico se „vmstat -w“ (output esteso) evita il troncamento delle colonne e se i cambiamenti di frequenza di clock (P-States, Turbo) influenzano la percezione del carico a breve termine. Sincronizzo le misurazioni con i picchi dell’applicazione, invece di considerare ciecamente „minuti interi“.
Decodifica della sezione "System": in e cs
Oltre a procs/memory/swap/io/cpu, vmstat mostra anche „system“: in (interruzioni/s) e cs (cambi di contesto al secondo). Questi due valori mi forniscono molte informazioni sull'overhead del kernel.
- cs molto elevato a carico di lavoro moderato: flutter dei thread, batch dei worker troppo piccoli o contesa sui lock. Aumento le dimensioni dei batch, regolo il parallelismo (pool di thread) e verifico i punti critici dello scheduler e dei mutex.
- a picchi improvvisi: ondate di interrupt di rete o di archiviazione, effetti NAPI/polling o interrupt del timer. Effettuo un confronto con la percentuale sy e i risultati di iostat per verificare i driver o i percorsi di rete.
- cs proporzionale a r: ciò indica una pressione costante di cambiamento di contesto dovuta a un parallelismo eccessivo. Riduco il parallelismo attivo oppure assegno gli hot-thread ai core.
Correlando sempre in/cs con sy e b/wa: solo nel loro insieme emerge un quadro chiaro che permette di capire se il lavoro del kernel è utile (ad es. in termini di throughput) o se rappresenta un puro overhead.
Varianti e opzioni utili di vmstat
Utilizzo vmstat in modo flessibile per ottenere ulteriori punti di vista senza dover cambiare strumento:
- vmstat -s: Contatori cumulativi (ad es. processi avviati all'avvio del sistema, errori di pagina maggiori/minori). Ideali per confrontare le perdite o il numero di casi in intervalli di tempo.
- vmstat -m: Utilizzo dello slab – aiuta a classificare le cache del kernel (Dentry/Inode, rete) come consumatori di RAM.
- vmstat -d: Eventi relativi al disco a livello di totali. Non sostituisce iostat, ma è utile per una rapida verifica della situazione reale.
- vmstat -S M: Convertire le unità (M/K) per facilitare la lettura dei numeri.
- vmstat -w: Le colonne più larghe evitano che le cifre vengano troncate nelle colonne di numeri molto lunghe.
Abbino queste opzioni a brevi intervalli, in modo da non perdere nessun evento e mantenere comunque una visione d'insieme.
Container, macchine virtuali e cgroup: caratteristiche particolari
Nei container interpreto vmstat con cautela: molti dati del kernel sono a livello di host, mentre i limiti provengono dai Cgroup. Valori elevati di r in un container riflettono la prospettiva del namespace, ma il tempo CPU effettivo può essere limitato dalla quota CPU o dalle quote di CPU. Mi riferisco a st (Steal) nelle VM: un valore elevato di st significa che l’hypervisor mi sottrae tempo – in tal caso, anche un’ottimizzazione perfetta dell’app serve a poco, fintanto che l’host è sovraccarico. In presenza di limiti di memoria nei Cgroup, il si/so potrebbe non verificarsi, anche se il container „si agita“ al limite (terminazioni OOM invece dello swap). Controllo quindi anche i log OOM e le statistiche dei Cgroup e confronto le immagini vmstat con i limiti.
NUMA e affinità: quando la località fa la differenza
Sugli host NUMA controllo r e us/sy per ogni core (con mpstat) e osservo se singoli socket si „surriscaldano“ mentre altri rimangono inattivi. Una localizzazione della memoria inadeguata comporta un aumento di cs/sy e b/wa a causa di accessi alla memoria a distanza. Testo l’affinità della CPU e della memoria (cpuset, numactl), imposto gli heap di grandi dimensioni in modalità „interleaved“ o «strictly local» e mi assicuro che i thread «caldi» vengano eseguiti dove si trova il loro footprint di dati. Un layout NUMA stabile livella il cs, riduce i picchi di wa e aumenta la Pianificabilità sotto carico.
Evitare interpretazioni errate: wa e b sono molto più che semplici „supporti di dati lenti“
Il valore wa non aumenta solo a causa delle classiche latenze del disco: anche le reti NFS/ad alta latenza, l’object storage saturo, i volumi cloud che causano blocchi o i writeback lenti della cache di pagina fanno salire il valore wa. b conta i task in stato di sospensione non interrompibile (D-State) – tra questi rientrano anche i blocchi a livello di driver, percorsi di rete o blocchi del filesystem. Per questo motivo non valuto mai wa/b isolatamente, ma sempre insieme a bi/bo e ai tempi delle applicazioni. Se wa è alto, ma bi/bo è basso, spesso si tratta di un Dipendenza dall'attesa al di là della mera questione della velocità di trasmissione dei dispositivi (ad es. locking, I/O remoto, congestione del writeback).
Ottimizzazione con buon senso: Swappiness, Writeback, Scheduler
Modifico Kernel-Tuner solo dopo aver effettuato le misurazioni e con un piano di ripristino:
- vm.swappiness: Un valore basso riduce lo swapping proattivo, il che è utile per le app in cui la latenza è un fattore critico; se troppo basso, può aumentare la pressione sulla cache di pagina.
- vm.dirty_background_ratio / vm.dirty_ratio (o *_bytes): influenzano i tempi di writeback. Valori troppo elevati causano lunghi picchi di scrittura (picchi di wa), mentre valori troppo bassi aumentano i piccoli flush costanti (sy/bo in aumento).
- Scheduler I/O/Profondità della coda: Impostazioni Optima diverse su NVMe rispetto a HDD/RAID. Prima di apportare modifiche, misuro i compromessi tra latenza e velocità di trasferimento con iostat.
- Percorsi di rete: Molti piccoli pacchetti/interrupt affluiscono in /cs/sy. Le principali leve di ottimizzazione sono GRO/LRO, RPS/RFS, IRQ-Affinity: effettuo misurazioni prima e dopo.
Il mio obiettivo è ottenere andamenti stabili e prevedibili in vmstat: us/sy più stabili, wa/b più bassi, si/so vicini a 0. Solo allora procedo all'ampliamento dell'hardware.
Playbook: analisi in 3 minuti con vmstat
- 0:00–0:30 – „vmstat 1 30“: ignorare la prima riga, quindi esaminare r/b, us/sy/id/wa. Domanda: limite della CPU (r alto, id basso) o limite I/O (b/wa alti)?
- 0:30–1:00 – Controllo del serbatoio: verificare swpd e si/so. si/so costantemente > 0? → pressione effettiva del serbatoio. free irrilevante.
- 1:00–1:30 – Contesto I/O: bi/bo vs. wa. Valori elevati di bi/bo senza wa? → L’I/O viene disattivato. Valori elevati di wa con bi/bo moderati? → Latenza/Lock/I/O remoto.
- 1:30–2:00 – Sezione “system”: in/cs rispetto a sy. cs molto alto? → Verificare la pressione di cambio di contesto, il parallelismo/il locking.
- 2:00–3:00 – Definire l'ipotesi e scegliere lo strumento appropriato: iostat per l'indice I/O, mpstat per le asimmetrie del kernel, pidstat per i punti critici dei processi. Solo dopo si passa alla messa a punto e al ridimensionamento.
Esempi avanzati tratti dalla pratica
- Saturazione della CPU senza valori elevati di r: us+sy a 90%+, id ≈ 0, ma r moderato → hotspot single-thread o problema di affinità. Soluzione: parallelizzare il percorso critico, verificare il core-pinning.
- Swap-Thrash: in entrambi i casi, chiaramente > 0, b/wa in aumento, us in calo → RAM decisamente insufficiente o heap dimensionato in modo errato. Misure: aumentare la RAM, ridurre il working set, regolare lo swappiness.
- Overhead del kernel: sy alto, cs/in alto, us moderato → molte piccole chiamate di sistema/I/O. Soluzione: elaborazione in batch, riduzione delle chiamate di sistema, verificare le opzioni di montaggio del filesystem.
- Congestione dei writeback: wa alto, bo alto, onde corte → limiti "dirty" troppo elevati, latenza di archiviazione variabile. Verificare la messa a punto del writeback e lo scheduler I/O.
- Pressione della virtualizzazione: st visibile, r oscilla, id „salta“ → l’host condivide la CPU. Soluzione: verificare l’assegnazione/il posizionamento delle vCPU, ridurre l’overcommit.
Conoscere i limiti di vmstat
Vmstat è un eccellente Sensore di allarme preventivo, ma non è un microscopio. Mi mostra dove si verifica il blocco, ma non il singolo file responsabile, la query o il thread. Per questo motivo, dopo la diagnosi con vmstat, ricorro sistematicamente a strumenti più approfonditi, verifico le ipotesi da diverse angolazioni e poi modifico solo una cosa alla volta. In questo modo i miglioramenti rimangono misurabili e riproducibili.
Riepilogo dalla pratica
Con vmstat riesco a capire in pochi secondi se sono la CPU, la RAM, lo swap o l'I/O a rallentare il sistema, analizzando l'interazione tra r, b, si/so, bi/bo e us/sy/id/wa/st leggi. Valuto le tendenze anziché i singoli valori, effettuo confronti con i valori di riferimento e, se necessario, prendo in considerazione iostat, mpstat, pidstat e le misurazioni storiche. Ignoro la prima riga in caso di anomalie acute e mi concentro sulle righe successive con frequenza di campionamento fissa. Prendo decisioni basate sui dati: r rispetto ai core, si/so costantemente diversi da 0, wa persistentemente elevato, us+sy vicini al pieno carico. In questo modo deduco rapidamente misure concrete e mantengo i sistemi in condizioni ottimali reattivo.


