Vai al contenuto

Il cgroup di Linux Controller della CPU controlla la quantità di tempo di elaborazione assegnata a servizi, container e processi, consentendo una pianificazione mirata delle prestazioni. Ti spiego in modo concreto come interagiscono ponderazione, quote e pratiche, affinché tu possa assegnare il tempo di CPU in modo sicuro ed evitare colli di bottiglia.
Punti centrali
- ponderazione contro Limite capire: condivisione equa o limite massimo rigido
- cgroup v2 da privilegiare: semantica chiara, gerarchia coerente
- cpu.weight e cpu.max: le due leve di regolazione
- systemd Utilizzo: impostare regole per ciascun servizio
- Monitoraggio e Trasparenza: Leggere i dati di cpu.stat e PSI
Capire i cgroups: gruppi di processi e obiettivi
Riassumo i processi in Gruppi e gestisco tramite esso risorse quali CPU, memoria e I/O all’interno di gerarchie ben definite. Anziché destreggiarmi tra singoli PID, assegno servizi completi, container o pool di worker a un gruppo di controllo e stabilisco regole chiare. In questo modo impedisco che un’attività fuori controllo rallenti la macchina, mentre componenti importanti devono rispondere prontamente. Soprattutto nel contesto dell’hosting, questo approccio si rivela vantaggioso, poiché molti clienti e servizi girano sullo stesso hardware. Questo articolo offre una buona panoramica sull’applicazione pratica di questo concetto: cgroups e hosting, che rende comprensibile la ripartizione degli oneri.
Come funziona il controller della CPU
Il controller della CPU divide tempo di calcolo attraverso due meccanismi: la ponderazione relativa e la limitazione assoluta della larghezza di banda. La ponderazione significa che, non appena si crea una situazione di concorrenza, ai gruppi vengono assegnate quote di CPU in rapporto tra loro; i valori più alti ottengono quindi più spesso le fasce temporali. Un limite per quota limita il consumo in una finestra temporale fissa, anche in assenza di concorrenza. Scelgo la ponderazione quando l’equità e l’utilizzo dinamico delle risorse sono prioritari, mentre impiego le quote quando è necessario mantenere un limite massimo rigido e immutabile. La documentazione del kernel illustra chiaramente questa differenza e mostra come entrambi i meccanismi, insieme, diano vita a un modello di controllo coerente [1].
cgroup v1 vs. v2: differenze e file
Con cgroup v2 Gestisco le regole della CPU in modo più uniforme e chiaro rispetto alla precedente versione v1. Nella v1 utilizzavo file diversi per ogni controller; nella v2 mi concentro su `cpu.weight` per la priorità relativa e su `cpu.max` per un limite rigido di larghezza di banda. Questa chiara separazione riduce i tempi di configurazione, evita malintesi e facilita gli audit. Negli scenari di hosting con molti container, la gerarchia della v2 garantisce regole tracciabili a tutti i livelli. Una valutazione pratica è fornita dall’articolo su cgroup v2 nell'hosting, che tratta della gestione coerente in caso di hardware condiviso.
| Argomento | cgroup v1 | cgroup v2 | Parametri tipici |
|---|---|---|---|
| Ponderazione della CPU | cpu.shares | cpu.weight | cpu.weight (valore predefinito spesso 100) |
| Quota/limiti della CPU | cpu.cfs_quota_us + cpu.cfs_period_us | cpu.max | cpu.max (ad es. 20.000 100.000) |
| Gerarchia | Controller separati | Struttura ad albero unificata | Regole comuni per ciascun livello |
| In tempo reale | Controller rt separato | Limiti per RT | Vedi le note sul kernel [1] |
Per gli amministratori è importante che Coerenza Riduco gli errori nella configurazione e accelero l’applicazione delle modifiche. Documento i parametri sui nodi di gruppo, in modo che chiunque possa comprenderne l’effetto attuale. Nelle migrazioni dalla v1, verifico attentamente gli equivalenti, in particolare le quote «Share» relative a «Weight» e «CFS» relative a «cpu.max». Solo quando i carichi di prova reagiscono come previsto, trasferisco i servizi di produzione nella nuova gerarchia. Questa transizione disciplinata consente di risparmiare molti cicli di assistenza in seguito.
Gerarchia, sottoalberi e delega
In cgroup v2 gestisco i controller per livello e, se necessario, delegale a altri. Tramite cgroup.subtree_control attivo il controller CPU per i nodi figli; di norma systemd se ne occupa automaticamente quando imposto le proprietà della CPU. Importante: nella v2, idealmente mantengo i processi in Gruppi di foglie e non nei nodi intermedi. In questo modo le regole risultano più chiare e la distribuzione del carico segue chiaramente la struttura ad albero. In configurazioni complesse, assegno interi servizi alle slice (ad es. tenant-a.slice), tra cui servizi e pool di worker. Questa chiara separazione facilita la delega ai team che lavorano nei „propri“ sottotree, senza violare le politiche globali.
Parametri importanti: cpu.weight e cpu.max
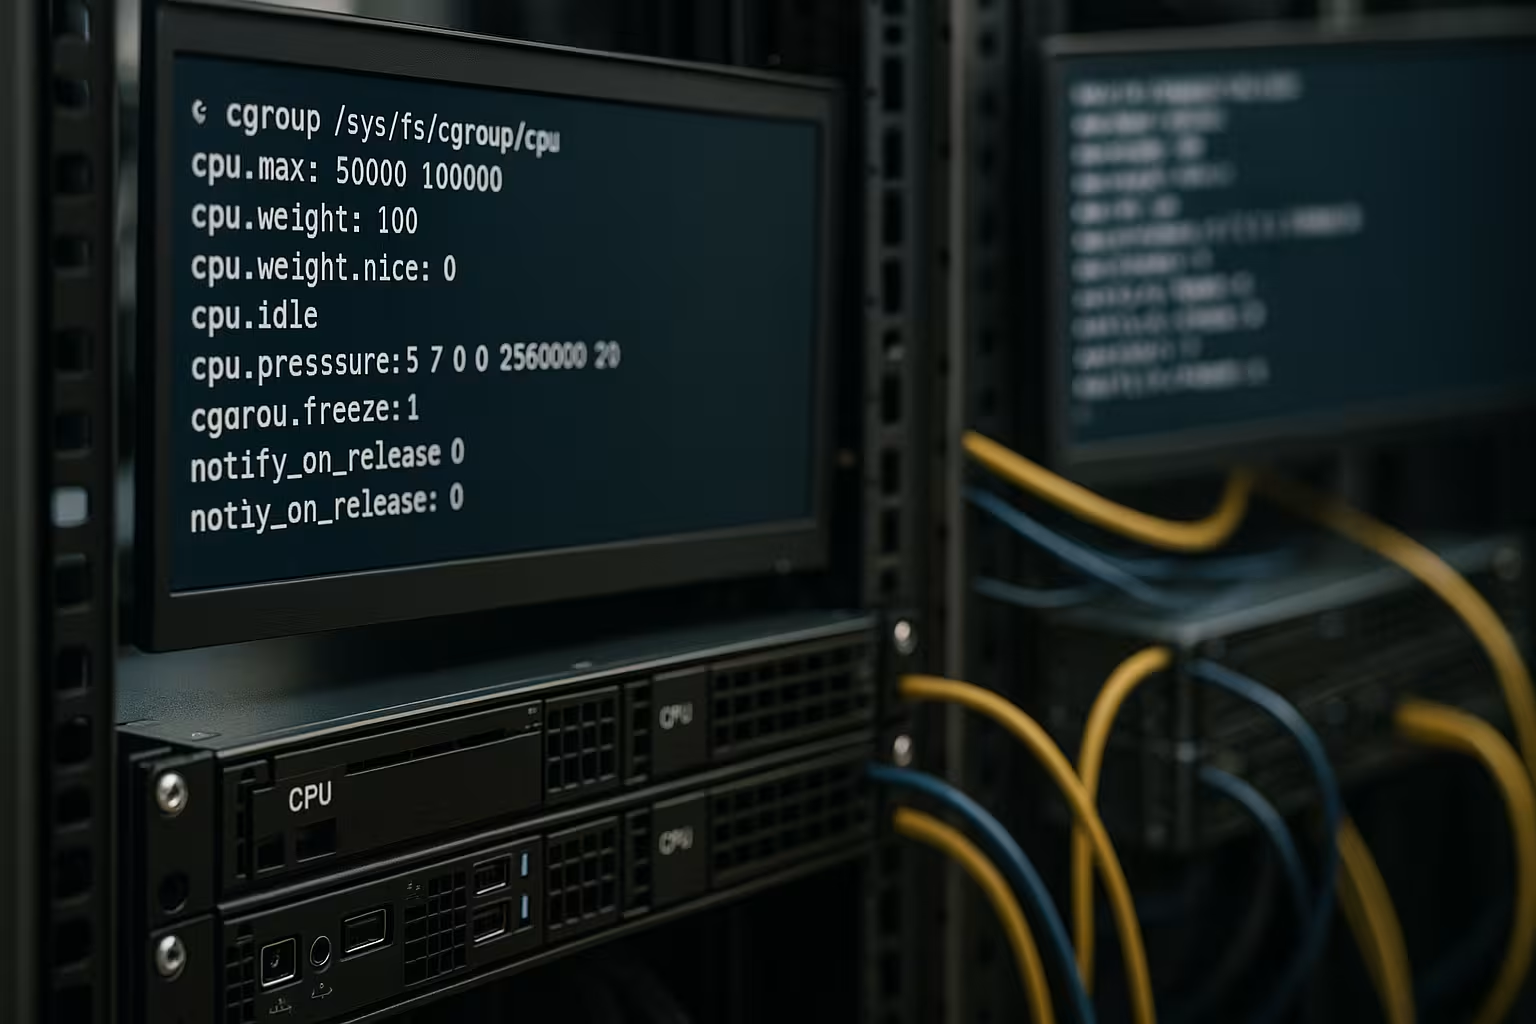
Uso cpu.weight, per assegnare priorità relative ai servizi: se al servizio A viene assegnato un peso maggiore rispetto al servizio B, in condizioni di carico A riceverà più spesso tempo di CPU. Il valore predefinito nella v2 è spesso 100; valori più alti favoriscono il gruppo in questione, ma io mi attengo a intervalli ragionevoli per mantenere il rapporto sotto controllo. Per l’imposizione di limiti rigidi scrivo in cpu.max una quota e un periodo, ad esempio 20000 100000 per circa il 20 per cento di uno slot vCPU. Con max Come prima cosa, elimino il limite massimo, ma mantengo il periodo, il che semplifica la diagnosi. Red Hat documenta in modo chiaro le impostazioni più comuni e ne illustra gli effetti durante il funzionamento [2].
Parametri aggiuntivi: cpu.weight.nice e UClamp
Per i team che partono dalla classica bello-Per quanto riguarda la semantica, la versione 2 offre cpu.weight.nice un ponte pratico: posso seguire gruppi nel settore -20..19 classificare, che viene mappato internamente sulla scala dei pesi. In questo modo le aspettative relative („preferire leggermente“, „ridurre leggermente“) rimangono coerenti, senza dover stabilire ogni volta pesi concreti. Inoltre, se necessario, applico Blocco dell'utilizzo via cpu.uclamp.min e cpu.uclamp.max, per impostare un limite minimo o massimo per l'utilizzo effettivo della CPU a livello di scheduler. In questo modo mi assicuro, ad esempio, che un servizio sensibile alla latenza non scenda al di sotto del carico di base richiesto anche in presenza di un numero ridotto di thread, oppure che i lavori batch non ricevano un boost eccessivo. Questa regolazione di precisione integra la ponderazione e le quote, ma non le sostituisce: valuto sempre come UClamp si integra con la mia politica di governance e di gestione energetica prima di implementarlo su larga scala.
Pianificazione dei carichi di lavoro: equità contro limiti rigidi
Decido consapevolmente se Equità oppure che abbiano la precedenza i limiti massimi rigidi. Per i servizi web in cui la latenza è fondamentale, aumento leggermente il peso in modo che vengano eseguiti in via prioritaria in caso di concorrenza, senza penalizzare eccessivamente altri gruppi. Per i lavori batch ad alta intensità di calcolo, imposto inoltre una quota affinché non occupino mai troppo tempo, anche se il sistema è altrimenti inattivo. Assegno un peso moderato ai database e osservo l’impatto di checkpoint, ricostruzioni o query di grandi dimensioni; se necessario, apporto modifiche temporanee. Combino queste regole con degli allarmi, in modo da poter reagire tempestivamente prima che le latenze aumentino.
Andamento delle quote su processori multicore e scelta del periodo
Un ostacolo frequente è l'interpretazione di Prestazioni sui sistemi multicore. Una quota si riferisce alla Tempo di calcolo totale del gruppo per periodo, non ai singoli nuclei. CPUQuota=200% oppure cpu.max = 200000 100000 Consentono all’incirca due secondi di CPU per periodo di 100 ms – distribuiti su tutti i thread/nuclei. Ciò può significare che molti thread vengano eseguiti in parallelo per un breve periodo, finché il gruppo non viene „esaurito“ nel periodo corrente e non viene limitato. Per evitare malintesi, penso sempre alle quote in termini di „slot CPU“ e le adatto al grado di parallelismo del servizio.
Il periodo standard è spesso pari a 100 ms. Periodi più brevi (z. B. (50 ms) rendono più rapida l'applicazione della limitazione, ma possono generare micro-jitter; periodi più lunghi smussano il fenomeno, ma reagiscono con maggiore lentezza. Con systemd regolo questo parametro con CPUQuotaPeriodSec= e verifico se si ottengono picchi di latenza migliori o se gli obiettivi di throughput vengono raggiunti in modo più efficace. Per i servizi interattivi misuro la latenza end-to-end, mentre per quelli batch mi baso sul throughput complessivo e sull’equità nei confronti dei vicini.
Esempio pratico: configurazione con systemd e cgroup v2
Con systemd imposto delle regole per ogni servizio, perché File di servizio consentire una configurazione riproducibile. Con systemctl set-property Le modifico continuamente e, grazie ai file drop-in, gestisco le versioni delle impostazioni in modo ordinato. Un esempio: systemctl set-property --runtime nginx.service CPUWeight=150 NGINX assegna facilmente le priorità; systemctl set-property --runtime batch.service CPUQuota=20% chiude i processi batch. Di solito inserisco in /etc/systemd/system/service.d/limits.conf Imposta le opzioni corrispondenti e ricarica le unità. Per un approccio pratico, vale la pena dare un’occhiata a questa guida su Controllo delle risorse di systemd, che riassume brevemente le opzioni più comuni.
# Esempi per systemd v245+ con cgroup v2
# Priorità relativa
systemctl set-property --runtime nginx.service CPUWeight=150

# Limite massimo rigido
systemctl set-property --runtime batch.service CPUQuota=20%

# Combinazione in un file drop-in
mkdir -p /etc/systemd/system/php-fpm.service.d
cat < /etc/systemd/system/php-fpm.service.d/cpu.conf
[Service]
CPUWeight=120
CPUQuota=50%
EOF
systemctl daemon-reload
systemctl restart php-fpm.service
Slices per tenant e team
Per i confini dei clienti o dei team utilizzo Fette come struttura organizzativa. Uno "slice" raggruppa diversi servizi e ambiti, che vengono regolati collettivamente. In questo modo assegno i budget per cliente senza dover gestire singolarmente ogni unità e delego le modifiche in modo controllato.
# Tenant-Slice con regole standard
mkdir -p /etc/systemd/system/tenant-a.slice.d
cat < /etc/systemd/system/tenant-a.slice.d/cpu.conf
[Slice]
CPUWeight=120
CPUQuota=150%
# Opzionale: periodo per una limitazione più precisa
CPUQuotaPeriodSec=100ms
EOF
systemctl daemon-reload
systemctl restart tenant-a.slice
Tutti i servizi su tenant-a.slice ereditano queste impostazioni. In caso di picchi di breve durata, aumento temporaneamente il peso, ma mantengo stabile la quota, in modo che i sistemi vicini non vengano soppiantati.
Monitoraggio e risoluzione dei problemi
Verifico l'efficacia e gli effetti collaterali con Trasparenza in metriche. I file cpu.stat e cpu.pressure (PSI) per ogni cgroup mi fornisce le quote, i tempi di attesa e i colli di bottiglia che indicano una limitazione o un sovraccarico. Con top, htop e systemd-cgtop Individuo in tempo reale le tendenze di distribuzione e le confronto con le mie regole. Se le latenze aumentano ma la CPU è inattiva, il problema è più probabilmente dovuto all’I/O o ai blocchi piuttosto che ai limiti della CPU; in tal caso non modifico la ponderazione in modo affrettato. Dopo aver apportato modifiche, documento i valori misurati per almeno un ciclo di carico, in modo da evitare correlazioni errate.
Manuale di monitoraggio: cosa leggo concretamente
cpu.stat: usage_usec, user_usec, system_usec mostrano il consumo; nr_periods, nr_throttled, throttled_usec smascherano una forte riduzione. Aumenta nr_throttled/nr_periods Se la variazione supera una certa percentuale, l’intervallo è troppo ristretto o il periodo troppo breve.cpu.pressure: Osservo alcuni valori medi 10/60/300 per i colli di bottiglia rilevanti in termini di latenza. Un valore costantemente elevato nonostante le CPU siano libere indica contese sui lock, conflitti di affinità o accessi remoti NUMA.systemd-cgtopeps: Verifico se i thread possano davvero funzionare in parallelo o se debbano attendere risorse esclusive.
Per eseguire test riproducibili, utilizzo stress-ng, sysbench oppure utilizzo generatori di carico propri e acquisisco snapshot delle metriche prima e dopo. Solo quando i valori misurati si attestano stabilmente in linea con le aspettative, procedo all'implementazione delle modifiche.
Tempo reale e caratteristiche particolari
All'indirizzo In tempo reale-Per i carichi di lavoro, seguo le indicazioni della documentazione del kernel, poiché la versione v2 gestisce il controller della CPU per RT solo in modo limitato. Alcuni thread RT devono trovarsi nel cgroup root e la configurazione richiede un approccio prudente. Verifico inoltre come la schedulazione RT si concili con le quote, in modo che nessuna scadenza venga inavvertitamente superata. Per i tipici servizi web e di database utilizzo politiche standard, poiché questa configurazione garantisce una maggiore prevedibilità nell’uso quotidiano. Quando ho bisogno di RT, isolo i sistemi o riservo chiaramente i core, in modo da evitare interazioni impreviste [1].
Controllo di precisione su sistemi multi-core
Il controller della CPU divide Finestra temporale, non la frequenza di clock, quindi, se necessario, lo combino con cpuset e l’affinità. Per ottenere una latenza bassa, limito i cambi tra socket, associo i thread ai core locali NUMA e ottimizzo la distribuzione degli IRQ. Lascio che i servizi batch funzionino in modo più flessibile, in modo che possano sfruttare la capacità residua senza bloccare i core destinati ai front-end critici. Verifico le politiche Turbo o Powersave, poiché le variazioni di frequenza possono alterare notevolmente il comportamento sotto carico. Solo la somma di quote, pesi, affinità della CPU e strategia energetica fornisce risultati coerenti.
SMT, NUMA e affinità nella pratica
Su sistemi con SMT/ Hyper-Threading Faccio notare che due thread logici su un core fisico non corrispondono a due slot CPU completi. Una quota di „100 %“ copre uno slot logico, non necessariamente la piena potenza di un core fisico. Misuro quindi la latenza e il throughput con e senza l’utilizzo di SMT. Nei sistemi NUMA, limito i servizi critici con AllowedCPUs= (cpuset) oppure CPUAffinity= su nuclei locali e configura il binding di memoria di conseguenza, in modo che gli accessi remoti non compromettano tutta la pianificazione dettagliata.
Migliori pratiche per l'hosting e i container
Inizio con un moderato Impostazioni predefinite: Assegnare un peso leggermente superiore ai servizi web, database vicini allo standard, elaborazione batch con quota. Per i tenant imposto limiti massimi per cliente e consento picchi di carico tramite la ponderazione, purché non vi siano altre esigenze. Documento i profili in base al caso d’uso, ad esempio „sensibile alla latenza“, „misto“ e „ad alto carico di calcolo“, e definisco per ogni profilo intervalli chiari per weight e cpu.max. Testo le modifiche prima nell’ambiente di staging con un carico sintetico che riproduca in modo realistico i picchi. Mantengo i log e le metriche vicini ai limiti dei cgroup, in modo che le diagnosi non finiscano nel vago.
Orchestrazione dei container: condivisioni, richieste e limiti
Negli ambienti container mappo Richieste sulla ponderazione relativa e Limiti con quote rigide. Ciò consente i picchi di carico fintanto che i nodi dispongono di capacità libera e garantisce, in condizioni di concorrenza, una distribuzione equa in base al peso. Ai pod o ai servizi critici viene assegnato un peso leggermente superiore, senza che i limiti limitino le risorse degli altri. Mi assicuro che la somma dei limiti per nodo sia realistica rispetto alla CPU disponibile; altrimenti, nonostante regole chiare, si verificherebbe una limitazione a livello di sistema che colpirebbe tutti i tenant.
Configurazioni di esempio ed esempi di calcolo
Calcolo sempre le quote in Azioni per ogni slot vCPU: cpu.max = PERIODO DI QUOTA corrisponde a QUOTA/PERIODO dello slot. Esempio: 20000 100000 sono pari a 0,2 per una singola CPU; su quattro CPU, la distribuzione massima è di 0,8 slot complessivi, ma non è garantita. Per le percentuali in systemd scrivo CPUQuota=20%, che, a seconda della versione, è in armonia con cpu.max. Chi imposta limiti rigidi deve valutare il comportamento in burst rispetto alla latenza: un periodo troppo stretto può causare micro-scatti, mentre uno troppo ampio distribuisce il carico in modo più uniforme, ma reagisce con maggiore lentezza. Provo quindi periodi compresi tra 50 e 100 ms e scelgo la variante che si adatta alla classe di latenza del servizio [2].
Migrazione da v1 a v2 senza sorprese
Durante il cambio di linea, mi sposto cpu.shares in cpu.weight e cpu.cfs_quota_us/period_us in cpu.max. Una mappatura pragmatica per gli “share” è la seguente: 1024 → ~100, 2048 → ~200, 512 → ~50. Effettuo le correzioni di precisione dopo i test di carico, poiché le scale sono diverse. Ho inoltre in programma di applicare le regole della v2 ai bambini cumulativo effetto: una quota restrittiva al nodo padre limita tutti i sottogruppi nel loro insieme. Per questo motivo spesso elimino le quote dei genitori (max) e regolo in modo granulare i fogli, in modo da evitare effetti collaterali.
Errori comuni e soluzioni
- 100 % confuso con „tutti i nuclei“: 100 % corrispondono a uno slot logico della CPU, non all’intera macchina. Soluzione: calcolare la quota in base agli slot necessari (ad es. 400 % per quattro slot).
- Ciclo mestruale troppo breve: Piccoli scatti nei servizi interattivi. Soluzione: aumentare il periodo oppure utilizzare il peso anziché la quota.
- Ponderazione misurata in assenza di concorrenza: Il peso produce effetti solo in condizioni di competizione. Soluzione: eseguire prove con un carico parallelo reale.
- Dimenticate le quote per i genitori: Un genitore con limitazioni limita tutti i figli. Soluzione:
cpu.max=maxsul genitore, limiti sulle foglie. - NUMA/socket ignorati: Latenza nonostante la CPU sia libera. Soluzione: verificare l'affinità/i CPUSet e la località della memoria.
Sintesi
Con il Controller della CPU Assegno il tempo di calcolo in modo mirato, stabilisco priorità eque e impongo limiti rigidi dove necessario. cgroup v2 offre parametri chiari come cpu.weight e cpu.max, che pianifico e misuro in base al carico di lavoro. Tramite systemd definisco regole per ogni servizio, ne verifico l’efficacia con cpu.stat e PSI e le aggiusto senza ricorrere a supposizioni. Per tenant, container e ambienti server misti, questo controllo rimane fondamentale per garantire affidabilità e prevedibilità. Chi documenta le regole, le introduce gradualmente e le verifica con test di carico, previene i colli di bottiglia e mantiene il controllo sul tempo di CPU.