Ga naar de inhoud

De Linux cgroup CPU-controller bepaalt hoeveel rekentijd diensten, containers en processen krijgen, en maakt het mogelijk om de prestaties doelgericht te plannen. Ik leg concreet uit hoe weging, quota en werkwijzen op elkaar inwerken, zodat je CPU-tijd op een veilige manier kunt toewijzen en knelpunten kunt voorkomen.
Centrale punten
- weging versus Beperk begrijpen: eerlijk verdelen of een strikte bovengrens
- cgroep v2 voorkeur: duidelijke betekenis, consistente hiërarchie
- cpu.gewicht en cpu.max: de twee bedieningshendels
- systemd Gebruik: regels per dienst instellen
- Controle en Transparantie: cpu.stat en PSI lezen
cgroups begrijpen: procesgroepen en doelen
Ik vat processen samen in Groepen samen en beheer daarmee resources zoals CPU, geheugen en I/O in duidelijk afgebakende hiërarchieën. In plaats van met afzonderlijke PID’s te jongleren, wijs ik complete diensten, containers of worker-pools toe aan een Control Group en stel ik duidelijke regels vast. Zo voorkom ik dat een uit de hand gelopen taak de machine vertraagt, terwijl belangrijke componenten moeten reageren. Juist in een hostingcontext loont deze aanpak de moeite, omdat veel klanten en diensten op dezelfde hardware draaien. Dit artikel biedt een goed overzicht van de praktische toepassing: cgroups en hosting, die de verdeling van de lasten begrijpelijk maakt.
Hoe de CPU-controller werkt
De CPU-controller verdeelt rekenkracht via twee mechanismen: relatieve weging en absolute bandbreedtebeperking. Weging houdt in dat groepen, zodra er concurrentie ontstaat, CPU-aandelen krijgen in verhouding tot elkaar; hogere waarden krijgen dan vaker tijdssegmenten toegewezen. Een limiet per quotum beperkt het verbruik binnen een vast tijdsvenster, zelfs als er geen concurrentie is. Ik kies voor weging wanneer eerlijkheid en dynamische benutting voorop staan, en stel quota in wanneer een strikte bovengrens onveranderlijk moet blijven. De kernel-documentatie legt dit verschil duidelijk uit en laat zien hoe beide mechanismen samen een samenhangend besturingsmodel vormen [1].
cgroup v1 versus v2: verschillen en bestanden
Met cgroep v2 Beheer ik CPU-regels op een uniforme en overzichtelijkere manier dan bij de oudere v1-variant. In v1 gebruikte ik verschillende bestanden per controller; in v2 concentreer ik me op `cpu.weight` voor relatieve prioriteit en `cpu.max` voor een harde bandbreedtelimiet. Deze duidelijke scheiding verkort de installatietijd, voorkomt misverstanden en vergemakkelijkt audits. In hostingscenario’s met veel containers zorgt de v2-hiërarchie voor traceerbare regels op alle niveaus. Een beoordeling van de praktijk wordt gegeven in het artikel over cgroup v2 bij hosting, waarin wordt ingegaan op consistente besturing bij gezamenlijk gebruik van hardware.
| Onderwerp | cgroup v1 | cgroep v2 | Typische parameters |
|---|---|---|---|
| CPU-weging | cpu.aandelen | cpu.gewicht | cpu.gewicht (Standaard vaak 100) |
| CPU-quota/limieten | cpu.cfs_quota_us + cpu.cfs_period_us | cpu.max | cpu.max (bijv. 20.000 100.000) |
| Hiërarchie | Afzonderlijke controllers | Uniforme boomstructuur | Gemeenschappelijke regels per niveau |
| Echte tijd | Aparte rt-controller | Beperkingen voor RT | Zie opmerkingen over de kernel [1] |
Voor beheerders is het van belang dat Consistentie Fouten in de configuratie verminderen en wijzigingen sneller doorvoeren. Ik documenteer parameters op de groepsnodes, zodat iedereen het huidige effect kan zien. Bij migraties vanuit v1 controleer ik zorgvuldig de equivalenten, met name ‘Shares’ ten opzichte van ‘Weight’ en ‘CFS-Quota’ ten opzichte van ‘cpu.max’. Pas wanneer testbelastingen naar verwachting reageren, verplaats ik productieve diensten naar de nieuwe hiërarchie. Deze gedisciplineerde overgang bespaart later veel supportcycli.
Hiërarchie, subbomen en delegatie
In cgroup v2 beheer ik controllers per niveau en delegeer ze indien nodig verder. Via cgroup.subtree_control schakel ik de CPU-controller voor onderliggende knooppunten in; systemd regelt dit doorgaans automatisch wanneer ik CPU-eigenschappen instel. Belangrijk: in v2 houd ik processen idealiter in Bladgroepen en niet in tussenliggende knooppunten. Zo blijven de regels eenduidiger en volgt de lastverdeling duidelijk de boomstructuur. In complexe opstellingen wijs ik hele diensten aan slices toe (bijv. tenant-a.slice), waaronder services en worker-pools. Deze duidelijke scheiding maakt het gemakkelijker om taken te delegeren aan teams die in „hun“ subtrees werken, zonder dat daarbij de algemene beleidsregels worden geschonden.
Belangrijke parameters: cpu.weight en cpu.max
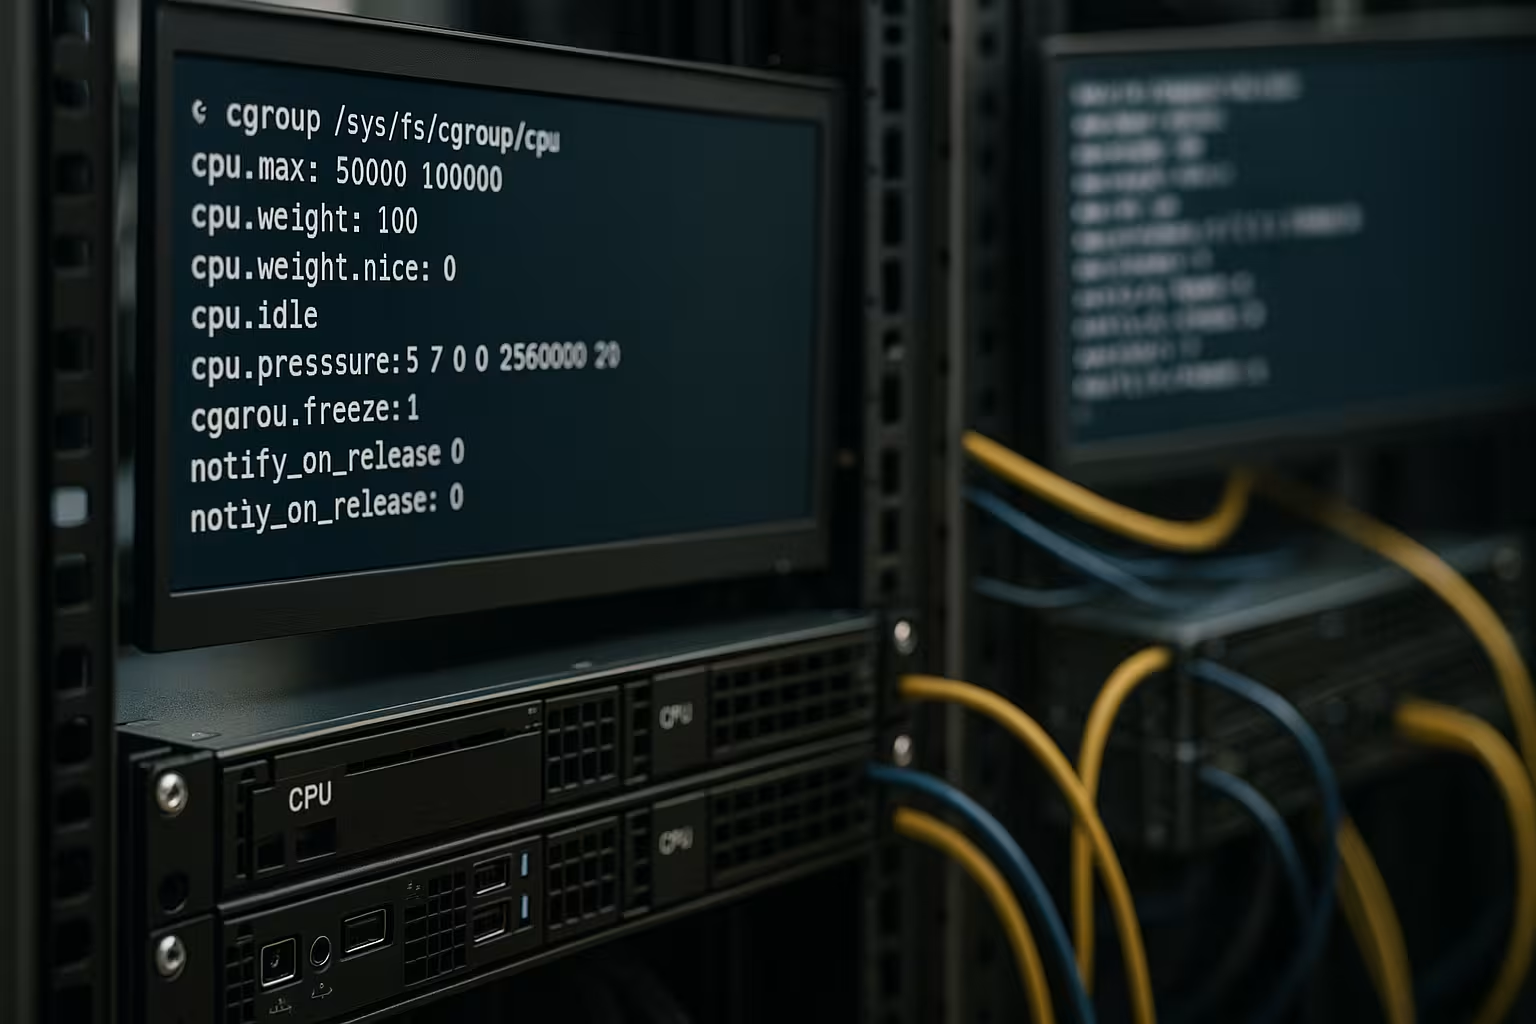
Ik gebruik cpu.gewicht, om diensten relatief te prioriteren: als dienst A een hoger gewicht krijgt dan dienst B, krijgt A bij hoge belasting vaker CPU-tijd toegewezen. De standaardwaarde in v2 is vaak 100; hogere waarden geven de voorkeur aan de betreffende groep, maar ik blijf binnen redelijke marges om de verhouding beheersbaar te houden. Voor harde limieten schrijf ik in cpu.max een quotum en een periode, bijvoorbeeld 20000 100000 voor ongeveer 20 procent van een vCPU-slot. Met max Als eerste schrap ik de limiet, maar laat ik de periode staan, wat de diagnose vereenvoudigt. Red Hat documenteert gangbare instellingen op een begrijpelijke manier en laat zien wat de gevolgen zijn tijdens het gebruik [2].
Aanvullende instellingsparameters: cpu.weight.nice en UClamp
Voor teams die de klassieke nice-semantiek betreft, biedt v2 met cpu.weight.nice een praktische brug: ik kan groepen begeleiden op het gebied van -20..19 indelen, die intern wordt omgezet naar de gewichtsschaal. Zo blijven relatieve verwachtingen („een beetje de voorkeur geven“, „iets afremmen“) consistent, zonder dat er telkens concrete gewichten moeten worden vastgesteld. Bovendien pas ik, indien nodig, Klemmen voor gebruik via cpu.uclamp.min en cpu.uclamp.max, om een minimum- of maximumgrens voor de effectieve CPU-bezetting op schedulerniveau vast te stellen. Zo zorg ik er bijvoorbeeld voor dat een latentiegevoelige dienst, zelfs bij een laag aantal threads, niet onder de vereiste basisbelasting zakt, of dat batch-taken geen te hoge boost krijgen. Deze fijnafstemming vormt een aanvulling op weging en quota, maar vervangt deze niet: ik meet altijd hoe UClamp samengaat met mijn governor- en energiebeleid, voordat ik het op grote schaal implementeer.
Planning voor workloads: eerlijkheid versus strikte grenzen
Ik beslis bewust of Eerlijkheid of strikte bovengrenzen voorrang krijgen. Voor webdiensten waarbij latentie van cruciaal belang is, verhoog ik het gewicht lichtjes, zodat ze bij concurrentie voorrang krijgen zonder andere groepen buitensporig te benadelen. Voor rekenintensieve batch-taken stel ik bovendien een quotum in, zodat ze nooit te veel tijd in beslag nemen, zelfs als het systeem verder inactief is. Databases geef ik een gematigde weging en ik houd in de gaten hoe checkpoints, rebuilds of grote query’s uitpakken; indien nodig pas ik dit tijdelijk aan. Deze regels combineer ik met alarmen, zodat ik vroegtijdig kan reageren voordat de latentie escaleert.
Prestatieverloop op multicore-processoren en keuze van de periode
Een veelvoorkomend struikelblok is de interpretatie van Prestaties op multicore-systemen. Een quotum heeft betrekking op de Totale rekentijd van de groep per periode, niet op afzonderlijke kernen. CPUQuota=200% of cpu.max = 200.000 100.000 laten grofweg twee CPU-seconden per periode van 100 ms toe – verdeeld over alle threads/kernen. Dit kan betekenen dat veel threads kortstondig parallel draaien, totdat de groep in de huidige periode „opgebruikt“ is en wordt afgeremd. Ik voorkom misverstanden door quota altijd in „CPU-slots“ te beschouwen en deze aan te passen aan de mate van parallelliteit van de dienst.
De standaardperiode bedraagt vaak 100 ms. Kortere periodes (z. B. (50 ms) zorgen ervoor dat de beperking sneller ingrijpt, maar kunnen microjitter veroorzaken; langere perioden zorgen voor een gelijkmatiger verloop, maar reageren trager. Onder systemd pas ik dit aan met CPUQuotaPeriodSec= en controleer of latentiepieken of doorvoercijfers beter worden gehaald. Voor interactieve diensten meet ik de end-to-end-latentie; voor batchverwerking richt ik me op de totale doorvoer en eerlijkheid ten opzichte van buren.
Praktijk: Configuratie met systemd en cgroup v2
In systemd stel ik regels per dienst in, omdat Dienstbestanden een reproduceerbare configuratie mogelijk maken. Met systemctl set-property Ik pas ze voortdurend aan en gebruik drop-in-bestanden om de instellingen netjes te versioneren. Een voorbeeld: systemctl set-property --runtime nginx.service CPUWeight=150 NGINX geeft licht voorrang; systemctl set-property --runtime batch.service CPUQuota=20% sluit batch-taken af. Ik voer dit permanent in /etc/systemd/system/service.d/limits.conf Stel de betreffende opties in en herlaad de eenheden. Om er op een praktische manier mee aan de slag te gaan, is het de moeite waard om deze handleiding eens te bekijken systemd-Resource-Control, waarin de meest voorkomende opties kort worden samengevat.
# Voorbeelden voor systemd v245+ met cgroup v2
# Relatieve prioritering
systemctl set-property --runtime nginx.service CPUWeight=150

# Harde bovengrens
systemctl set-property --runtime batch.service CPUQuota=20%

# Combinatie in een drop-in-bestand
mkdir -p /etc/systemd/system/php-fpm.service.d
cat < /etc/systemd/system/php-fpm.service.d/cpu.conf
[Service]
CPUWeight=120
CPUQuota=50%
EOF
systemctl daemon-reload
systemctl restart php-fpm.service
Slices voor tenants en teams
Voor cliënt- of teamgrenzen gebruik ik Plakjes als organisatorisch kader. Een ‘slice’ omvat meerdere services en scopes die gezamenlijk worden gereguleerd. Zo wijs ik budgetten per klant toe zonder elke eenheid afzonderlijk te hoeven bijwerken, en delegeer ik wijzigingen op een gecontroleerde manier.
# Tenant-slice met standaardregels
mkdir -p /etc/systemd/system/tenant-a.slice.d
cat < /etc/systemd/system/tenant-a.slice.d/cpu.conf
[Slice]
CPUWeight=120
CPUQuota=150%
# Optioneel: periode voor fijnere beperking
CPUQuotaPeriodSec=100ms
EOF
systemctl daemon-reload
systemctl restart tenant-a.slice
Alle diensten op tenant-a.slice nemen deze instellingen over. Bij kortstondige pieken verhoog ik het gewicht tijdelijk, maar laat ik de verhouding stabiel, zodat aangrenzende systemen niet worden verdrongen.
Monitoring en probleemoplossing
Ik controleer de werking en bijwerkingen met Transparantie in statistieken. De bestanden cpu.stat en cpu.pressure (PSI) per cgroup krijg ik het gebruik, de wachttijden en de files te zien, die wijzen op beperking of overbelasting. Met top, htop en systemd-cgtop Ik signaleer realtime trends in de verdeling en toets deze aan mijn regels. Als de latentie toeneemt terwijl de CPU inactief is, ligt het probleem eerder bij I/O of locks dan bij CPU-limieten; ik pas de weging dan niet overhaast aan. Na wijzigingen documenteer ik de meetwaarden gedurende ten minste één belastingscyclus, zodat ik verkeerde correlaties vermijd.
Monitoring-handleiding: wat ik concreet lees
cpu.stat: usage_usec, user_usec, system_usec verbruik weergeven; nr_perioden, nr_throttled, throttled_usec ontmaskeren een forse beperking. Stijgt nr_throttled/nr_periods meer dan een paar procent, dan is het percentage te krap of de periode te kort.cpu.pressure: Ik kijk toe enkele gemiddelden: 10/60/300 voor latentie-gerelateerde bottlenecks. Een aanhoudend hoge waarde ondanks beschikbare CPU’s duidt op lock-contention, affiniteitsconflicten of NUMA-toegang op afstand.systemd-cgtopenps: Ik controleer of threads daadwerkelijk parallel kunnen werken of dat ze moeten wachten op exclusieve bronnen.
Voor reproduceerbare tests gebruik ik stress-ng, sysbench of eigen belastinggeneratoren en leg voor en na meetgegevens vast. Pas als de meetwaarden stabiel aan de verwachtingen voldoen, voer ik de wijzigingen door.
Realtime en bijzonderheden
Op Echte tijd-Wat de workloads betreft, houd ik me aan de aanwijzingen in de kernel-documentatie, aangezien v2 de CPU-controller voor RT slechts in beperkte mate beheert. Bepaalde RT-threads moeten in de root-cgroup staan, en de configuratie vereist een zorgvuldige aanpak. Ik controleer bovendien hoe RT-scheduling samengaat met quota’s, zodat geen enkele deadline onbedoeld overschreden wordt. Voor typische web- en databasediensten gebruik ik normale beleidsregels, omdat deze opstelling in de dagelijkse praktijk beter te plannen is. Als ik RT nodig heb, scheid ik systemen of reserveer ik cores duidelijk, zodat er geen onverwachte interacties optreden [1].
Fijnregeling op multi-core-systemen
De CPU-controller verdeelt Tijdvenster, niet de kloksnelheid, daarom combineer ik het indien nodig met cpuset en affiniteit. Voor een lage latentie beperk ik het wisselen tussen sockets, koppel ik threads aan NUMA-lokale kernen en optimaliseer ik de IRQ-verdeling. Ik laat batch-services flexibeler draaien, zodat ze resterende capaciteit kunnen benutten zonder kernen voor kritieke frontends te blokkeren. Ik controleer turbo- of energiebesparingsbeleidsregels, omdat frequentiewijzigingen het gedrag onder belasting sterk kunnen beïnvloeden. Pas de som van quota’s, wegingen, CPU-affiniteit en energiestrategie levert consistente resultaten op.
SMT, NUMA en affiniteit in de praktijk
Op systemen met SMT/Hyper-Threading Ik merk op dat twee logische threads op één fysieke kern niet twee volledige CPU-slots opleveren. Een quotum van „100 %“ dekt één logisch slot, niet per se de volledige capaciteit van een fysieke kern. Daarom meet ik de latentie en doorvoer met en zonder SMT-gebruik. Bij NUMA-systemen beperk ik kritieke diensten met AllowedCPUs= (cpuset) of CPUAffiniteit= op lokale kernen en stel de geheugentoewijzing dienovereenkomstig in, zodat toegang op afstand niet alle gedetailleerde planning tenietdoet.
Best practices voor hosting en containers
Ik begin met matig Standaard: Webdiensten iets zwaarder wegen, databases bijna standaard, batch met quotum. Voor tenants stel ik bovengrenzen per klant in en sta ik pieken toe via weging, zolang er geen andere behoefte is. Ik documenteer profielen op basis van use-cases, zoals „latentiekritisch“, „gemengd“ en „rekenintensief“, en stel per profiel duidelijke marges vast voor weight en cpu.max. Wijzigingen test ik eerst in de staging-omgeving en met een synthetische belasting die de pieken realistisch weergeeft. Ik houd logs en metrics dicht bij de cgroup-grenzen, zodat diagnoses niet in het duister blijven.
Container-orkestratie: shares, requests en limieten
In containeromgevingen kaart ik Verzoeken op relatieve weging en Grenzen op strenge quota. Dit maakt bursts mogelijk zolang knooppunten vrije capaciteit hebben, en zorgt bij concurrentie voor een eerlijke verdeling op basis van het gewicht. Kritieke pods of services krijgen iets meer gewicht, zonder dat limieten anderen de ruimte ontnemen. Ik zorg ervoor dat de som van de limieten per node realistisch aansluit bij de beschikbare CPU-capaciteit; anders ontstaat er ondanks duidelijke regels een systeemwijde beperking die alle tenants treft.
Voorbeeldconfiguraties en rekenvoorbeelden
Ik reken quota altijd om naar Aandelen per vCPU-slot: cpu.max = QUOTA-PERIODE komt overeen met QUOTA/PERIODE van de slotmachine. Voorbeeld: 20000 100000 is 0,2 van een enkele CPU; over vier CPU’s verdeeld is dat maximaal 0,8 totale slot, maar dit is niet gegarandeerd. Voor percentages onder systemd schrijf ik CPUQuota=20%, wat, afhankelijk van de versie, overeenkomt met cpu.max. Wie strikte grenzen stelt, moet het burst-gedrag afwegen tegen de latentie: een te korte periode kan microhaperingen veroorzaken, een te lange periode zorgt voor een vloeiendere verdeling, maar reageert trager. Ik test daarom perioden tussen 50 en 100 ms en kies de variant die past bij de latentieklasse van de dienst [2].
Migratie van v1 naar v2 zonder verrassingen
Bij het overstappen breng ik cpu.aandelen in cpu.gewicht en cpu.cfs_quota_us/period_us in cpu.max. Een pragmatische indeling voor shares is: 1024 → ~100, 2048 → ~200, 512 → ~50. Fijnafstellingen voer ik uit na belastingstests, omdat de schalen van elkaar verschillen. Ik ben bovendien van plan om v2-regels voor kinderen in te voeren cumulatief werking: een beperkende quota op het bovenliggende knooppunt beperkt alle subgroepen samen. Daarom schrap ik vaak bovenliggende quota (max) en pas de granulariteit in de lagen nauwkeurig aan, zodat ik neveneffecten vermijd.
Veelvoorkomende fouten en oplossingen
- 100 % verward met „alle kernen“: 100 % komt overeen met één logisch CPU-slot, niet met de gehele machine. Oplossing: bereken het aantal op basis van het aantal benodigde slots (bijv. 400 % voor vier slots).
- Te korte cyclus: Kleine haperingen bij interactieve diensten. Oplossing: de periode verlengen of het gewicht in plaats van het quotum gebruiken.
- Weging gemeten zonder concurrentie: Het gewicht heeft pas effect tijdens wedstrijden. Oplossing: testritten uitvoeren met een reële parallelle belasting.
- Vergeet de oudersquota: Een beperkte ouder remt alle kinderen af. Oplossing:
cpu.max=maxop de hoofdtak, takken op de zijtakken. - NUMA/socket genegeerd: Latentie ondanks vrije CPU. Oplossing: controleer affiniteit/CPUSets en geheugenlokaliteit.
Samenvatting
Met de CPU-controller Ik wijs rekenkracht doelgericht toe, stel eerlijke prioriteiten vast en leg strenge grenzen op waar dat nodig is. cgroup v2 biedt hiervoor duidelijke parameters met cpu.weight en cpu.max, die ik afhankelijk van de werklast plan en meet. Via systemd stel ik regels per dienst in, controleer ik het effect met cpu.stat en PSI en pas ik deze aan zonder giswerk. Voor tenants, containers en gemengde serverlandschappen blijft deze regeling een sleutel tot het bereiken van betrouwbaarheid en voorspelbaarheid. Wie regels documenteert, stapsgewijs invoert en met belastingstests valideert, voorkomt knelpunten en behoudt de controle over de CPU-tijd.