
CloudLinux-rapporten geven mij een duidelijk beeld van welke LVE-limieten voor afzonderlijke accounts gelden en waar CPU, geheugen, I/O of entry-processen daadwerkelijk voor vertraging zorgen. Ik bestudeer deze gegevens doelgericht om terugkerende fouten, dagelijkse patronen en acute knelpunten te herkennen en daaruit concrete optimalisaties af te leiden.
Centrale punten
Ik vat de volgende kernpunten alvast samen, zodat je de analyse doelgericht kunt beginnen.
- LVE-kerncijfers lees goed: SPEED, MEM, IO, IOPS, PNO, EP
- Live-gegevens controleren met LVE Manager en lvetop
- Verloop via lveinfo, lvechart, cloudlinux-statistics
- Fouten prioriteren: frequentie, tijdstip, oorzaak
- Maatregelen afleiden voor CPU, RAM, I/O, EP
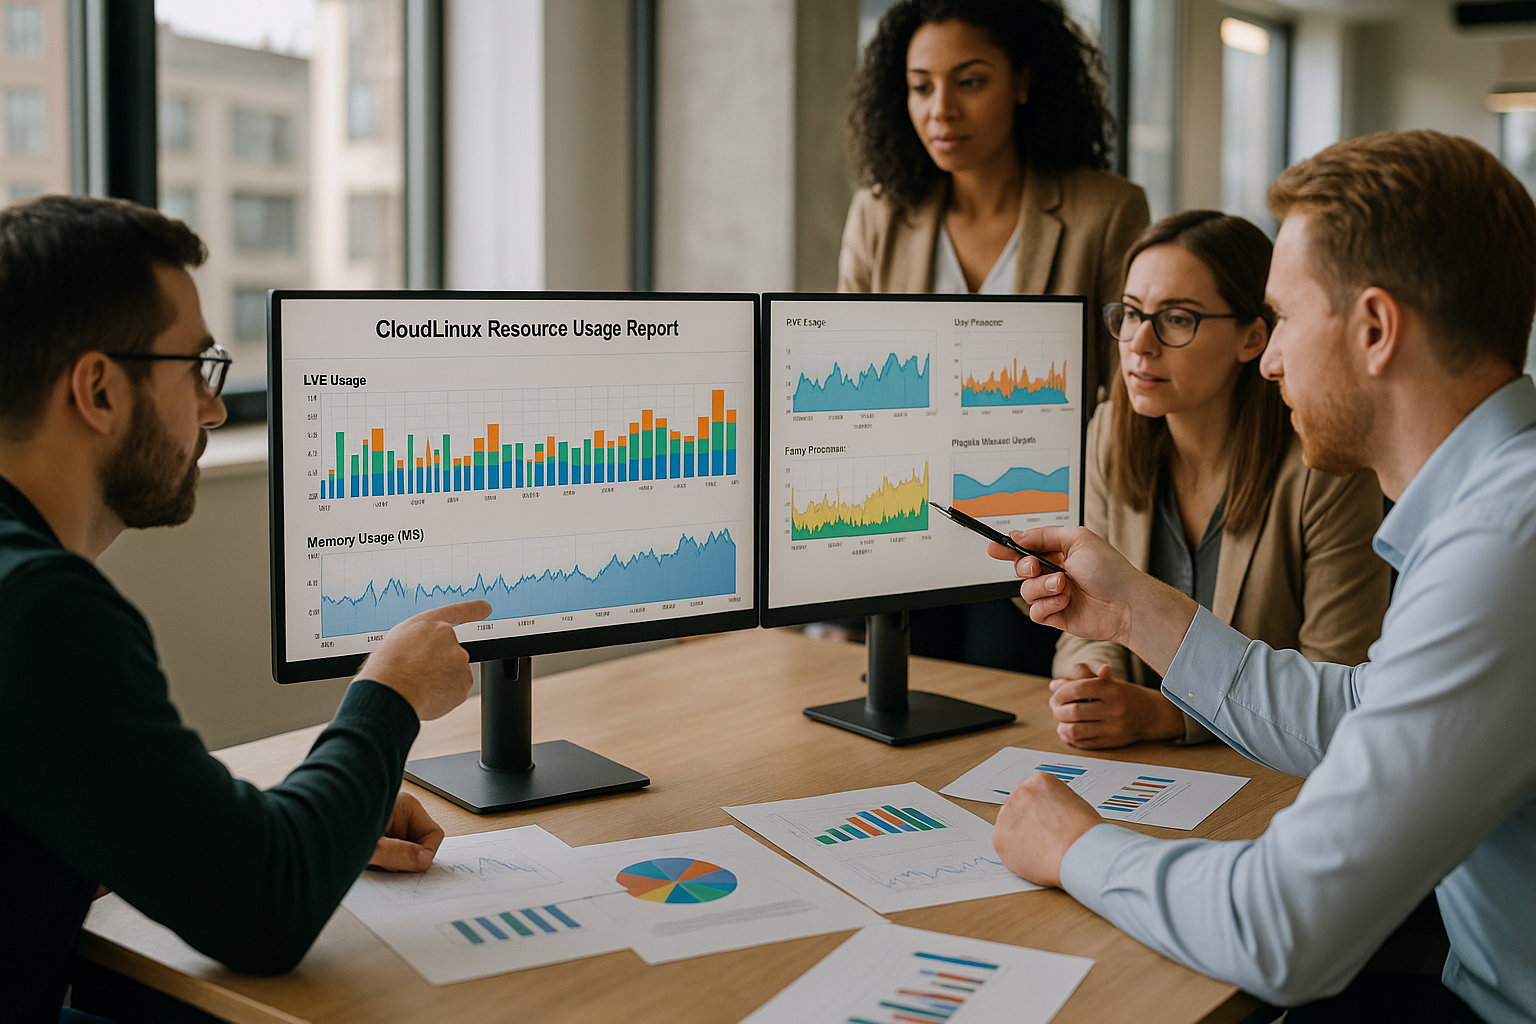
De juiste prestatie-indicatoren interpreteren: SPEED, MEM, IO, IOPS, PNO, EP
Ik begin elke analyse met de Belangrijke cijfers, die CloudLinux in de LVE-context weergeeft. SPEED beschrijft de toegewezen CPU-rekenkracht, MEM staat voor het RAM-gebruik, IO voor de gegevensdoorvoer en IOPS voor het aantal I/O-bewerkingen. PNO geeft het totale aantal actieve processen weer, EP de gelijktijdige Entry Processes die de webtoegang beperken. Wie voortdurend hoge waarden ziet, heeft meestal geen tijdelijk piekprobleem, maar een structureel belastingsprofiel. Ik controleer daarbij altijd of limieten continu worden bereikt of dat er slechts af en toe uitschieters voorkomen die zonder beperking kunnen worden verklaard.
| Sleutelfiguur | Dat betekent | Typische symptomen | Eerste controles |
|---|---|---|---|
| SPEED | CPU-prestaties (percentage/limiet) | Lange PHP-looptijden, time-outs | PHP-profielen, opcode-cache en caching controleren |
| MEM | Werkgeheugen per account | OOM-kills, 500-fouten onder belasting | PHP memory_limit, plug-ins en query's controleren |
| IO | Doorvoersnelheid in MB/s | Trage downloads/uploads | Statische cache, mediacompressie, opslag |
| IOPS | Aantal I/O-bewerkingen | Trage DB-/bestandstoegang | Indexen, queryplan, objectcache |
| PNO | Algemene processen | Verhoogde serverbelasting | Daemon-/Cron-overhangen, worker-limieten |
| EP | Gelijktijdige webtoegangen | 503-fout bij Peaks | HTTP-cache, limieten voor het aantal verzoeken, bots controleren |
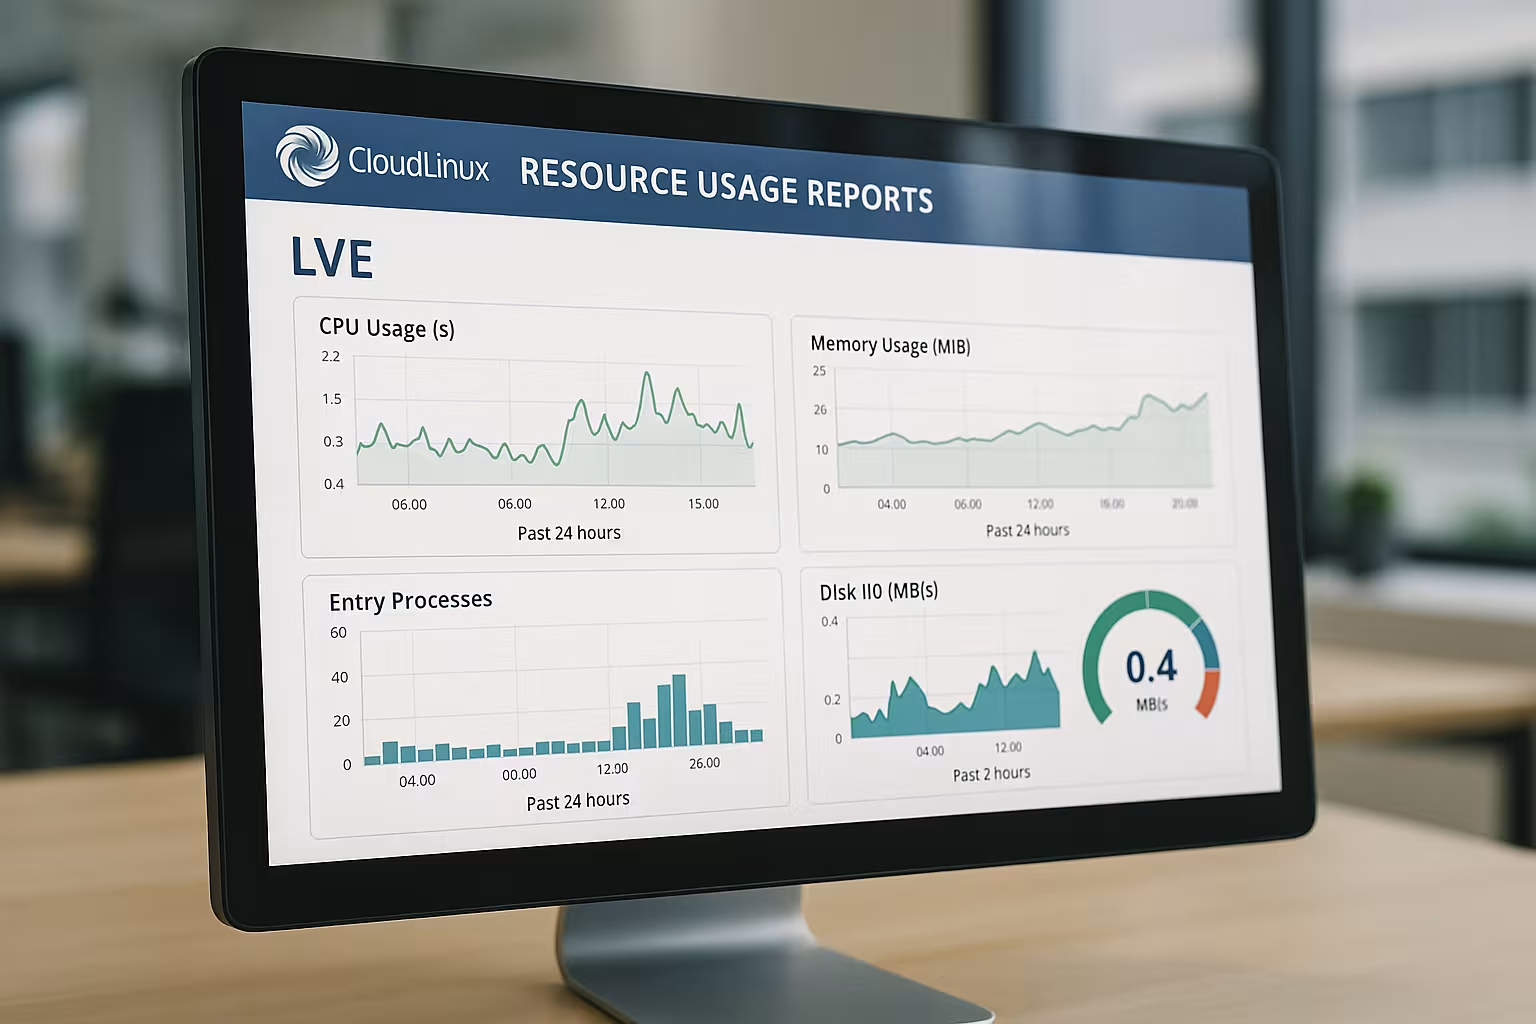
Live-monitoring met LVE Manager en lvetop
Voor snelle analyses gebruik ik de Live-gegevens in de LVE Manager en lvetop in de shell. Het Current-Usage-overzicht laat me in realtime zien hoe de CPU, het RAM, de I/O, de IOPS, de processen en de Entry Processes presteren. Bij piekbelastingen kijk ik of EP of SPEED als eerste de limiet bereiken, want dat is bepalend voor de volgende stappen. lvetop is geschikt om de accounts die het meeste verbruik veroorzaken direct eruit te filteren en, indien nodig, te beperken of te optimaliseren. Wie dieper in de interface wil duiken, past limieten en weergaven doelgericht aan – ik gebruik daarvoor graag deze handleiding: LVE Manager configureren.
Historische analyse: lveinfo, lvechart en cloudlinux-statistics
Ik herken trends via Verloop en foutgeschiedenis, niet alleen op basis van momentopnames. Met lveinfo selecteer ik tijdsvensters en zie ik wanneer limieten precies zijn geactiveerd en hoe vaak dat is gebeurd. lvechart geeft me visuele pieken over uren of dagen, waardoor patronen in de loop van de dag zichtbaar worden. cloudlinux-statistics vult de analyse aan wanneer ik per account langere tijdreeksen nodig heb. Door deze combinatie krijg ik antwoorden op de vragen „wanneer“, „hoe vaak“ en „onder welke omstandigheden“ er belasting ontstaat.
Fouten begrijpen en prioriteren
Een fout betekent: Dat Beperk Er is een fout opgetreden en CloudLinux heeft de snelheid teruggeschroefd. Daarom sorteer ik fouten eerst op frequentie, daarna op soort bron en tijdstip van de dag. Dagelijkse EP-fouten rond het middaguur duiden vaak op verkeerspieken of bots, terwijl nachtelijke RAM-fouten eerder te maken hebben met cronjobs en back-ups. Als er veel CPU-fouten optreden, ga ik op zoek naar inefficiënte PHP-routines, defecte caches of taken die niet worden afgeremd. Deze indeling bespaart tijd, omdat ik optimalisaties precies daar doorvoer waar gebruikers merkbare beperkingen ondervinden.
Oorzaken achterhalen: typische patronen en tegenmaatregelen
Op basis van mijn ervaring rangschik ik Voorbeeld snel concrete oorzaken aanwijzen. Aanhoudend hoge EP-waarden duiden op te veel gelijktijdige verzoeken of het ontbreken van edge-caching. Aanhoudend hoog RAM-gebruik wijst vaak op plug-ins, thema’s of leaky processen. IO- en IOPS-pieken duiden op gegevensintensieve taken, niet-geïndexeerde zoekopdrachten of veel kleine bestandstoegangen. Om verkeerde interpretaties te voorkomen, controleer ik tegelijkertijd de indicatoren voor de systeemstatus – een snelle start is mogelijk met de CloudLinux-gezondheidscontroles.
Cronjobs, back-ups en bots herkennen
Een blik op de verschillende Fault-series geeft uitleg over Punten in de tijd en taken. Als de vertraging altijd kort na het hele uur optreedt, draaien er vaak cronjobs parallel en concurreren deze met bezoekers. Terugkerende pieken ’s nachts duiden vaak op back-ups die de I/O en IOPS volledig benutten. Opvallende EP-fouten zonder bijbehorend verkeer in Analytics duiden vaak op bots of scrapers die statische inhoud omzeilen. In dergelijke gevallen stel ik rate-limits in, verplaats ik taken naar rustigere tijdstippen en activeer ik consequent edge- of paginacaches.
Gegevens per reseller en account analyseren
In grotere opstellingen scheid ik de Niveaus Overzichtelijk: resellers, hun klanten en individuele accounts. De LVE Manager biedt precies dit overzicht en laat me zien welke subboom de limieten beïnvloedt. Zo kan ik vaststellen of een individuele klant opvalt of dat meerdere projecten binnen een resellerstructuur tegelijkertijd druk uitoefenen. Voor supportprocessen markeer ik de betreffende accounts en leg ik maatregelen vast, zodat terugkerende tickets sneller worden opgelost. Deze transparantie helpt om middelen eerlijk te verdelen en de kosten per klant inzichtelijk te houden.
Grenswaarden correct bepalen en tarieven aanpassen
Ik stel grenzen Realistisch, niet maximaal. Te krappe EP-limieten veroorzaken 503-fouten, terwijl te lage SPEED-waarden elk PHP-antwoord vertragen. Wie regelmatig fouten ziet, controleert eerst de optimalisaties en daarna de tarieven. Als projecten bedrijfskritisch worden, loont het de moeite om een hoger profiel te kiezen, dat pieken opvangt en stabiliteit biedt. Ik documenteer de effecten in de trendgrafieken, zodat de beslissing traceerbaar blijft.
Databasegerichte projecten: I/O en IOPS optimaliseren
Bij websites die op databases zijn gebaseerd, controleer ik IOPS en IO loopt altijd parallel met de kwaliteit van de query’s. Veel kleine query’s zonder indexen genereren hoge IOPS-waarden en vertragen de responstijd. Uit ervaring blijkt dat objectcache, query-caching en aangepaste indexen deze stroom aanzienlijk verminderen. Voor trendanalyses bestudeer ik bovendien de databaserapporten en vergelijk ik deze met LVE-verloopgegevens. Deze handleiding biedt mij een gedegen inleiding tot MySQL Governor-rapporten, om de DB-belasting correct in te delen.
Monitoring-handleiding: van alarm naar actie
Op basis van meetwaarden stel ik een Playbook, dat elke escalatie duidelijk in kaart brengt. Stap 1: Live controleren of er momenteel limieten van kracht zijn en welke resource als eerste uitvalt. Stap 2: Geschiedenis openen, tijdvenster afstemmen en herhalingen markeren. Stap 3: De oorzaak lokaliseren – codepad, cache, database, cron, bot – en een tegenmaatregel met testcriterium definiëren. Stap 4: Na de ingreep opnieuw live en historisch controleren of fouten en latentie afnemen. Deze vaste volgorde voorkomt overhaaste maatregelen en zorgt voor reproduceerbare resultaten.
De onderlinge afhankelijkheden tussen de limieten correct interpreteren
In de praktijk worden limieten zelden op zichzelf toegepast. Daarom beoordeel ik de Interacties tussen EP, SPEED, MEM en IO/IOPS: als EP en SPEED tegelijkertijd stijgen, is de CPU meestal de beperkende factor per verzoek; helpt een page- of edge-cache dan, dalen beide waarden samen. Als ik een verhoogde EP zie bij een constant lage SPEED, stapelen de verzoeken zich op in de webserver, vaak vanwege een tekort aan workers, Keep-Alive-configuraties of blokkerende externe oproepen (bijv. API, e-mail). MEM-fouten bij een gematigde SPEED duiden op een klein aantal, maar geheugenintensieve processen (zoals beeldconversie of grote exporten). IO/IOPS-pieken zonder noemenswaardige CPU-belasting duiden op gegevensintensieve bestands- of databasetoegangen. Deze correlaties gebruik ik om de eerste hypothese om vast te stellen, voordat ik dieper inga op de details van de code of de server.
Praktijk: efficiënt gebruikmaken van lvetop, lveinfo en cloudlinux-statistics
Om snel tot bevindingen te komen, werk ik met duidelijke Query's en filteren. lvetop helpt me om elke seconde de grootste verbruikers te zien en te schakelen tussen sortering op CPU, MEM of IO. Met lveinfo stel ik vensters van 1 uur, 24 uur en 7 dagen in om storingsmomenten, piekwaarden en de betrokken resources per account weer te geven. cloudlinux-statistics levert me langere tijdreeksen en is geschikt om maatregelen te onderbouwen (voor en na). Per ingreep documenteer ik altijd: de periode, de betrokken accounts, de maximumwaarden per resource, het aantal storingen en de responstijden uit de applicatie- of webmonitoring. Zo kan ik optimalisaties onderbouwen en voorkomen dat limieten „op basis van vermoedens“ worden versoepeld.
Fijnheden van de webstack: PHP-handlers, workers en OPcache
Een belangrijke hefboom ligt in de PHP-uitvoering: het aantal PHP-workers per account, hun RAM-budget (memory_limit) en de OPcache. Te veel workers zonder cache verhogen EP/PNO en MEM; te weinig workers zorgen voor een opstopping van verzoeken (EP neemt toe, de responstijd stijgt). Ik zoek daarom naar een optimale balans: zoveel workers als nodig is, zo weinig mogelijk. De OPcache moet voldoende gedimensioneerd zijn (geheugen en geïnterneerde strings), anders compileert PHP voortdurend opnieuw en stijgt SPEED. Daarnaast controleer ik of statische bronnen daadwerkelijk door de webserver (en niet door PHP) worden bediend en of Keep-Alive/HTTP/2-multiplexing correct werkt. Het doel is om dynamische verzoeken te verminderen en de resterende taken snel af te handelen.
Caching-strategieën consequent toepassen
Ik onderscheid drie niveaus: Edge/CDN-cache voor wereldwijde verlichting, HTTP-/paginacache direct vóór PHP en Object cache binnen de applicatie. De Edge-cache verlaagt de EP en IO voor statische assets aanzienlijk. De paginacache vermindert het aantal dynamische hits en heeft een direct effect op EP/SPEED. De objectcache (bijvoorbeeld voor veelvoorkomende database-lookups) verlaagt de IOPS en CPU-belasting. Belangrijk is een stabiele Cache-sleutel (bijv. geen onnodige cookies) en zinvolle TTL’s per paginatype. Voor beheerders- of winkelmandgedeelten plan ik uitzonderingen; overal elders streef ik naar een zo hoog mogelijk cachepercentage. Na activering houd ik het volgende in de gaten: treden er EP-fouten op? Nemen de mediane responstijden af?
RAM-beheer: memory_limit, processen en lekken
MEM-fouten ontstaan vaak omdat geheugenlimiet ruim is ingeschat en parallelle processen het totaal overschrijden. Daarom maak ik een schatting: hoeveel RAM heeft een typisch verzoek nodig? Daaruit leid ik het maximaal zinvolle aantal workers af. Daarnaast houd ik PHP-bibliotheken en plug-ins slank, verwijder ik ongebruikte extensies en controleer ik langlopende scripts (exports, imports, beeldverwerking) op geheugenlekken. De OPcache vermindert de druk op het RAM-geheugen door compilaties tussen op te slaan, maar mag zelf niet te klein worden ingesteld. Bij terugkerende pieken isoleer ik met profilering de „dure“ paden en pak ik deze gericht aan – dat bespaart vaker RAM dan algemene limietverhogingen.
I/O en IOPS gericht verlagen
IO/IOPS-pieken ontstaan door veel kleine bestands- of database-toegangen. Ik bundel workloads waar mogelijk: het genereren van thumbnails als batch in plaats van on-demand, het minimaliseren van assets tijdens de build in plaats van bij elk verzoek, en het opslaan van sessie- en tijdelijke gegevens in één Object cache uitbesteden, zodat er minder bestandstoegangen nodig zijn. In de database geef ik prioriteit aan indexen voor veelvoorkomende WHERE-/JOIN-clausules en elimineer ik N+1-query’s. Tegelijkertijd vergelijk ik LVE-verloopgegevens met de DB-rapporten uit de MySQL Governor om hotspots in kaart te brengen. Het doel is om veel kleine IOPS om te zetten in een klein aantal efficiënte toegangen – dat vlakkt pieken af en vermindert de kans op storingen.
EP-fouten oplossen: wachtrijen en bezoekersstromen
EP beperkt het aantal gelijktijdige toegangen. Als er veel verzoeken binnenkomen terwijl de caches bijna leeg zijn, treden er al snel EP-fouten op. Ik voorkom dit door Wachtrijen voordat ik PHP implementeer (korte verzoekwachtrijen op de webserver), stel ik Keep-Alive op een zinvolle manier in en zorg ik ervoor dat dynamische paden die niet gepersonaliseerd zijn consequent in de cache worden opgeslagen. Voor bots stel ik rate-limits in en blokkeer ik voor de hand liggende ‘bad actors’ in een vroeg stadium. Daarnaast controleer ik aanroepen van derde partijen in het verzoekpad – blokkerende externe diensten verlengen de verwerkingstijd per verzoek en verbruiken daardoor EP. Waar mogelijk verplaats ik externe integraties naar taken/wachtrijen.
Cronjobs en back-ups plannen met een zo laag mogelijk verbruik van systeembronnen
Terugkerende taken koppel ik los van piekuren en pas ik aan: ik spreid cron-tables uit (door de tijd met minuten te verschuiven), ik voorkom dat taken tegelijkertijd worden uitgevoerd met lockfiles, en ik regel de belasting via Nicing en batchgroottes. Ik plan back-ups in tijdsvakken met weinig verkeer en let op incrementele methoden, zodat IO/IOPS binnen de perken blijven. Voor intensieve in-app-taken stel ik limieten in voor het aantal gelijktijdige workers, zodat MEM en SPEED niet plotseling stijgen. Ik controleer het effect gaandeweg: neemt het aantal nachtelijke fouten af, nemen de piekbelastingen na elk vol uur af?
CageFS, een overzicht van het bestandssysteem en de inodes
Naast LVE-limieten zijn ook de volgende factoren van invloed Factoren met betrekking tot het bestandssysteem De prestaties: miljoenen kleine bestanden (zoals cachefragmenten) zorgen voor meer metadatatoegang en verhogen het aantal IOPS. Ik houd cachemappen opgeruimd, beperk de stroom aan bestanden door caches op een zinvolle manier te bundelen en controleer het gebruik van inodes. CageFS zorgt voor isolatie, maar verkeerd geplaatste tijdelijke bestanden (bijvoorbeeld in de webroot in plaats van in de tmp-map) verhogen de IO onnodig. Een periodieke gezondheidscontrole van deze gebieden voorkomt dat I/O-bottlenecks ten onrechte worden geïnterpreteerd als louter CPU- of RAM-problemen.
Transparantie en communicatie in de context van resellers
In reseller-omgevingen documenteer ik Bestuurder laden per onderdeel en leg maatregelen vast: welke limieten zijn ingesteld? Welke optimalisaties staan er op de planning? Hoe zien de ‘voor-en-na’-grafieken eruit? Deze transparantie versnelt de reacties van de helpdesk en zorgt voor draagvlak voor tariefwijzigingen wanneer het optimalisatiepotentieel is uitgeput. Ik stel drempelwaarden vast waarboven we actie ondernemen (bijv. terugkerende storingen > N/dag of mediane responstijd > X ms) en koppel deze aan duidelijke actiepaden – zo ontstaan er geen eindeloze lussen in het ticketing-systeem.
Veelvoorkomende misvattingen voorkomen
Er zijn een paar patronen die ik regelmatig zie: een stijgend CPU-gebruik is niet automatisch een melding van „te weinig CPU“ – vaak werken caches niet of zijn query’s inefficiënt. Veel EP-fouten betekenen niet per se „meer verkeer“ – bots, verkeerd geconfigureerde monitoringtools of heartbeats kunnen de oorzaak zijn. MEM-fouten kunnen niet altijd worden opgelost door een hogere memory_limit – vaak zijn er te veel gelijktijdige processen. IO/IOPS-pieken hangen niet uitsluitend samen met de opslag – ze worden veroorzaakt door applicatiepatronen. Ik verifieer hypothesen daarom altijd met gecorreleerde grafieken en, indien mogelijk, met korte controletests (bijv. cache voor een deelgebied activeren en het verloop opnieuw controleren).
Testen, meten, bijschaven
Elke wijziging beoordeel ik met duidelijke meetpunten: vóór/na activering van de paginacache, vóór/na aanvulling van de index, vóór/na aanpassing van de workers. Hiervoor gebruik ik LVE-geschiedenis, responstijdstatistieken en foutpercentages (5xx/4xx). Waar mogelijk voer ik A/B-vergelijkingen uit tijdens daluren om terugkoppelingseffecten te isoleren. Als er nog steeds fouten optreden, herhaal ik het proces: de combinatie van limieten verfijnen, verdere hotpaths profileren, de batchgroottes van de taken aanpassen. De ervaring leert: twee tot drie gerichte herhalingsrondes leveren aanzienlijk betere resultaten op dan één grote, algemene maatregel.
Samenvatting: Zo lees ik CloudLinux-rapporten over het gebruik van systeembronnen op een efficiënte manier
Ik beoordeel CloudLinux-Gegevens zijn altijd onderverdeeld in drie niveaus: Live, Geschiedenis, Fouten. De kengetallen SPEED, MEM, IO, IOPS, PNO en EP geven me inzicht in oorzaak en gevolg. Met lvetop zie ik meteen wie er druk uitoefent; met lveinfo en lvechart leg ik patronen over meerdere dagen vast. Uit terugkerende fouten leid ik maatregelen af zoals caching, het optimaliseren van query’s, het aanpassen van limieten of het wijzigen van tarieven. Deze methode vermindert de ondersteuningsinspanning, verhoogt de reactiesnelheid en maakt de hostingprestaties transparant.


