 Перейти к содержимому

Я кратко и подробно объясню, как Событие MPM использует очередь событий Apache для эффективного управления большим количеством одновременных HTTP-соединений. В этой статье я расскажу об основах, цикле событий, внутренних очередях и конкретных шагах по оптимизации для Производительность Настройка.
Центральные пункты
- Цикл событий разделяет управление соединениями и обработку запросов
- Keep-Alive больше не блокирует потоки
- Очередь событий сортирует сокеты по состоянию
- Параметры как точно настроить параметр MaxRequestWorkers
- Мониторинг обеспечивает надежное планирование производственных мощностей
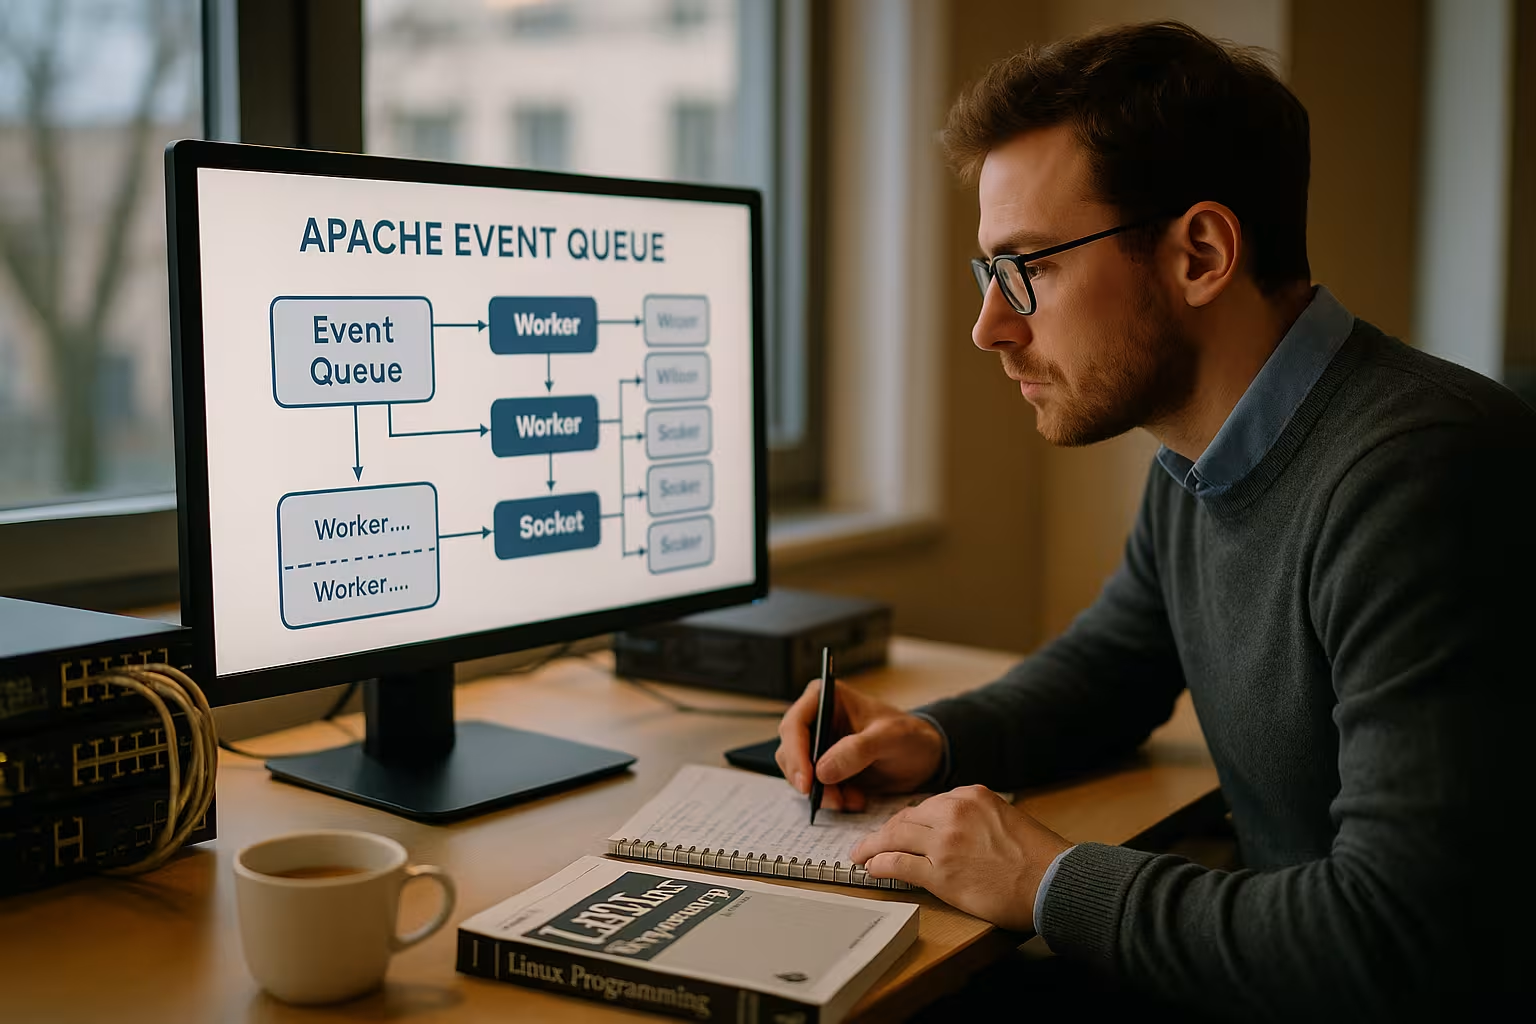
Как Event MPM управляет соединениями
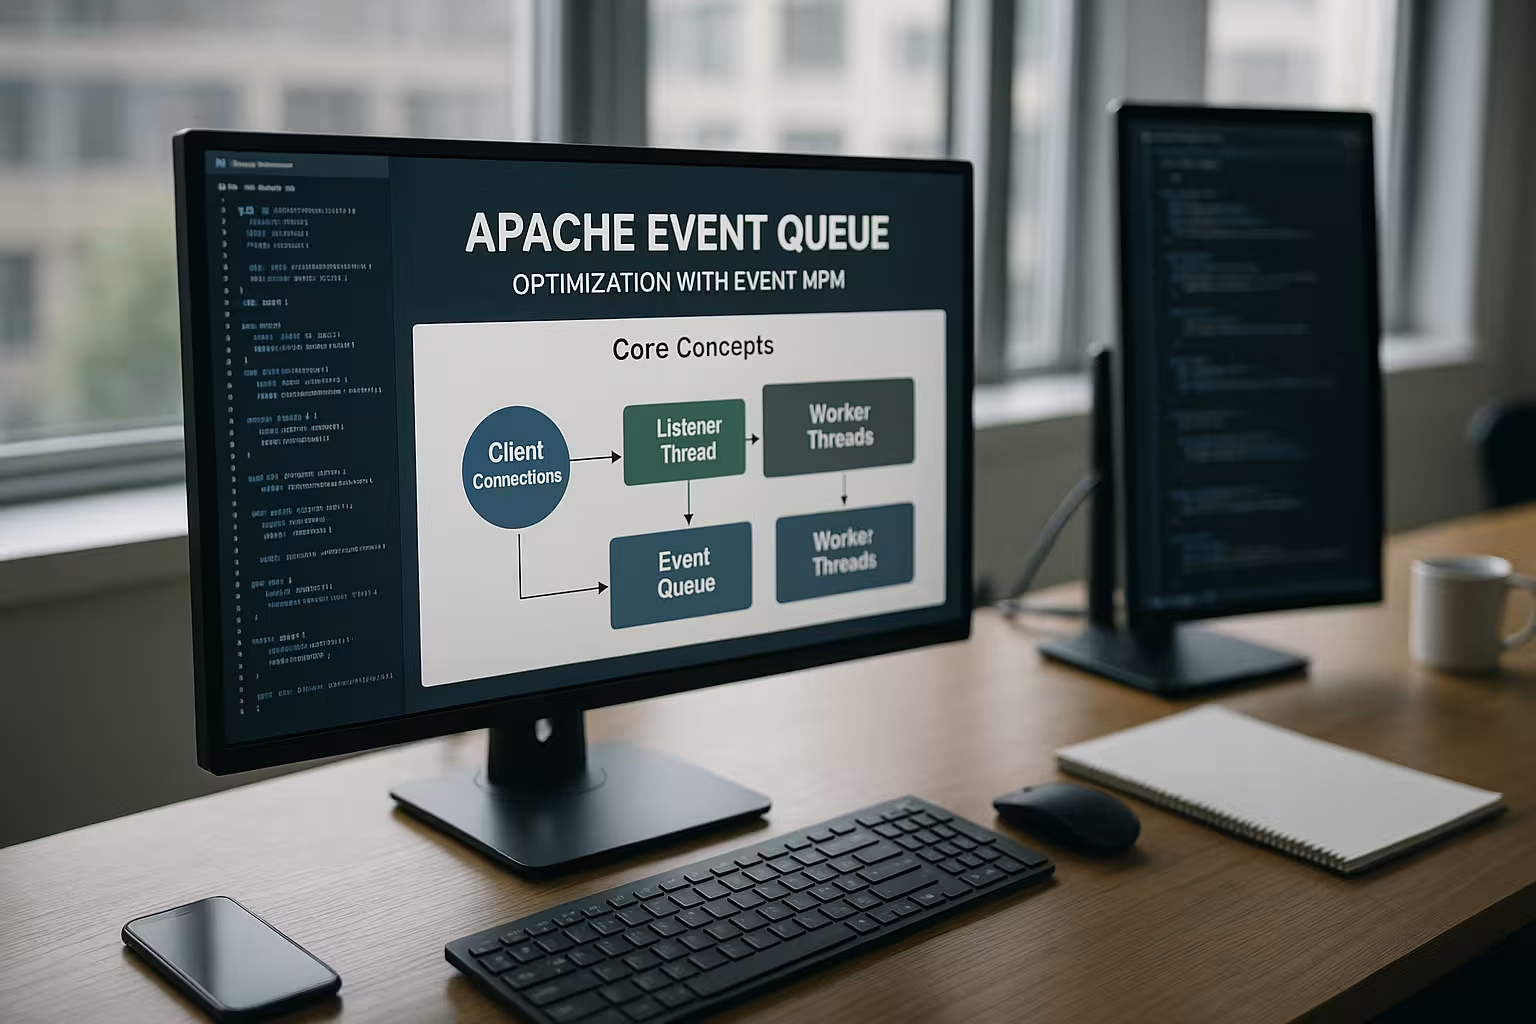
Начну с вопроса о том, как запустить Apache в Загрузить управляет таким большим количеством соединений. Event MPM объединяет процессы и потоки, но при этом отдаёт приоритет событиям через цикл событий. Потоки-слушатели принимают новые сокеты и отслеживают существующие соединения, не блокируя при этом рабочий поток. Только как только данные становятся доступными для чтения или записи, событийный уровень передаёт сокет свободному рабочему потоку. Таким образом я предотвращаю холостой ход- Соединения занимают потоки и тратят память.
Такое разделение заметно снижает нагрузку на ОЗУ. Потоки в основном выполняют „реальную работу“, такую как разбор запросов, генерация ответов или проксирование. Затем цикл событий возвращает сокеты в соответствующее состояние, например, обратно в режим Keep-Alive или в фазу завершения. На практике я наблюдаю сокращение очередей во время пиковых нагрузок, поскольку свободные потоки быстрее становятся доступными. Эта архитектура обеспечивает чёткое масштабируемая Производительность при обработке типичных рабочих нагрузок HTTP/1.1 и HTTP/2.
Очередь событий Apache: подробно
Очередь событий присваивает каждому соединению определенное состояние, и именно в этом и заключается Прибыль по сравнению с классическими MPM. Новые соединения сначала попадают в очередь, где проверяется их готовность к чтению. При поступлении данных цикл событий перемещает сокет в очередь „readable“ и назначает его рабочему процессу. После обработки статус вновь определяет дальнейшие действия: завершить запись, приостановить Keep-Alive или закрыть сокет. Этот цикл остается оптимизированным, поскольку управление очередями осуществляется с минимальными затратами с помощью epoll или kqueue.
Я часто сталкиваюсь с неверным представлением: очередь событий не заменяет рабочие процессы, она координирует их Используйте более эффективно. Потоки продолжают обрабатывать запросы, но только в том случае, если действительно происходит передача байтов. Это снижает нагрузку на ЦП и память в ситуациях с большим количеством „простоящих“ соединений Keep-Alive. Чем более продуманная архитектура таймаутов и буферов, тем меньше риск того, что соединения будут неоправданно долго находиться в ресурсоемких состояниях. Таким образом, даже при наличии тысяч открытых сокетов можно поддерживать постоянное время отклика.
Проблема Keep-Alive в классических MPM
В HTTP/1.1 соединения часто остаются открытыми, чтобы отправлять несколько запросов без нового рукопожатия, что Латентность экономит. Однако Prefork или Worker для этого запускают процессы или потоки, которые просто находятся в режиме ожидания. При пиковых нагрузках многие соединения Keep-Alive блокируют ценные ресурсы выполнения. Это приводит к резкому росту потребления ОЗУ и ограничивает количество параллельных клиентов. Event MPM решает эту проблему, удерживая сокеты, находящиеся в режиме ожидания без потока, в очереди событий в режиме ожидания.
Таким образом, я откладываю в очередь множество соединений и запускаю их обработку только при фактической необходимости. Это меняет модель пропускной способности: вместо соотношения «потоки = соединения» я использую соотношение «потоки = активная работа». В сценариях тестирования производительности это позволяет мне допускать значительно больше открытых соединений без снижения Время отклика. Для API-бэкендов, хостинга WordPress и крупных контент-сайтов это означает значительно более равномерную загрузку. Преимущества Keep-Alive сохраняются, при этом потоки не блокируются.
MPM событий против MPM рабочих процессов
Я кратко изложу эти различия в одной Таблица вместе. Цель — дать краткий обзор особенностей работы, требований к ресурсам и типичных областей применения. Оба варианта используют многопоточные процессы, однако в Event функция Keep-Alive реже привязывается к одному потоку. Worker остаётся надёжным решением для умеренной нагрузки, в то время как Event отлично справляется с большим количеством параллельных соединений. Такая классификация помогает принимать обоснованные решения для конкретной среды. Более подробное сравнение я предлагаю по адресу Событие против рабочего процесса.
| MPM | Обработка Keep-Alive | Потоки/процессы | Требование к оперативной памяти | Подходит для |
|---|---|---|---|---|
| Предпродажная подготовка | Процесс зависает в режиме простоя | Только процессы | Высокий | Устаревшая версия PHP без обеспечения безопасности потоков |
| Рабочий | тема часто остается связанным | Процессы и потоки | Средний | Умеренная нагрузка, простые настройки |
| Событие | Цикл событий сохраняет сокеты в режиме ожидания | Процессы и потоки | От низкого до среднего | Много клиентов, длительные фазы Keep-Alive |
Типичные сценарии применения
Я использую Event MPM, когда выполняется много параллельных Клиенты запрашивать небольшие и средние полезные нагрузки. От этого ощутимо выигрывают блоги с высоким трафиком, интернет-магазины с кэшированием, статические ресурсы и конечные точки API. То же самое касается хостинговых конфигураций с большим количеством сайтов на одном сервере, где преобладают соединения с поддержкой Keep-Alive. Очередь событий (Event Queue) позволяет поддерживать небольшое количество активных потоков и равномерно распределяет нагрузку. Пользователи HTTP/2 получают дополнительные преимущества, поскольку одно соединение может передавать несколько потоков, а уровень событий четко координирует их состояния.
Event демонстрирует свои преимущества и в топологиях с обратным прокси. Я поручаю Apache осуществлять SSL-аутентификацию, выполнять кэширование и передавать запросы на уровень приложения. При этом управление соединениями остается «легким», что сглаживает узкие места. Даже при пиковых нагрузках время отклика остается под контролем, при условии, что лимиты установлены разумно. Это снижает риск Очередь-Задержки и таймауты.
Конфигурация: ключевые директивы
Чтобы сформировать обоснованное мнение, я сначала проверяю ServerLimit, StartServers, ThreadsPerChild и MaxRequestWorkers. Практическое правило: сумма ServerLimit и ThreadsPerChild должна быть близка к значению MaxRequestWorkers, с запасом на техническое обслуживание и будущий рост. Слишком малое значение ограничивает параллелизм, а слишком большое — чрезмерно увеличивает потребность в ОЗУ. Я устанавливаю KeepAlive в положение «On», но выбираю умеренное значение KeepAliveTimeout, чтобы избежать чрезмерного простоя. Значения от нескольких до низких двузначных секунд часто работают хорошо, в зависимости от профиля трафика.
Кроме того, я учитываю таймауты для чтения, записи и прокси. Более короткие значения защищают от зависания бэкендов, а более длинные помогают при медленной реакции клиентов, что Компромиссы требуется. Для статических файлов целесообразно отправлять данные крупными блоками и использовать эффективные цепочки фильтров. При работе с PHP через FPM или прокси-балансировщики я масштабирую количество бэкенд-рабочих процессов в соответствии с параллелизмом фронтенда. Я документирую каждое изменение и измеряю его эффект, прежде чем двигаться дальше.
Настройка очереди событий: пошаговая инструкция
Я начинаю с четкого профиль нагрузки: одновременные соединения, количество запросов в секунду, размер ответов, доля Keep-Alive. Затем я настраиваю параметр MaxRequestWorkers таким образом, чтобы процессор не простаивал, но оперативной памяти хватало с запасом. Параметр ThreadsPerChild я настраиваю до тех пор, пока пиковые нагрузки не будут обрабатываться без задержек. Параметр KeepAliveTimeout я настраиваю так, чтобы обеспечить оптимальный баланс между пользовательским опытом и экономией ресурсов. Те, кто хочет глубже понять поведение очередей, найдут основные сведения по этой теме на сайте Очередь на веб-сервер.
Я провожу итеративное тестирование с помощью таких инструментов, как ab, wrk или k6, и анализирую задержки в P50, P95 и P99. При этом я отслеживаю, когда соединения остаются в режиме Keep-Alive, а когда — закрываются. Небольшое превышение количества потоков помогает справиться с кратковременными пиками нагрузки, не перегружая машину. Одновременно я проверяю журналы ошибок на наличие сообщений типа „server reached MaxRequestWorkers“. Таким образом, я получаю гармоничный Взаимодействие очереди событий и пула рабочих процессов.
Мониторинг и метрики
Эффективные показатели обеспечивают надежную Вместимость. Я включаю mod_status и отслеживаю активные, простаивающие и ожидающие рабочие процессы. Табло показывает, есть ли ожидающие запросы или ресурсы свободны. Кроме того, я измеряю количество процессов и потоков, загрузку ОЗУ и сетевой ввод-вывод. Визуальный анализ помогает выявлять тенденции и переломные моменты. Более подробную информацию можно найти в Apache Scoreboard.
Я сопоставляю эти показатели с журналами доступа и кодами ошибок. Если частота ошибок 5xx растёт при одновременной полной загрузке, это часто означает, что лимиты установлены слишком низко. Если увеличивается количество таймаутов, я проверяю бэкэнд-сервисы, разрешение DNS и сетевые пути. При высокой нагрузке я также анализирую TCP-очереди и повторные передачи SYN. Так я определяю, является ли Причина в веб-сервере, в бэкенде или в сети.
HTTP/2, обратный прокси и модули
HTTP/2 объединяет несколько потоков в одно соединение, что позволяет Событие-архитектура идеально подходит. Я слежу за балансом между ограничениями потоков и пулом потоков, чтобы множество мелких потоков не попадало в очереди. В качестве обратного прокси-сервера Apache извлекает выгоду из коротких таймаутов и надёжных подключений к бэкенду. Однако модули, работающие в режиме сильной блокировки, могут занимать потоки и снижать эти преимущества. Поэтому я проверяю совместимость и заменяю устаревшие компоненты, если они вызывают пики задержки.
Кэш-модули и сжатие повышают эффективность, если профили ЦП подходят для этого. Оптимизация TLS с использованием современных шифров и приоритезация HTTP/2 способствуют быстрой доставке данных. Я использую возобновление сеанса и отслеживаю затраты на установку соединения под нагрузкой. Для статических ресурсов хорошо работают подходы Zero-Copy и sendfile. Искусство заключается в том, чтобы сохранить лаконичность цепочки, состоящей из TLS, очереди событий, рабочего процесса и бэкенда.
Внутренний процесс и состояния в событии MPM
Чтобы понять внутренние процессы, я мыслю в терминах состояниях: accept → readable → processing → writable → keep-alive → close. Потоки-слушатели отслеживают сокеты с помощью эффективных механизмов ядра (epoll/kqueue) и пробуждают рабочие процессы только при поступлении события. После обработки запроса уровень событий решает, следует ли перевести соединение в режим Keep-Alive, сразу закрыть его или перейти к завершению, аналогичному „lingering close“, чтобы обеспечить корректную обработку запоздавших пакетов TCP. Этот автомат состояний предотвращает „busy waiting“ и сводит к минимуму смену контекста.
При этом важно разграничить Время ожидания ввода-вывода и загрузка ЦП: анализ запроса, конвейеры фильтров (например, сжатие) и генерация ответа выполняются в рабочих потоках. Само по себе ожидание готовности к чтению/записи остается в цикле событий. Таким образом, Apache более эффективно использует имеющиеся потоки и снижает Плотность нитей на каждое открытое соединение — значительно.
Кроме того, я учитываю поведение таблицы результатов: в mod_status можно увидеть такие фазы, как „R“ (чтение), „W“ (отправка ответа), „K“ (поддержание соединения) и „G“ (плавное завершение). Высокий показатель „K“ при одновременном наличии свободных рабочих процессов свидетельствует о том, что очередь событий корректно приостанавливает обработку и не тратит ресурсы на ненужные потоки. Если время „R“ заметно увеличивается, это указывает на наличие потенциала для оптимизации, связанного с медленными клиентами или слишком строгими таймаутами чтения.
Планирование ресурсов: пример расчета и целесообразные значения по умолчанию
Я рассчитываю Параллелизм из ЦП, ОЗУ и рабочей нагрузки. Пример: 8 виртуальных ядер ЦП, 16 ГБ ОЗУ, в основном кэшированный контент и PHP-FPM в бэкенде. Я начинаю с параметров MaxRequestWorkers 512–768, ThreadsPerChild 32–64, ServerLimit соответственно 8–12. Я планирую 1–3 МБ на каждый активный рабочий процесс на накладные расходы Apache плюс модули, к этому добавляются буфер ответов, накладные расходы TLS и сокеты бэкэнда. Реально я резервирую 4–8 ГБ для процессов/потоков Apache, 2–4 ГБ для кэша ОС, а остальное — для бэкэндов. Я слежу за тем, чтобы ServerLimit × ThreadsPerChild никогда не меньше, чем MaxRequestWorkers; целесообразно оставить небольшой запас.
Обзор полезных рекомендаций: – MinSpareThreads/MaxSpareThreads: Поддерживайте резерв таким образом, чтобы пиковые нагрузки компенсировались без „холодного запуска“, но при этом не слишком много неактивных потоков занимали память. – MaxConnectionsPerChild (также известный как MaxRequestsPerChild): ограничение длительности жизненного цикла каждого процесса помогает избежать фрагментации памяти и утечек при длительной работе (например, 5k–20k). – MaxKeepAliveRequests: Ограничивает количество запросов на одно соединение; умеренные значения защищают от „бесконечных“ сеансов, не снижая при этом эффективности Keep-Alive (например, 100–1000). – Тайм-аут, Таймауты чтения/записи и ProxyTimeout: Предотвращение зависаний; я устанавливаю дифференцированные значения для каждого контекста, вместо того чтобы применять слишком консервативные настройки на глобальном уровне.
Для статических файлов я использую EnableSendfile и EnableMMAP Осознанно: на локальных дисках оба подхода могут дать преимущества; при работе с NFS/облачными томами я часто отключаю sendfile, чтобы избежать крайних случаев. В TLS-путях sendfile, в силу своей архитектуры, менее эффективен, поскольку данные проходят через каналы шифрования; здесь главное — эффективная Цепочка фильтров.
Ограничения операционной системы и сети
Даже самая лучшая архитектура системы организации мероприятий бесполезна, если её сдерживают ограничения ОС. Я проверяю: – Дескрипторы файлов (ulimit -n): Это значение должно быть значительно выше максимального числа одновременных подключений плюс сокеты бэкэнда; для загруженных хостов обычно устанавливают значение в несколько десятков тысяч. – ListenBacklog: Достаточно большой резерв принятых запросов позволяет избежать отклонения SYN-запросов в часы пик. – Задержки в ядре (например, somaxconn) и очереди SYN: они должны соответствовать ожидаемой скорости „всплеска“. – Сетевой буфер (rmem/wmem): Не следует переувеличивать, но размеры должны быть подобраны так, чтобы не происходило сбоев на участках с высоким RTT или высокой пропускной способностью.
Я распределяю нагрузку по приему соединений с помощью нескольких потоков-прослушивателей и, как правило, позволяю платформе самостоятельно выбирать механизм приема (AcceptMutex auto). На системах, которые это поддерживают, можно SO_REUSEPORT (в зависимости от платформы с помощью опции списка) сглаживать пути принятия. Важно избегать ситуаций типа «громового стада», когда множество потоков борются за один и тот же Accept.
Также Эфемерные порты TCP (ip_local_port_range) и поведение в режиме TIME-WAIT должны соответствовать количеству параллельных прокси-соединений. Я избегаю агрессивных настроек, а провожу реалистичные тесты и слежу за тем, чтобы бэкэнды поддерживали Keep-Alive, чтобы соединения можно было повторно использовать и сократить количество переключений портов.
Тонкости работы обратного прокси: пулы соединений и бэкэнды
В качестве обратного прокси-сервера общая производительность в значительной степени зависит от стабильности подключений к бэкенду. Я слежу за тем, чтобы Прокси-соединения Обеспечьте постоянное соединение (Keep-Alive с бэкендом) и настройте размер пулов бэкенда таким образом, чтобы они соответствовали уровню параллелизма фронтенда. Слишком маленькие пулы приводят к заторам на фронтенде, а слишком большие — к ненужной нагрузке на приложение.
Практические меры: – ProxyTimeout: Короче для некритических путей, длиннее для „затратных“ конечных точек — следует дифференцировать, а не применять глобальные обобщения. – Балансир-Настройки (для mod_proxy_balancer): веса, максимальное количество соединений на один бэкенд, интервалы повторных попыток в зависимости от работоспособности. – mod_proxy_fcgi для PHP-FPM: FPM-pm.*-Значения (pm.max_children, pm.start_servers и т. д.) должны соответствовать настройкам параллелизма Apache, чтобы избежать пиковых значений 502/504.
Я слежу за тем, чтобы ошибки бэкенда оперативно и четко эскалировались, не загружая при этом фронтенд-потоки. Проверки работоспособности, осторожная политика повторных попыток и паттерны, аналогичные «предохранителям», позволяют поддерживать стабильную задержку. По возможности я обеспечиваю Кэширование ответов в соответствующих местах, чтобы сервис MPM мог отправлять в первую очередь краткие и лаконичные ответы.
Тонкая настройка HTTP/2 в Event
Для HTTP/2 я оптимизирую, помимо TLS, прежде всего Ограничения потоковой передачи и распределение задач между рабочими процессами. Большое количество небольших потоков на одно соединение может снизить задержку, но при этом повысить загрузку потоков. Я устанавливаю максимальное количество потоков на сессию таким образом, чтобы сработало мультиплексирование, но не возникало эффекта „Head-of-line“. Кроме того, я осторожно увеличиваю количество рабочих процессов, чтобы сглаживать пиковые нагрузки, не перегружая при этом оперативную память.
Я замечаю, как часто потоки находятся в режиме ожидания, хотя нити свободны. В таких случаях пропускную способность чаще всего ограничивают лимиты потоков или размеры буферов. Одна Расстановка приоритетов Использование критически важных ресурсов (например, CSS/JS с приоритетами HTTP/2) напрямую влияет на воспринимаемую производительность. Что касается TLS, то возобновление сеанса, механизмы, аналогичные 0-RTT (при условии их безопасности и доступности), а также современные алгоритмы шифрования снижают затраты на установку соединения.
Надежность: таймауты, защита от атак типа «Slowloris» и плавное завершение работы
Я активирую mod_reqtimeout, чтобы устранить явления, подобные «слоулорису». Таймауты на чтение не позволяют клиентам передавать байты со скоростью улитки и тем самым занимать ресурсы. Таймауты на запись защищают от медленных соединений со стороны клиента. Эти значения следует выбирать в зависимости от контекста — для API требуются другие настройки, чем для загрузки больших файлов.
Для развертывания и перезапуска я использую Грациозная-Процессы. Благодаря грамотно настроенному „грациозному таймауту“ старые процессы контролируемо завершают работу, пока новые процессы не возьмут на себя их функции. Таким образом, соединения Keep-Alive остаются стабильными, а очередь событий обрабатывает оставшуюся нагрузку без резких сбоев. Ротация журналов, низкий уровень детализации журналов в пиковые моменты (например, „info“ вместо «debug») и опционально Буферизованные журналы заметно снижают нагрузку на ввод-вывод.
Диагностика неисправностей под нагрузкой: распознавание закономерностей
Типичные симптомы и подходы: – Высокая P95/P99-Задержки при наличии свободных рабочих процессов: в большинстве случаев это время ожидания бэкэнда или сети; проверьте таймауты прокси и чтения, а также пулы бэкэнда. – „server reached MaxRequestWorkers“: недостаточная параллельность — увеличьте значения MaxRequestWorkers и/или ThreadsPerChild, проверьте объем занимаемой оперативной памяти. – Множество Keep-Alive- Небольшое количество соединений и активных потоков, но система всё равно работает медленно: часто встречаются блокирующие модули/фильтры или узкие места в бэкенде; необходимо провести профилирование цепочки фильтров, проверить загрузку ЦП и ввод-вывод. – Пики 5xx с сопутствующей нагрузкой TLS: хендшейки, ограниченные производительностью ЦП — оптимизируйте шифры, возобновление сеансов и, при необходимости, разгрузку.
Я устраняю узкие места по всей цепочке: прием сокетов (накопление запросов), цикл событий (состояния ожидания), рабочие процессы (ограничение по ЦП), фильтр (ограничение по вводу-выводу), прокси (ограничение по бэкенду). Эта модель мышления не позволяет мне менять значение MaxRequestWorkers, хотя на самом деле ограничением является бэкенд.
Практический контрольный список и типичные трудности
Я работаю с короткой Контрольный список: актуальная версия Apache, MPM «Event» включен, ограничения правильно настроены, таймауты установлены разумно. Затем я проверяю частоту Keep-Alive и соотношение между соединениями и активными потоками. Я проверяю, обеспечивают ли модули безопасность потоков и не вызывают ли фильтры длительных блокировок. Для PHP через FPM я убеждаюсь, что количество FPM-рабочих процессов соответствует параллелизму фронтенда. Также я настраиваю ограничения ОС, такие как файловые дескрипторы, TCP-очередь и параметры ядра для сетевых буферов, чтобы Трубопровод не замирает.
Я быстро выявляю типичные проблемы: слишком большие значения KeepAliveTimeout, слишком малое значение MaxRequestWorkers, низкое значение ThreadsPerChild или неверная настройка ведения журналов. Чрезмерно подробное ведение журналов потребляет ресурсы ввода-вывода и замедляет ответы. Слишком малый размер пула бэкенда прокси сводит на нет настройку фронтенда. Неправильная настройка TLS неоправданно удлиняет процесс установления соединения. Тот, кто тщательно проработает эти моменты, создаст надежный Основа для постоянных задержек.
Краткое изложение для лиц, ответственных за технические вопросы
Event MPM чётко разделяет управление соединениями и их выполнение и делает ставку на Очередь событий, которая эффективно паркует неактивные соединения. Благодаря этому Apache масштабируется при большом количестве одновременных клиентов, не оставляя потоки «висеть» в системе. Правильное сочетание параметров MaxRequestWorkers, ThreadsPerChild и тщательно продуманных таймаутов позволяет сдерживать задержки и потребление ОЗУ. Благодаря постоянному мониторингу, тестированию производительности и нескольким целенаправленным настройкам создается система, которая справляется с пиковыми нагрузками и стабильно отвечает на запросы. Тот, кто примет во внимание эти принципы, сможет извлечь из своего Apache-Установка позволяет значительно расширить возможности системы, оставаясь при этом совместимой с распространенными приложениями и протоколами.


