Hoppa till innehåll

Linux-cgruppen CPU-styrenhet styr hur mycket beräkningstid tjänster, containrar och processer tilldelas och gör det möjligt att planera prestandan på ett målinriktat sätt. Jag förklarar konkret hur viktning, kvoter och metoder samverkar, så att du kan fördela CPU-tid på ett säkert sätt och undvika flaskhalsar.
Centrala punkter
- viktning mot Begränsa förstå: rättvis fördelning eller strikt övre gräns
- cgrupp v2 Prioritera: tydlig semantik, konsekvent hierarki
- cpu.vikt och cpu.max: de två manöverspakarna
- systemd Fördel: Ställa in regler per tjänst
- Övervakning och Öppenhet: Läsa cpu.stat och PSI
Att förstå cgroups: Processgrupper och mål
Jag sammanfattar processer i Grupper tillsammans och styr därigenom resurser som CPU, minne och I/O i tydligt avgränsade hierarkier. Istället för att jonglera med enskilda PID:er tilldelar jag hela tjänster, containrar eller arbetspooler till en kontrollgrupp och fastställer tydliga regler. På så sätt förhindrar jag att en uppskruvad uppgift bromsar maskinen samtidigt som viktiga komponenter måste reagera. Särskilt inom hosting-sammanhang lönar sig detta tillvägagångssätt, eftersom många kunder och tjänster körs på samma hårdvara. Denna artikel ger en bra översikt över den praktiska klassificeringen: cgroups och webbhotell, som tydligt visar hur kostnaderna fördelas.
Hur CPU-styrenheten fungerar
CPU-styrenheten delar upp beräkningstid genom två mekanismer: relativ viktning och absolut bandbreddsbegränsning. Viktning innebär att grupper tilldelas CPU-andelar i förhållande till varandra så snart konkurrens uppstår; högre värden vinner då oftare tidsintervall. En kvotbegränsning sätter ett tak för förbrukningen inom ett fast tidsfönster, även om det inte föreligger någon konkurrens. Jag väljer viktning när rättvisa och dynamisk utnyttjande är i fokus, och sätter kvoter när en strikt övre gräns måste förbli orubblig. Kärndokumentationen belyser tydligt denna skillnad och visar hur båda mekanismerna tillsammans bildar en sammanhängande styrningsmodell [1].
cgroup v1 jämfört med v2: Skillnader och filer
Med cgrupp v2 Jag hanterar CPU-reglerna på ett enhetligt och överskådligare sätt jämfört med den äldre v1-varianten. I v1 använde jag olika filer för varje styrenhet; i v2 fokuserar jag på `cpu.weight` för relativ prioritet och `cpu.max` för en strikt bandbreddsbegränsning. Denna tydliga uppdelning förkortar konfigurationstiden, förhindrar missförstånd och underlättar granskningar. I hostingmiljöer med många containrar säkerställer v2-hierarkin överskådliga regler på alla nivåer. En praktisk bedömning ges i artikeln om cgroup v2 i webbhotell, som behandlar konsekvent styrning vid gemensamt utnyttjad hårdvara.
| Ämne | cgroup v1 | cgrupp v2 | Typiska parametrar |
|---|---|---|---|
| CPU-viktning | cpu.aktier | cpu.vikt | cpu.vikt (Standardvärdet är ofta 100) |
| CPU-kvoter/begränsningar | cpu.cfs_quota_us + cpu.cfs_period_us | cpu.max | cpu.max (t.ex. 20 000 100 000) |
| Hierarki | Separata styrenheter | Enhetlig trädstruktur | Gemensamma regler för varje nivå |
| I realtid | Separat RT-styrenhet | Begränsningar för RT | Se anvisningar för kärnan [1] |
För administratörer är det viktigt att Samstämmighet Minska fel i regelverket och se till att ändringar träder i kraft snabbare. Jag dokumenterar parametrarna vid gruppnoderna så att alla kan se den aktuella effekten. Vid migreringar från v1 kontrollerar jag noggrant motsvarigheterna, framför allt ”Shares” till ”Weight” och ”CFS-Quota” till ”cpu.max”. Först när testbelastningarna reagerar som förväntat flyttar jag produktiva tjänster till den nya hierarkin. Denna disciplinerade övergång sparar många supportcykler i efterhand.
Hierarki, underträd och delegering
I cgroup v2 styr jag kontroller per nivå och delegera dem vid behov. Via cgroup.subtree_control aktiverar jag CPU-kontrollern för underordnade noder; systemd sköter detta vanligtvis automatiskt när jag ställer in CPU-egenskaper. Viktigt: I v2 håller jag helst processerna i Bladgrupper och inte i mellanliggande noder. På så sätt blir reglerna tydligare, och lastfördelningen följer tydligt trädstrukturen. I komplexa konfigurationer tilldelar jag hela tjänster till slices (t.ex. tenant-a.slice), däribland tjänster och arbetsgrupper. Denna tydliga uppdelning underlättar delegering till team som arbetar i „sina“ underkataloger utan att bryta mot globala riktlinjer.
Viktiga parametrar: cpu.weight och cpu.max
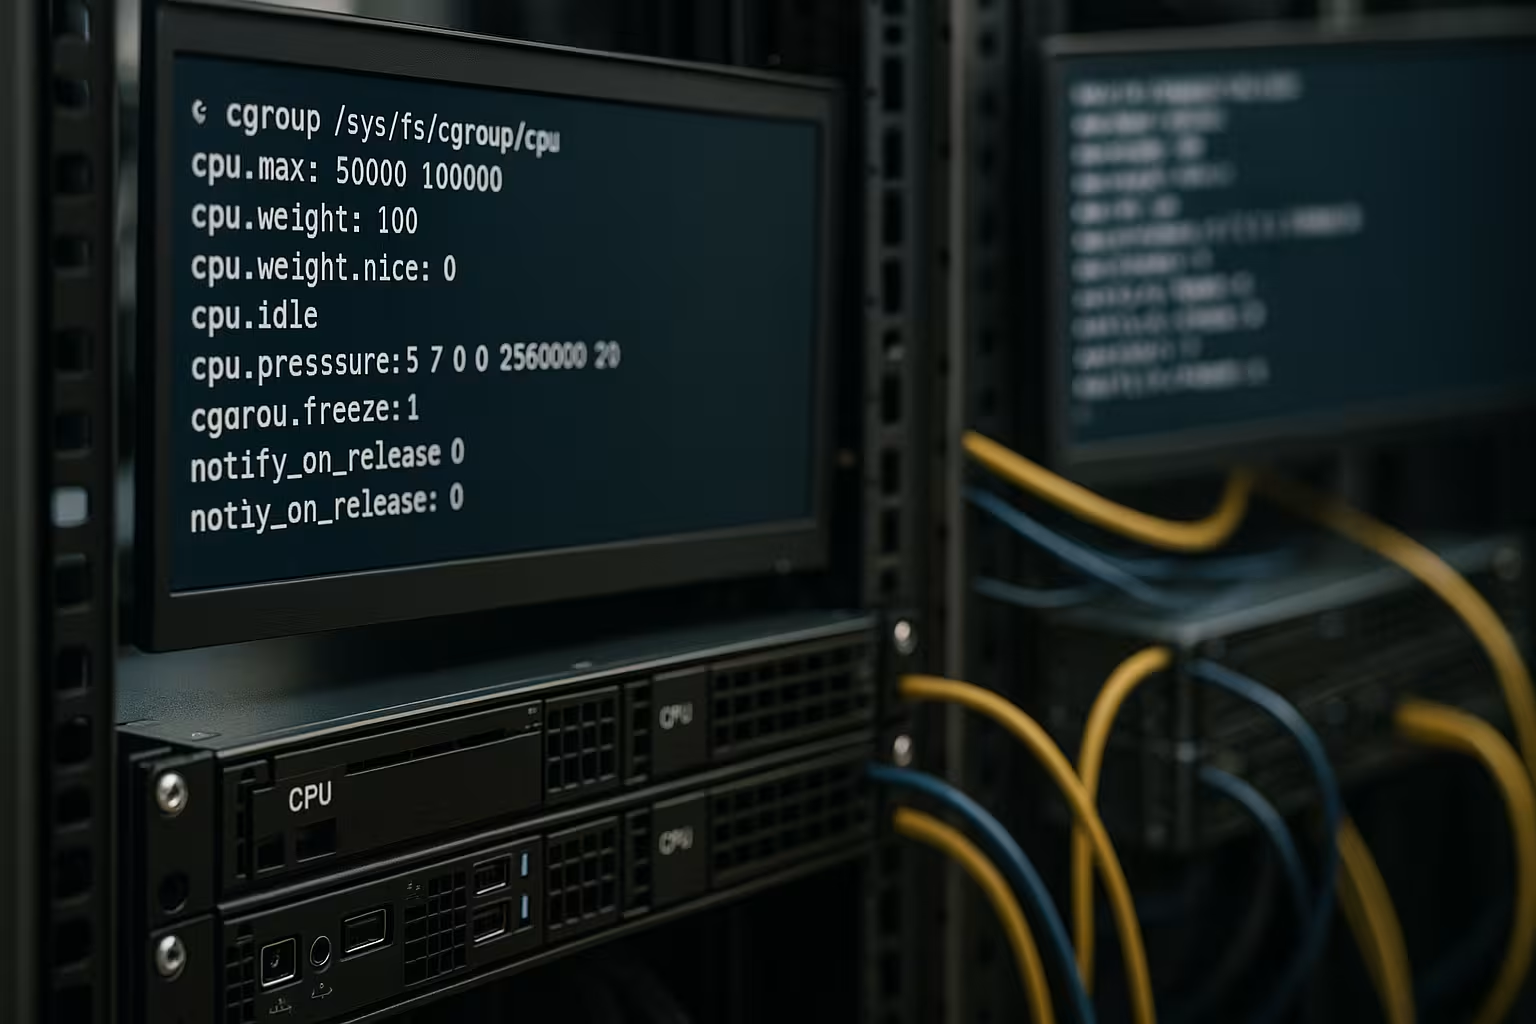
Jag använder cpu.vikt, för att prioritera tjänster relativt: Om tjänst A tilldelas en högre vikt än tjänst B får A oftare CPU-tid under hög belastning. Standardvärdet i v2 är ofta 100; högre värden gynnar respektive grupp, men jag håller mig inom rimliga gränser för att förhållandet ska förbli hanterbart. För hårda begränsningar skriver jag in cpu.max en kvot och en period, till exempel 20000 100000 för ungefär 20 procent av en vCPU-plats. Med max Som första åtgärd upphäver jag taket, men behåller tidsperioden, vilket förenklar felsökningen. Red Hat dokumenterar vanliga inställningar på ett lättförståeligt sätt och visar hur de påverkar driften [2].
Ytterligare inställningsparametrar: cpu.weight.nice och UClamp
För lag som utgår från den klassiska trevlig-semantik, erbjuder v2 med cpu.weight.nice en praktisk länk: Jag kan leda grupper inom området -20..19 klassificera, vilket internt omvandlas till viktsskalan. På så sätt förblir relativa förväntningar („föredrar lite“, „dämpa något“) konsekventa utan att man varje gång behöver fastställa konkreta vikter. Dessutom använder jag vid behov Utnyttjandebegränsning via cpu.uclamp.min och cpu.uclamp.max, för att ange en lägsta respektive högsta gräns för den effektiva CPU-utnyttjandegraden på schemaläggarnivå. På så sätt säkerställer jag till exempel att en latenskritisk tjänst inte sjunker under den nödvändiga grundbelastningen, även vid ett lågt antal trådar, eller att batchjobb inte får en alltför hög boost. Denna finjustering kompletterar viktning och kvoter, men ersätter dem inte: Jag mäter alltid hur UClamp fungerar tillsammans med min governor- och energipolitik innan jag implementerar den i stor skala.
Planering av arbetsbelastningar: rättvisa kontra strikta gränser
Jag bestämmer medvetet om Rättvisa eller strikta övre gränser har företräde. För webbtjänster där latensen är avgörande höjer jag vikten något, så att de prioriteras vid konkurrens utan att andra grupper missgynnas alltför mycket. För beräkningsintensiva batchjobb sätter jag dessutom en kvot så att de aldrig tar för mycket tid i anspråk, även om systemet i övrigt går på tomgång. Databaser ger jag en måttlig viktning och observerar hur kontrollpunkter, ombyggnader eller stora sökningar påverkar; vid behov justerar jag detta under en begränsad tid. Dessa regler kombinerar jag med larm så att jag kan reagera tidigt innan fördröjningarna eskalerar.
Prestanda på flerkärniga processorer och val av period
Ett vanligt hinder är tolkningen av Prestanda på flerkärniga system. En kvot avser Total beräkningstid för gruppen per period, inte för enskilda kärnor. CPUQuota=200% eller . cpu.max = 200 000 100 000 Tillåter ungefär två CPU-sekunder per 100 ms-period – fördelat över alla trådar/kärnor. Detta kan innebära att många trådar körs parallellt under en kort stund, tills gruppen i den aktuella perioden är „förbrukad“ och stryps. Jag undviker missförstånd genom att alltid tänka på kvoter i termer av „CPU-slots“ och anpassa dem efter tjänstens parallellitet.
Standardperioden är ofta 100 ms. Kortare perioder (z. B. 50 ms) gör att begränsningen träder i kraft snabbare, men kan orsaka mikrojitter; längre perioder jämnar ut fluktuationerna, men reagerar långsammare. I systemd justerar jag detta med CPUQuotaPeriodSec= och kontrollerar om latensspikar eller genomströmningsmål uppnås bättre. För interaktiva tjänster mäter jag latensen från ände till ände, medan jag för batchbearbetning utgår från den totala genomströmningen och rättvisan gentemot grannarna.
Praktisk tillämpning: Konfiguration med systemd och cgroup v2
I systemd ställer jag in regler för varje tjänst, eftersom Tjänstfiler möjliggöra en reproducerbar konfiguration. Med systemctl set-property Jag ändrar dem hela tiden, och med drop-in-filer hanterar jag versionerna av inställningarna på ett överskådligt sätt. Ett exempel: systemctl set-property --runtime nginx.service CPUWeight=150 prioriterar NGINX något; systemctl set-property --runtime batch.service CPUQuota=20% avslutar batchjobb. Jag skriver alltid in /etc/systemd/system/service.d/limits.conf Ställ in lämpliga alternativ och ladda om enheterna. För en praktisk introduktion kan det vara värt att ta en titt på den här guiden om systemd-resurskontroll, som kortfattat sammanfattar de vanligaste alternativen.
# Exempel för systemd v245+ med cgroup v2
# Relativ prioritering
systemctl set-property --runtime nginx.service CPUWeight=150

# Hård övre gräns
systemctl set-property --runtime batch.service CPUQuota=20%

# Kombination i en drop-in-fil
mkdir -p /etc/systemd/system/php-fpm.service.d
cat < /etc/systemd/system/php-fpm.service.d/cpu.conf
[Service]
CPUWeight=120
CPUQuota=50%
EOF
systemctl daemon-reload
systemctl restart php-fpm.service
Slices för hyresgäster och team
För klient- eller teamgränser använder jag Skivor som en organisatorisk ram. En ”slice” omfattar flera tjänster och tillämpningsområden som regleras gemensamt. På så sätt kan jag tilldela budgetar per kund utan att behöva hantera varje enhet separat, och delegera ändringar på ett kontrollerat sätt.
# Tenant-Slice med standardregler
mkdir -p /etc/systemd/system/tenant-a.slice.d
cat < /etc/systemd/system/tenant-a.slice.d/cpu.conf
[Slice]
CPUWeight=120
CPUQuota=150%
# Valfritt: Period för finare begränsning
CPUQuotaPeriodSec=100ms
EOF
systemctl daemon-reload
systemctl restart tenant-a.slice
Alla tjänster under tenant-a.slice följer dessa riktlinjer. Vid kortvariga toppar höjer jag vikten tillfälligt, men låter kvoten förbli oförändrad så att angränsande system inte trängs undan.
Övervakning och felsökning
Jag undersöker effekter och biverkningar med Öppenhet i mått. Filerna cpu.stat och cpu.pressure (PSI) per cgroup ger mig andelar, väntetider och flaskhalsar som tyder på begränsningar eller överbelastning. Med topp, htop och systemd-cgtop Jag identifierar fördelningstendenser i realtid och jämför dem med mina regler. Om latenserna ökar men CPU:n är inaktiv beror problemet snarare på I/O eller låsningar än på CPU-begränsningar; jag justerar då inte viktningen förhastat. Efter ändringar dokumenterar jag mätvärdena under minst en belastningscykel för att undvika felaktiga korrelationer.
Handbok för övervakning: Vad jag läser konkret
cpu.stat: användning_användning, user_usec, system_usec visa förbrukning; nr_perioder, nr_throttled, throttled_usec avslöjar kraftiga begränsningar. Stiger nr_throttled/nr_periods Om avvikelsen överstiger några procent är intervallet för snävt eller tidsperioden för kort.cpu.pressure: Jag observerar några avg10/60/300 för latensrelaterade flaskhalsar. Ett konstant förhöjt värde trots lediga CPU:er tyder på låskonflikter, affinitetskonflikter eller NUMA-fjärråtkomst.systemd-cgtopochps: Jag undersöker om trådar verkligen kan köras parallellt eller om de måste vänta på exklusiva resurser.
För reproducerbara tester använder jag stress-ng, sysbench eller använder egna belastningsgeneratorer och tar mätvärdesöversikter före och efter. Först när mätvärdena stabilt överensstämmer med förväntningarna inför jag ändringarna.
Realtid och särdrag
Med I realtid-När det gäller arbetsbelastningar följer jag anvisningarna i kärndokumentationen, eftersom v2 endast i begränsad utsträckning hanterar CPU-kontrollern för RT. Vissa RT-trådar måste ligga i rot-cgroupen, och konfigurationen kräver ett försiktigt tillvägagångssätt. Jag kontrollerar dessutom hur RT-schemaläggning fungerar tillsammans med kvoter, så att inga tidsgränser oavsiktligt överskrids. För typiska webb- och databastjänster använder jag vanliga policyer, eftersom denna konstellation är enklare att planera i vardagen. När jag behöver RT separerar jag systemen eller reserverar kärnor tydligt för att undvika oväntade interaktioner [1].
Finstyrning på flerkärniga system
CPU-styrenheten delar upp Tidsfönster, inte klockfrekvens, därför kombinerar jag det vid behov med cpuset och affinitet. För låg latens begränsar jag växlingar mellan socklar, kopplar trådar till NUMA-lokala kärnor och optimerar IRQ-fördelningen. Jag låter batch-tjänster köras mer flexibelt så att de utnyttjar ledig kapacitet utan att blockera kärnor för kritiska frontend-applikationer. Jag granskar turbo- eller energisparinställningarna, eftersom frekvensförändringar kan påverka beteendet under belastning avsevärt. Det är först summan av kvoter, vikter, CPU-affinitet och energistrategi som ger konsekventa resultat.
SMT, NUMA och affinitet i praktiken
På system med SMT/Hyper-Threading Jag noterar att två logiska trådar på en fysisk kärna inte ger två fullständiga CPU-slots. En kvot på „100 %“ täcker en logisk slot, inte nödvändigtvis en fullständig fysisk kärnkapacitet. Därför mäter jag latens och genomströmning både med och utan SMT-användning. I NUMA-system begränsar jag kritiska tjänster med AllowedCPUs= (cpuset) eller CPU-affinitet = Använd lokala kärnor och ställ in minnesbindningen därefter, så att fjärråtkomst inte förstör all detaljplanering.
Bästa praxis för webbhotell och containrar
Jag börjar med måttlig Standardinställningar: Viktar webbtjänster något högre, databaser nära standard, batch med kvot. För hyresgäster sätter jag övre gränser per kund och tillåter spetsbelastning via viktning, så länge det inte finns något annat behov. Jag dokumenterar profiler efter användningsfall, till exempel „latenskritisk“, „blandad“ och „beräkningsintensiv“, och fastställer tydliga intervall för weight och cpu.max per profil. Ändringar testar jag först i stagingmiljön med syntetisk belastning som realistiskt återspeglar topparna. Jag håller loggar och mätvärden nära cgroup-gränserna så att diagnostiken inte hamnar i dimman.
Container-orkestrering: delningar, förfrågningar och begränsningar
I containermiljöer kartlägger jag Förfrågningar relativ viktning och Gränser hårda kvoter. Detta möjliggör burst-trafik så länge noderna har ledig kapacitet och säkerställer en rättvis fördelning enligt vikt i konkurrenssituationer. Kritiska podar eller tjänster tilldelas något högre vikt utan att gränserna begränsar andra. Jag ser till att summan av gränserna per nod stämmer överens med den tillgängliga CPU-kapaciteten; annars uppstår det, trots tydliga regler, en systemomfattande begränsning som drabbar alla hyresgäster.
Exempel på konfigurationer och beräknings exempel
Jag omräknar alltid kvoter till Aktier per vCPU-plats: cpu.max = KVOTPERIOD motsvarar KVOT/PERIOD i spelautomaten. Exempel: 20000 100000 är 0,2 för en enskild CPU; för fyra CPU:er är det högst 0,8 totalt, men fördelningen är inte garanterad. För procentangivelser under systemd skriver jag CPUQuota=20%, vilket, beroende på version, stämmer överens med cpu.max. Den som sätter strikta gränser måste väga burst-beteendet mot latensen: En för kort period kan orsaka mikrofördröjningar, medan en för lång period ger en jämnare fördelning men reagerar trögare. Jag testar därför perioder mellan 50–100 ms och väljer den variant som passar tjänstens latensklass [2].
Migrering från v1 till v2 utan överraskningar
När jag byter transportmedel tar jag med mig cpu.aktier på cpu.vikt och cpu.cfs_quota_us/period_us på cpu.max. En pragmatisk kartläggning för delningar är: 1024 → ~100, 2048 → ~200, 512 → ~50. Jag gör finjusteringar efter belastningstesterna, eftersom skalorna skiljer sig åt. Jag planerar dessutom att v2-reglerna ska gälla för barn kumulativt verkar: En begränsande kvot vid föräldraknuten begränsar alla undergrupper tillsammans. Därför upphäver jag ofta föräldrakvoterna (max) och justerar noggrant i arken för att undvika oönskade effekter.
Vanliga fel och åtgärder
- 100 % förväxlas med „alla kärnor“: 100 % motsvarar en logisk CPU-plats, inte hela maskinen. Lösning: Beräkna kvoten utifrån antalet platser som behövs (t.ex. 400 % för fyra platser).
- För kort period: Små hack i interaktiva tjänster. Lösning: Öka perioden eller använd vikt istället för kvot.
- Viktning mätt utan konkurrens: Vikten får först effekt vid konkurrens. Lösning: Genomföra tester med verklig parallellbelastning.
- Glöm kvoterna för föräldrar: En begränsad överordnad instans hämmar alla underordnade instanser. Lösning:
cpu.max=maxpå stammen, gränser på bladen. - NUMA/sockel ignoreras: Fördröjning trots ledig CPU. Lösning: Kontrollera affinitet/CPUSets och minneslokalitet.
Sammanfattning
Med hjälp av CPU-styrenhet Jag fördelar beräkningstid på ett målinriktat sätt, fastställer rättvisa prioriteringar och sätter strikta gränser där det behövs. cgroup v2 erbjuder tydliga parametrar som cpu.weight och cpu.max, som jag planerar och mäter utifrån arbetsbelastningen. Via systemd ställer jag in regler per tjänst, kontrollerar effekten med cpu.stat och PSI och justerar utan att behöva gissa. För hyresgäster, containrar och blandade servermiljöer är denna styrning avgörande för att uppnå tillförlitlighet och förutsägbarhet. Den som dokumenterar regler, inför dem stegvis och säkerställer dem med belastningstester, förhindrar flaskhalsar och behåller kontrollen över CPU-tiden.