Hoppa till innehåll

Jag analyserar prestandan hos Redis-nyckel Arbeta målmedvetet med utandningen och optimera den med tydliga, mätbara steg. På så sätt minskar jag Fördröjning, utjämnar belastningstoppar och håller lagringsförbrukningen under kontroll utan att äventyra genomströmningen.
Centrala punkter
Jag sammanfattar de viktigaste aspekterna av Utgångsdatum-Prestanda på ett sådant sätt att nybörjare kan komma igång direkt och avancerade användare kan finjustera på ett målinriktat sätt. Följande punkter tar upp de mest effektiva justeringsmöjligheterna och visar var typiska flaskhalsar uppstår. Jag fokuserar då på TTL-strategier, aktiv och passiv sanering samt utvisningsbeteende. Dessutom inför jag övervakningsindikatorer som gör det möjligt att upptäcka problem i ett tidigt skede. På så sätt kan prestandan utvärderas systematiskt och på lång sikt styra.
- Lazy mot. Aktiv Expiration: Att förstå och mäta samspelet
- TTL-Spridning: Offset mot samtidig förfall
- hz-Justering: Balansera frekvensen för bakgrundscyklerna
- Utsläppningspolicy: allkeys-lru jämfört med volatile-varianter
- Övervakning: Övervaka värdena för expiration, eviction och latens
Jag satsar på konsekvent TTL:er, adaptiv rensning och tydliga gränsvärden. På så sätt fördelar jag körningstidpunkter, förhindrar onödiga evikteringar och håller svarstiderna på en tillförlitligt låg nivå. Dessutom använder jag mätvärden som visar på avvikelser Faser omedelbart signalera detta och möjliggöra precisa motåtgärder.
Redis-nycklars giltighetstid: Hur det fungerar och hur det påverkar latensen
Redis kombinerar Lata och aktiv Expiration för att kombinera hög hastighet med begränsad CPU-belastning. Vid ”lazy expiration” raderar servern nycklarna först vid åtkomst, när TTL har löpt ut. Detta innebär att inga ytterligare bakgrundsoperationer krävs för data som ändå läses regelbundet. Active Expiration kompletterar modellen med korta, frekventa genomsökningar av nycklar som håller på att löpa ut, för att ta bort glömda poster. Denna arkitektur håller latensen låg och frigör minne utan kostsamma, permanenta Skannar.
Märkbar latens uppstår framför allt när ett mycket stort antal poster löper ut inom ett kort tidsfönster. Då lägger Redis ner mer CPU i aktiv rensning, vilket tillfälligt minskar kapaciteten för klientoperationer. Ytterligare belastning på minnet förvärrar situationen, eftersom eviktioner utlöser parallella processer. Därför planerar jag medvetet att fördela händelsetidpunkterna och håller Maxmemory-gränsen så att det fortfarande finns en buffert. På så sätt förblir svarstiderna tillförlitliga även under toppar i utgångstider. låg.
Lazy och Active Expiration i detalj
Lazy Expiration utmärker sig när det gäller ofta lästa sidor Nycklar, eftersom kontrollen vid åtkomst på ett elegant sätt kopplar samman raderingstidpunkten med användningen. Poster som sällan läses skulle dock fortsätta att ta upp lagringsutrymme trots att TTL har löpt ut. Här träder ”active expiration” in: Redis tar slumpmässiga stickprov ur mängden nycklar med utgångstid och tar konsekvent bort poster vars TTL har löpt ut. Om andelen utgångna poster i ett urval är hög utökar Redis cykeln adaptivt. Därigenom ökar rensningskapaciteten tillfälligt tills andelen utgångna poster återigen minskar.
Jag tar hänsyn till att denna strategi fungerar på ett probabilistiskt sätt. Det är avsiktligt, eftersom enskilda tidsinställningar eller globala fullskanningar med miljontals nycklar Fördröjning skulle svälla upp. Med väl valda TTL-värden och en lämplig Hz-frekvens raderar Redis i rätt tid och håller driften smidig. Jag kontrollerar regelbundet hur många nycklar med TTL som finns och hur snabbt utgångna poster försvinner. Denna observation ger mig ledtrådar om jag bör justera den aktiva rensningen något förstärk eller lugna.
Riskmönster: Identisk TTL-tidpunkt och lagringstryck
Det blir problematiskt när många cacher har samma Tidpunkt för förfall bevaras. Därefter raderar och förnyar applikationer och Redis ett mycket stort antal objekt på kort tid. Den aktiva utgångstiden ökar, och samtidigt genererar klienter ombyggnader som använder databaser eller API:er. När Maxmemory-gränsen är knapp träder dessutom evictions in, vilket skapar ännu mer arbete. Denna sammanfallning driver Fördröjning och CPU-belastningen ökade märkbart.
Jag löser detta genom att avkoppla tidspunkterna för avslut och på så sätt jämna ut topparna. Dessutom kontrollerar jag om evictions inträffar för ofta på grund av att inställningen för Maxmemory är för snäv. Särskilt under rusningstider lönar det sig att ha lite buffert, så att expiration och rebuilds hinner Luft har. När det är möjligt separerar jag dessutom långlivade strukturer från rena cache-data i olika instanser. På så sätt kolliderar olika livscykler mindre ofta och servrarna fungerar förutsägbar.
TTL-design: Avkoppling och spridning för att motverka stampeder
En liten slumpmässig förskjutning på cirka ±10 % i förhållande till bas-TTL fördelar tidspunkterna för förfall över ett tidsfönster. På så sätt undviker jag rusningar, eftersom inte allt förfaller samtidigt och måste byggas upp på nytt. För särskilt kritiska snabbtangenter använder jag probabilistisk uppdatering strax före utgången: En del av åtkomsterna uppdateras, medan andra fortfarande läser acceptabla, något äldre data. På så sätt fördelar jag återuppbyggnadsarbetet kontinuerligt. Ytterligare mönster gällande utgångstider och arkitektur skissar jag i mina Expire-strategier, som jag anpassar pragmatiskt efter arbetsbelastningen.
Jag tilldelar konsekvent TTL:er för varje kortlivad Struktur. Utan TTL kan eviktionspolicyn fungera på ett missvisande sätt, eftersom den då även måste rensa bort innehåll med lång livslängd. För rena cacher väljer jag ofta allkeys-lru, för blandade arbetsbelastningar snarare volatile-lru eller volatile-ttl. På så sätt bevaras data med lång livslängd, medan cacheobjekt rensas bort först. Genomtänkta TTL:er och policyer ger tillsammans Planerbarhet.
Konfiguration: Hz, eviktionspolicyer och TTL-strategier
Parametern hz styr frekvensen för bakgrundsuppgifterna, däribland den aktiva utgångshanteringen. Högre värden rensar upp snabbare, men kräver mer CPU-resurser. Lägre värden sparar CPU-resurser, men låter utgångna nycklar ligga kvar längre. Jag höjer hz försiktigt, mäter latens och CPU-förbrukning och höjer det först ytterligare när minnet märkbart förblir upptaget längre. Parallellt anpassar jag eviction-policy och TTL-design noggrant efter användningssyftet från.
Följande tabell sammanfattar viktiga alternativ och typiska effekter. Jag använder den som en praktisk lathund för att kunna väga olika alternativ på ett överskådligt sätt. Varje rad fokuserar på effekterna på latens, RAM och konkreta anvisningar för driften. På så sätt blir optimeringsarbetet överskådligt och leder till mätbara Resultat.
| Komponent | Alternativ/Inställning | Inverkan på latensen | Inverkan på RAM-minnet | Praktisk anmärkning |
|---|---|---|---|---|
| Bakgrundscykler | hz låg | Låghögre CPU-belastning, eventuellt fler gamla nycklar | Utgångna nycklar finns kvar längre | Lämplig för lugna arbetsbelastningar; snäva mätvärden observera |
| Bakgrundscykler | hz måttlig/hög | Snabbare rensning, tillfälligt mer CPU-kapacitet | Snabbare återvinning av RAM-minne | För cacher med hög ändringsfrekvens användbar |
| Avhysning | alla nycklar-lru | Konstanta svarstider i ren cache | Rensa bort oanvända nycklar på ett aggressivt sätt | Rekommenderas för rena Cacher |
| Avhysning | volatile-lru | Sparar på hållbara konstruktioner | Tar endast bort TTL-nycklar | Ofta vid blandade arbetsbelastningar fördelaktigt |
| Avhysning | volatile-ttl | Rensa bort efter kortast möjliga återstående TTL | Mycket målinriktad godkännandeprocess | Om TTL:s bra Signal bära |
| TTL-design | ±10 % Offset | Färre samtidiga ombyggnader | Utjämnar utandningsfaserna | Enklare, mycket mer effektivt Trick mot panik |
Uppföljning: Vilka nyckeltal som verkligen spelar roll
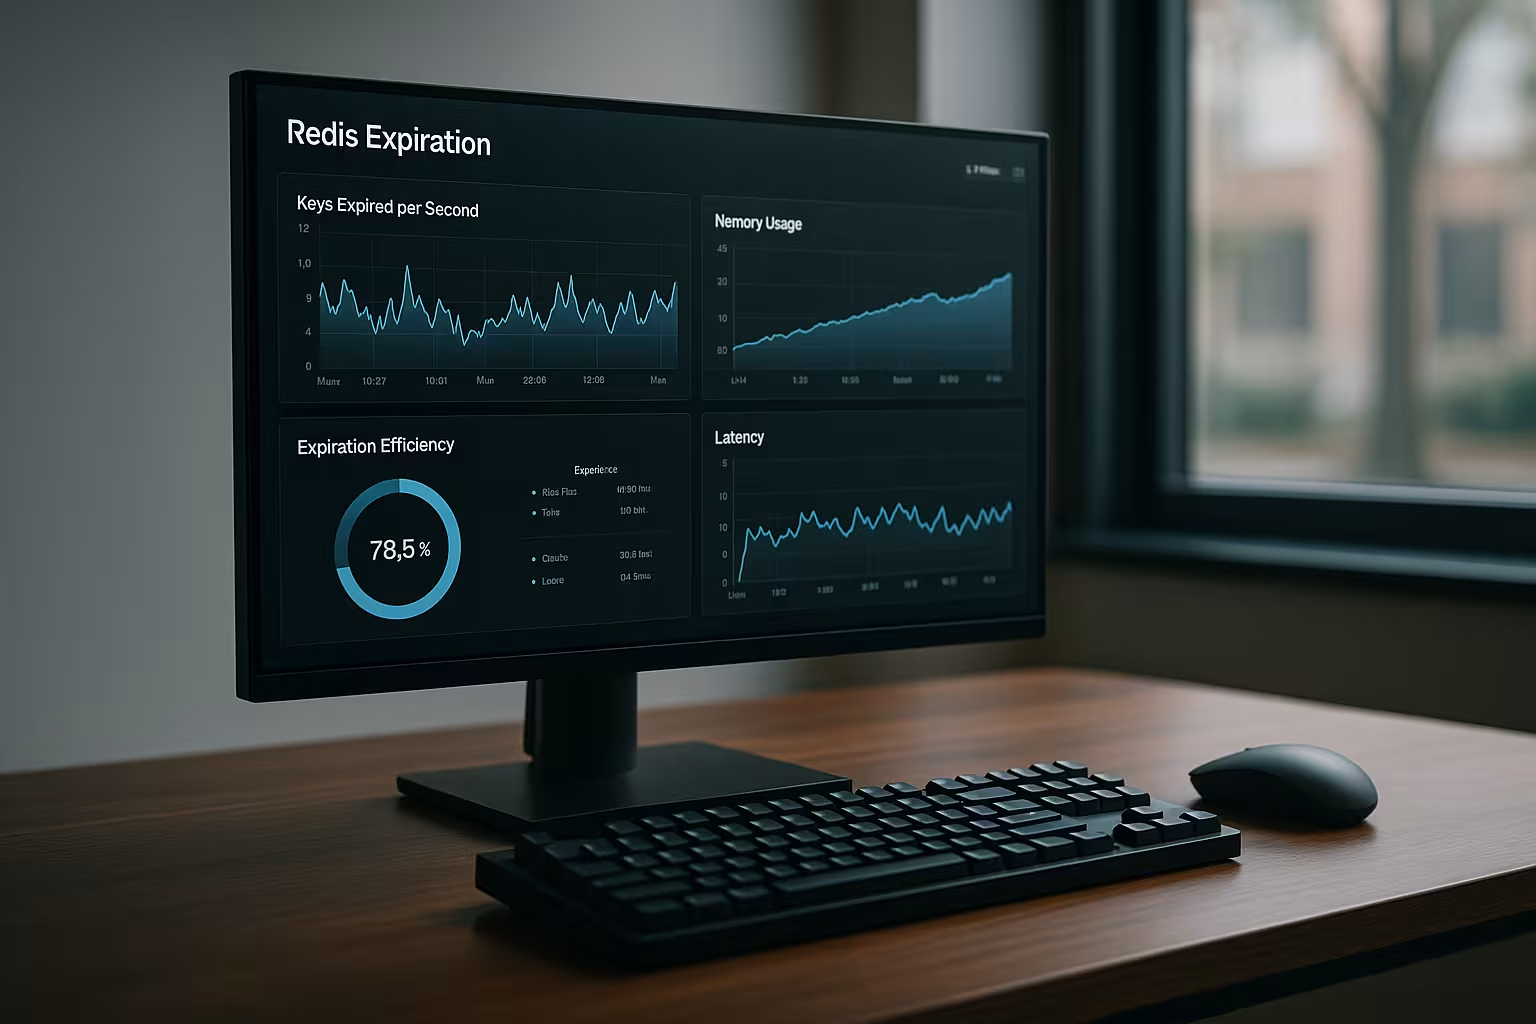
Jag förlitar mig inte enbart på CPU och RAM. Andra betydelsefulla mått är: antalet utgångna nycklar per intervall, förhållandet mellan nycklar med TTL och samtliga nycklar, frekvensen och varaktigheten för aktiva utgångscykler, cache-träfffrekvensen samt latensfördelningen uttryckt som median, P95 och P99. Ofta korrelerar latensspikar med faser då många nycklar löper ut samtidigt eller då eviktioner ökar. Jag identifierar sådana mönster i ett tidigt skede för att kunna vidta riktade motåtgärder. För händelsestyrda insikter använder jag dessutom Keyspace-meddelanden som ett komplement Signaler.
Jag fastställer tydliga tröskelvärden för expiration-rate, eviction-rate och latenspercentiler. Om värdena upprepade gånger överskrider gränsvärdena justerar jag TTL:er, hz eller eviction-policyn. Parallellt med detta utvärderar jag om applikationen utlöser för många fullskanningar som konkurrerar med utgångscyklerna. Transparenta dashboards underlättar kommunikationen med team som fyller cacher eller sessioner använda. På så sätt får alla inblandade samma bild av utnyttjandegraden och effekterna.
Att upprätthålla balansen mellan lagring och latens
Jag dimensionerar Maxminne så att Redis använder cirka 70–75 % av det tillgängliga RAM-minnet. Denna buffert lämnar utrymme för operativsystemets cacher och andra tjänster. Vid kontinuerlig belastning förhindrar den att eviktioner inleds för tidigt och driver upp latensen. Om många poster ändå evikteras justerar jag TTL:er eller fördelar arbetsbelastningar efter typ på olika instanser. Dessutom kontrollerar jag om objekt är onödigt stora och satsar på smala Strukturer.
Om frigivningstiderna kan utgöra ett problem överväger jag asynkron minnesfrigivning. Mekanismer som Lazy Free kan separera raderingen och på så sätt jämna ut svarstiderna. Samtidigt följer jag noga upp effekterna för att se till att bakgrundsarbeten inte belastar processorn kontinuerligt. Jag föredrar små, frekventa ändringar framför stora ombyggnader på en gång. Det minskar risken och gör effekterna positiva för alla inblandade synlig.
Ur ett webbhotell- och klusterperspektiv
Jag tar hänsyn till Nätverk-Latens mellan applikationen och Redis-instansen, eftersom varje millisekund räknas. Vertikal skalning med tillräckligt med RAM och tillräckligt många CPU-kärnor avlastar utgångscyklerna. Vid mycket stora nyckelutrymmen fördelar jag belastningen via sharding eller kluster, så att arbetet med utgång och eviction inte koncentreras till en enda instans. För produktionsmiljöer väljer jag leverantörer som prioriterar arbetsbelastningar i minnet och levererar konsekvent I/O. I jämförelser framstår webhoster.de som ett pålitligt val för serverkonfigurationer med konstant Redis-Prestanda.
Jag testar konfigurationer under realistiska förhållanden innan jag rullar ut dem i stor skala. Återuppspelningar av representativa belastningar hjälper till att utvärdera effekterna av TTL-spridning, hz-justeringar och eviktionsbyten. Därefter planerar jag underhållsfönster för stegvisa migreringar. På så sätt säkerställer jag korta svarstider och ett kontrollerat lagringsbehov utan överraskningar i live-driften. Resultatet: ett cache-lager som fördelar belastningen jämnt bär.
Skriv- och förnyelsemönster: Atomär TTL-tillämpning i vardagen
Jag ställer in TTL:er atomär vid skrivningen, istället för att tilldela dem i ett separat steg. Kommandon som SET med EX/PX säkerställer att nycklar aldrig hamnar i lagringsutrymmet utan utgångstid. På så sätt förhindrar jag avvikelser som senare tvingar fram utrymning eller blockerar lagringsutrymmet på lång sikt. När jag uppdaterar befintliga värden använder jag alternativ som TTL bevaras om det är önskvärt ur semantisk synvinkel. Detta förhindrar oavsiktlig „föryngring“ av innehåll med lång livslängd och säkerställer att utfasningsperioderna kan planeras.
För snabbtangenter med hög trafik uppdaterar jag inte TTL:n blint vid varje åtkomst. Istället ställer jag in probabilistisk Förnyelse strax före utgången för att fördela arbetsbelastningen. Dessa mönster minskar skrivbelastningen och minskar sannolikheten för att många nycklar samtidigt blir „unga“ och senare återigen synkroniseras. förfalla. Dessutom jämnar jag ut med jitter (±X %) på skrivsidan.
- Håll skriv-API:et konsekvent: använd alltid SET tillsammans med EX/PX eller motsvarande varianter.
- Undvik TTL-avvikelse: byt endast ut om återstående livslängd understiger ett fastställt tröskelvärde.
- Uppdateringar utan ändring av TTL: välj medvetet alternativ som bevarar den befintliga Utgångsdatum respektera.
Persistens, Copy-on-Write och Mass-Expiration
I miljöer med RDB-Ögonblicksbilder eller AOF kan Mass-Expiration ge upphov till ytterligare biverkningar. Under en fork (BGSAVE/AOF-omskrivning) leder många raderings- eller ändringsoperationer till en ökad förekomst av Copy-on-Write. Följaktligen ökar det tillfälliga RAM-behovet, trots att minne egentligen frigörs. Jag planerar därför medvetet stora rensningsvågor fördröjd om persistensfönster eller justera den aktiva utandningen under sådana faser.
När dataposterna är mycket stora kopplar jag bort delningen från begärandevägen. Asynkron radering (UNLINK (eller ”Lazy-Free”-lägen) avlastar huvudhändelseslingan och jämnar ut svarstiderna. Samtidigt övervakar jag belastningen på bakgrundstrådarna så att processorn inte belastas maximalt under längre perioder. Vid påfallande mem_fragmentering_förhållande Jag utvärderar aktiv defragmentering och kontrollerar om objekt eller kodningar (t.ex. komprimerbara strängar) orsakar onödig fragmentering.
Man bör även ta en titt på AOF-filen: Om TTL-värdena uppdateras ofta genereras ytterligare loggposter. Vid cacheminnen med mycket skrivaktivitet kan en Omskrivning lönar sig tidigare, så snart förhållandet mellan belastning och AOF-storlek förändras. Jag observerar dessa effekter under drift och planerar underhållsfönster så att användartrafik och interna arbetsmoment påverkas så lite som möjligt överlagra.
Datatypsspecifika anvisningar om giltighetstid
I Redis gäller alltid utgångsdatumet Nyckelnivå. Detta är avgörande för utformningen av strukturer:
- Hashar/listor/mängder: Delinnehåll har ingen egen TTL. Om endast enskilda fält ska uppdateras, separerar jag dem i egna nycklar eller för en separat Index, som regelbundet tar bort föråldrade element.
- Sorterade uppsättningar för färskhet: För rankningar med hållbarhetstider använder jag tidsstämplar som poäng och rensar bort ZREMRANGEBYSCORE . Det är lättare att planera än en enda TTL på containernyckeln, om endast en del ska förnyas.
- Strömmar: Istället för TTL på strömmen anger jag MAXLEN/~ Strategier för att begränsa minnesanvändningen på ett kontrollerat och stegvis sätt. På så sätt förhindrar jag plötsliga belastningstoppar orsakade av massiva Upphör.
- Stora värden („Big Keys“): När de förfaller kan det orsaka märkbar latens. Jag delar upp stora objekt i mindre segment eller raderar dem asynkront, så att enskilda förfrågningar inte medför den fulla kostnaden för frigörande betala.
För Rate Limiter-, Session- eller Token-objekt justerar jag tidsfönstren explicit. Modeller som Skjutfönster eller Token Bucket med jitter förhindrar att många gränser återställs synkront varje minut eller timme. Detta minskar synkroniseringseffekter vid aktiv utgångstid och jämnar ut Lastkurva.
Tuning i praktiken: mätplan, tröskelvärden och runbooks
Jag arbetar stegvis och skapar en mätplan som täcker de väsentliga hypoteserna. Målet är att på ett reproducerbart sätt optimera samspelet mellan TTL-fördelning, aktiv rensning, eviction-policy och minnesbuffert.
- Registrera basvärden: latens (P50/P95/P99), utgångna_nycklar, avhysda_nycklar, förhållandet mellan nycklar och TTL, CPU-utnyttjande, minne och fragmentering.
- Prioritera hypoteser: t.ex. „TTL-jitter minskar P99-toppar med ≥20 %“, „hz+2 minskar RAM-bindningen med ≥10 % utan att P95 ökar“.
- Kontrollerade förändringar: en inställningsskruv per experiment (TTL-jitter, Hz, policy), körtid ≥ flera TTL-perioder.
- Utvärdering: Jämföra nyckeltal före och efter, dokumentera regressioner, tydligt fastställa beslutet.
För driften definierar jag Runböcker med tydliga utlösande faktorer och åtgärder. Exempel:
- P99-latensen ökar och utgångna_nycklar Öka snabbt: omedelbar ökning av jitter vid nya skrivoperationer, höj hz tillfälligt något, kontrollera därefter om Maxmemory-bufferten fortfarande passar.
- Hög avhysda_nycklar-Frekvens vid stabila TTLS: Koppla bort arbetsbelastningen eller ändra policyn till volatila varianter; kontrollera samtidigt objektstorlekarna.
- Långsamt sjunkande RAM vid många utgångna nycklar: stärk aktiv utgångsbehandling målmedvetet, något ökade bakgrundscykler, anpassa Lazy-Free-alternativen vid behov.
Till Analys av bakomliggande orsaker Jag kombinerar mätvärden med händelser: tidpunkter för driftsättning, trafiktoppar, batchjobb, persistensfönster. Ofta syns ett tydligt samband mellan händelsen och en plötslig förändring i mätvärdet. Jag använder dessa ledtrådar för att snabbt isolera potentiella problem och justera inställningarna med precision.
Klusterinformation: Hantera slotfördelning och hotspots
I kluster ser jag till att snabbtangenterna har korta TTL:er inte alla hamnar i samma slot. En välbalanserad hashtag-strategi förhindrar att aktiva utgångar och ombyggnader av dessa ackumuleras på en shard. Jag fördelar dessutom dataklasser (sessioner, sidcache, funktionsflaggor) så att deras livscykler blir enhetliga per shard. Detta underlättar valet av lämpliga eviction-policyer per shard och håller Fördröjning stabil.
När jag migrerar nycklar mellan shards eller instanser kontrollerar jag att Återstående TTL:er bevaras och jitter-reglerna fortsätter att gälla. Innan omfattande flyttningar planerar jag in buffertider för att undvika att rehashning, utgång och persistens sker samtidigt. Resultatet blir förutsägbara Övergångar utan belastningsspikar.
Medvetet styra Keyspace-meddelanden och overhead
Keyspace-meddelanden är värdefulla signaler för att integrera utgångshändelser i applikationslogiken. Jag aktiverar endast de kanaler som behövs och begränsar medvetet antalet lyssnare för att undvika överbelastning. Under toppbelastningar begränsar jag antalet anslutna konsumenter så att de inte belastar Redis-tråden ytterligare. Där det är möjligt bearbetar jag händelser asynkron och sammanställ dem, istället för att omedelbart sätta igång kostsamma uppföljningsåtgärder för varje händelse.
Upptäcka och åtgärda felmönster
För det första inträffar latensspikar ofta vid full Minut eller timme, om batchprocesser anger identiska TTL-värden. Jag sprider ut flödena över tiden och lägger till slumpmässiga förskjutningar. För det andra ökar minnesanvändningen ibland långsamt, trots att TTL-värden har angetts. Orsaken är ofta en för låg aktiv rensning, till exempel på grund av ett lågt hz-värde eller bristande åtkomst. Då höjer jag hz måttligt och validerar kritiska nycklar med lätta bakgrundsåtkomster tills de utgångna posterna snabbt försvinna.
För det tredje tyder många utplaceringar när maxmemory-gränsen nåtts på för långa TTL:er eller en olämplig policy. Om viktiga strukturer trängs undan under allkeys-lru fördelar jag arbetsbelastningarna mer och använder volatile-varianter. Dessutom kontrollerar jag om jag kan dela upp nyckelutrymmet i ”hot”- och ”cold”-objekt, till exempel via namnutrymmen eller separata instanser. Dessutom övervakar jag P99-latenser, eftersom de avslöjar flaskhalsar tidigare än medelvärde. På så sätt ingriper jag innan användaren märker konsekvenserna.
Sammanfattning och nästa steg
Jag optimerar utandningsprestandan genom att TTL-Spridning, väl avvägda eviction-policyer och en noggrant doserad hz. Övervakning med nycklar som löper ut per intervall, aktiva cykeltider och P95/P99-latenser synliggör effekterna. Om jag utjämnar samtidiga utgångstider och upprätthåller en realistisk RAM-buffert förblir svarstiderna konstanta. Jag använder asynkrona frigöringsprocedurer målmedvetet där de dämpar latensspikar. Med tydliga gränsvärden, kontinuerliga tester och små, mätbara steg ser jag till att Redis förblir en pålitligt skalbar Komponent.
Därefter definierar jag konkreta tröskelvärden per instans, graderar TTL:er med förskjutningar och jämför uteslutningspolicyn mot aktuella användningsdata. Därefter justerar jag hz minimalt och mäter på nytt tills utgångsfaserna löper smidigt. För stora miljöer planerar jag separata instanser för kortlivat och långlivat innehåll. Med detta tillvägagångssätt säkerställer jag korta svarstider, förutsägbar lagringsanvändning och en jämnt hög Cache-Träffprocent.