
Adaptive Flushing in MariaDB steuert, wie schnell ich Dirty Pages aus dem Buffer Pool auf den Datenträger schreibe, damit das Redo Log nie zum Nadelöhr wird. Wenn ich MariaDB Adaptive Flushing optimiere, sinken Latenzspitzen, der Checkpoint-Fortschritt bleibt stabil und Write-Last bleibt planbar.
Zentrale Punkte
- Messwerte zuerst: Redo-Log-Füllstand, Dirty-Page-Anteil, Checkpoint-Age
- I/O-Kapazität real bestimmen, nicht schätzen
- Schwellwerte sinnvoll setzen: adaptive_flushing_lwm und Dirty-Page-LWM
- Hintergrund-I/O dosieren: io_capacity und io_capacity_max
- Redo-Logs passend dimensionieren für gleichmäßigen Fluss
Wie Adaptive Flushing in MariaDB arbeitet
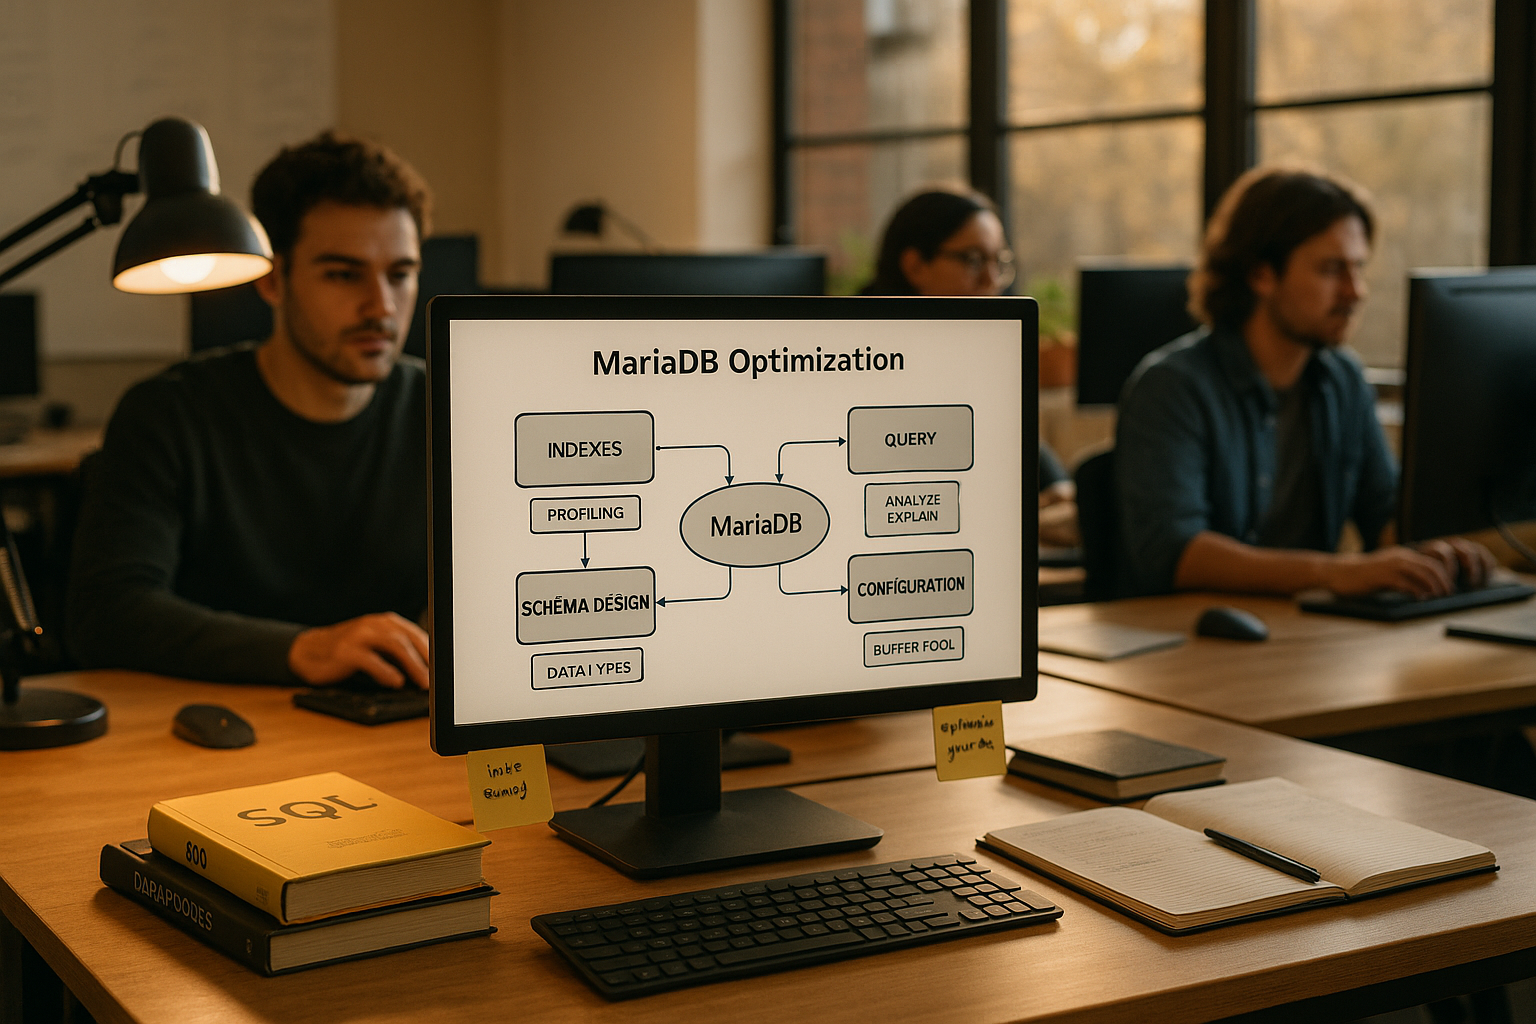
Ich aktiviere die dynamische Logik über innodb_adaptive_flushing und steuere das Frühwarnverhalten mit innodb_adaptive_flushing_lwm. Je stärker das Redo Log gefüllt ist und je schneller es wächst, desto aggressiver flusht InnoDB, damit kein Engpass entsteht. Diese Regel bindet die Flush-Rate an den tatsächlichen Änderungsdurchsatz, wodurch kurze I/O-Bursts seltener auftreten. Laut MariaDB-Dokumentation richtet sich die Intensität am Checkpoint-Fortschritt aus, um Wartezeiten auf Disk-Schreibvorgänge zu vermeiden. Ich halte mir dabei vor Augen, dass Adaptive Flushing die Arbeit verteilt, jedoch keine zu geringe Speicherleistung ausgleicht.
Kennzahlen verstehen: Redo-Log, Dirty Pages und Checkpoints
Ich beobachte zuerst den prozentualen Füllstand des Redo Logs, die Dirty-Page-Quote im Buffer Pool und die Checkpoint-Age. Diese drei Größen zeigen mir, ob der Server frühzeitig und gleichmäßig flushen kann oder ob sich Arbeit aufstaut. Wächst die Checkpoint-Age zu rasch, reagiert Adaptive Flushing, doch ich prüfe dann zusätzlich die Storage-Latenz. Für Detailfragen zur I/O-Strategie hilft mir ein Blick auf die passenden Flush-Methoden, weil sie bestimmen, wie effizient der Kernel die Schreibbefehle abarbeitet. Ich verknüpfe diese Signale mit der gemessenen I/O-Kapazität, damit ich Änderungen an Schwellwerten zielgerichtet vornehme und das Gesamtsystem schlüssig bleibt.
Die Stellschrauben richtig einstellen
Ich starte mit innodb_io_capacity und setze den Wert nahe an die reale Dauerleistung des Speichers, nicht an theoretische Maxima. Für Spitzen halte ich innodb_io_capacity_max deutlich höher, damit InnoDB bei Druck kurzfristig zulegen kann, ohne die CPU zu überfahren. Den Schwellwert innodb_adaptive_flushing_lwm lege ich so, dass der Server spürbar vor dem vollen Redo Log mit dem Preflushing beginnt. Zusätzlich setze ich innodb_max_dirty_pages_pct_lwm so, dass InnoDB bei wachsender Dirty-Page-Quote früh gegensteuert und keine Staus entstehen. Ich ändere nur eine Größe pro Zyklus, protokolliere die Wirkung minutiös und gebe dem System mehrere Lastphasen Zeit, bevor ich weiter optimiere.
I/O-Kapazität konkret vermessen
Ich messe die kontinuierliche Schreibleistung während Produktionslast, weil synthetische Peak-Tests oft falsche Hoffnungen machen und die Gleichmäßigkeit verschleiern. Aussagekräftig sind mittel- bis langfristige Durchschnitte und Perzentile, die kurze Glättungen überstehen. Ich schaue mir Write-IOPS, Write-Throughput, Latenzen und die Verteilung der Response-Zeiten an, damit ich nicht nur den Mittelwert betrachte. Wer nur den Maximalwert ansetzt, riskiert aggressive Flush-Phasen, während die eigentlichen Transaktionen langsamer werden. Ich ziehe Schlussfolgerungen für innodb_io_capacity aus dem beobachteten Dauerverhalten, nicht aus kurzlebigen Bestzeiten.
Startwerte und Grenzwerte im Überblick
Ich nutze Startwerte als Ausgangspunkt, nie als Dogma, und überprüfe sie gegen die reale Workload, die Größe des Buffer Pools und das Wachstum des Redo Logs. SSD- und NVMe-Systeme tragen klar höhere Werte als HDDs, doch ich setze die Raten nur so hoch, dass Lesezugriffe nicht in die Warteschlange geraten. Für belebte Systeme skaliere ich die Kapazität langsam nach oben und beobachte Latenz, Checkpoint-Age und CPU-Verbrauch gemeinsam. Sinkt die Dirty-Page-Quote gleichmäßig und verringern sich die Ausschläge im Redo-Log-Füllstand, treffe ich mich mit einem gesunden Sicherheitsabstand. Kritisch bleibt für mich, dass ich Spitzen kontrolliere, statt sie mit übertriebenem Hintergrund-I/O zu überspielen.
| Variable | Wirkung | Typischer Startwert HDD | Typischer Startwert SSD | Typischer Startwert NVMe | Worauf ich achte |
|---|---|---|---|---|---|
| innodb_adaptive_flushing | Aktiviert dynamischen Flush | ON | ON | ON | Ausgleich von Bursts |
| innodb_adaptive_flushing_lwm | Frühes Preflushing | 20–30% | 20–40% | 30–50% | Redo-Log-Füllstand |
| innodb_io_capacity | Basis-Flush-Rate | 100–300 | 800–2000 | 2000–8000 | Dauer-Write-IOPS |
| innodb_io_capacity_max | Notfallgrenze | 400–800 | 2000–6000 | 6000–20000 | Spitzen abtragen |
| innodb_max_dirty_pages_pct_lwm | Dirty-Page-Low-Water | 5–10% | 5–15% | 5–15% | Frühes Gegensteuern |
Problemfälle und Symptome erkennen
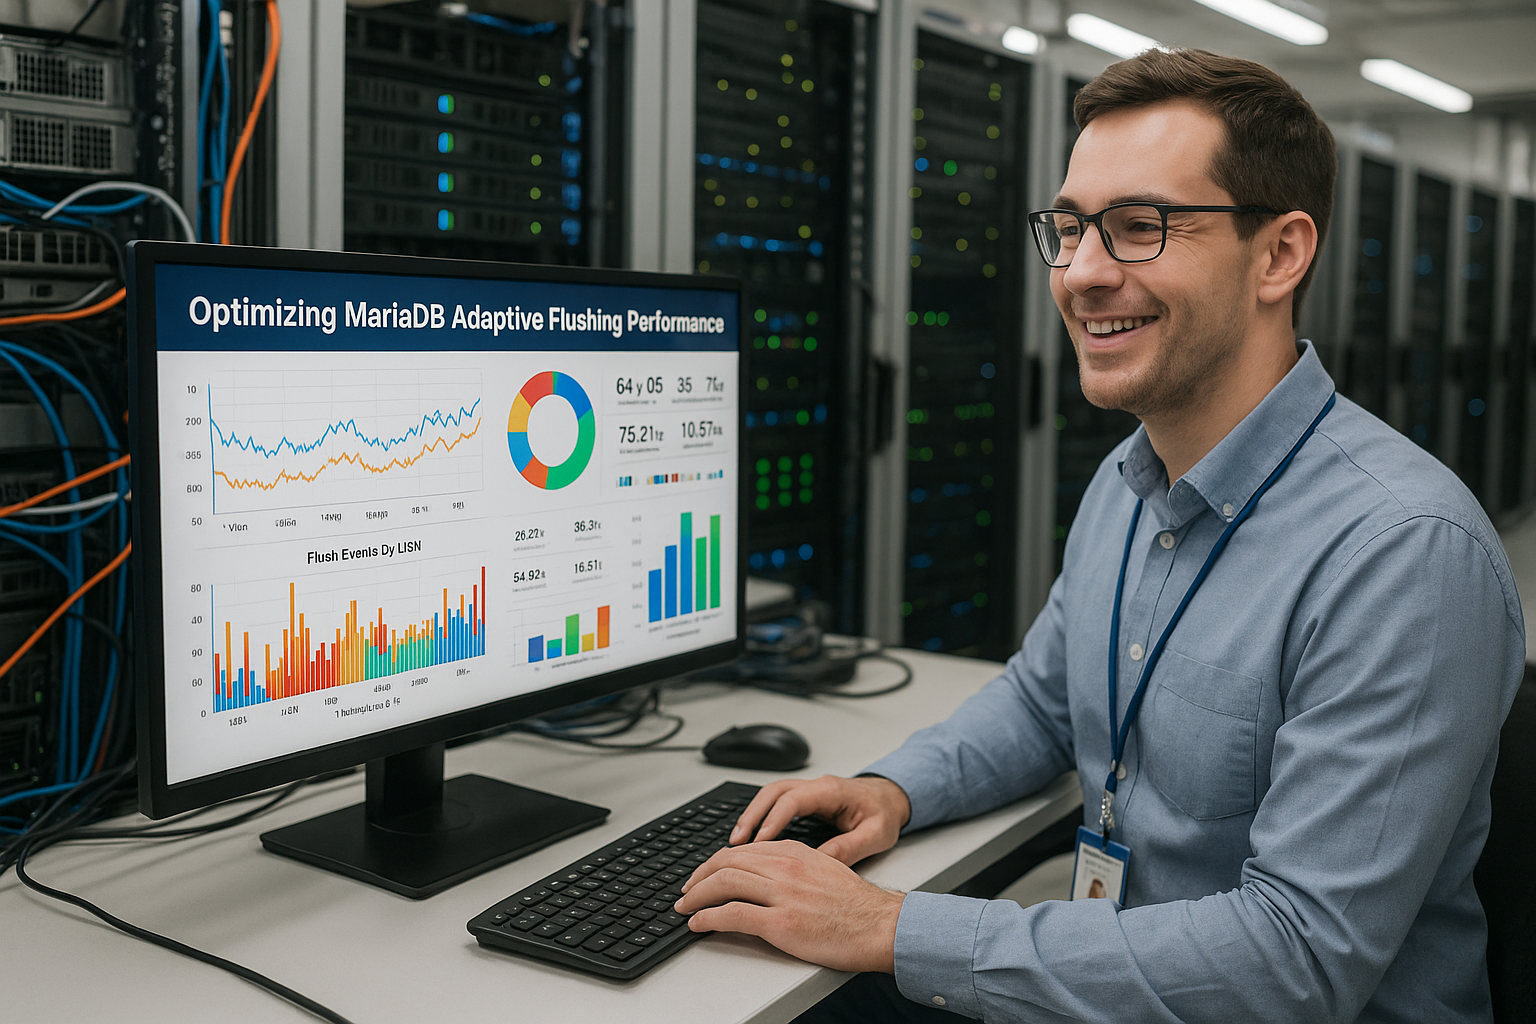
Wenn ich Flush-Spitzen sehe, prüfe ich zuerst den I/O-Wert: liegt er zu niedrig, stauen sich Dirty Pages und das System muss eilig aufräumen. Steht der Wert zu hoch, überlagert Hintergrund-I/O die Live-Workload und zwingt Reads in Wartezeiten. Eine träge Checkpoint-Age, die plötzlich hochschnellt, verrät mir, dass der Server zu spät reagiert. Gleichzeitig signalisiert ein rasch wachsender Redo-Log-Füllstand, dass die Schreibseite nicht hinterherkommt oder das Log knapp dimensioniert ist. Ich lese diese Muster gemeinsam, weil eine einzelne Zahl das Verhalten von Adaptive Flushing selten vollständig erklärt.
Redo-Log dimensionieren für gleichmäßige Last
Ich wähle die Größe des Redo Logs so, dass genug Puffer für Lastwellen bleibt, ohne dass Checkpoints zu lang werden. Ein größeres Log gibt Adaptive Flushing mehr Spielraum, die Arbeit zu strecken, doch ich achte auf Recovery-Zeiten und Speicherbudget. Wächst das Log im Sekundentakt Richtung Limit, senkt eine nüchterne Erhöhung den Druck und glättet die Flush-Kurve. Bringt die Vergrößerung keine Entlastung, liegt das Problem meist in unpassender I/O-Kapazität oder schwankender Storage-Latenz. Ich entscheide erst nach Beobachtungsfenstern, nicht nach Momentaufnahmen, ob ich die Log-Größe nochmals anhebe.
Page Cleaner Threads und Parallelität
Ich schaue mir die Anzahl der Page-Cleaner-Threads an, weil sie die parallele Flush-Leistung der Buffer-Pool-Instanzen steuern. Bei hohen Schreiblasten bringt zusätzliche Parallelität mehr Durchsatz, doch ich beobachte die Storage-Queue engmaschig. Verliert der Datenträger an Aussagekraft durch überfüllte Queues, reduziere ich die Threadzahl oder zügle die I/O-Kapazität. Für Hintergründe zu diesem Mechanismus hilft mir der Überblick zu Page-Cleaner-Threads, damit ich die Balance zwischen Druck und Fairness halte. Ich entscheide pragmatisch: so viele Threads wie nötig, so wenige wie sinnvoll, damit Reads nicht ins Hintertreffen geraten.
Doublewrite Buffer: Sicherheit vs. Schreibrate
Ich berücksichtige den Doublewrite-Buffer, denn er schützt vor Teil-Schreibfehlern, kostet aber zusätzliche I/O. Auf zuverlässigen NVMe-Systemen fällt der Mehraufwand geringer ins Gewicht, während er auf langsamerem Storage stärker auffällt. Ich messe die tatsächliche Wirkung auf Latenzen und Page-Flush-Rate, bevor ich an dieser Stellschraube drehe. Für eine fundierte Abwägung greife ich zu vertiefenden Hinweisen zum Doublewrite Buffer und prüfe, ob ein anderes Risiko- und Performance-Profil passt. Ich entscheide mich nie leichtfertig, weil Datensicherheit und Durchsatz hier in direkter Wechselwirkung stehen.
Monitoring und Metriken in der Praxis
Ich werte den Dirty-Page-Anteil, das Verhältnis von Flush-Rate zu Änderungsrate und den Verlauf der Checkpoint-Age aus. Zusätzlich beobachte ich die prozentuale Auslastung des Redo Logs über die Zeit, weil ein linearer Anstieg auf knappe Schwellwerte hindeutet. Ich halte die I/O-Latenzen neben den InnoDB-Statistiken im Blick, damit ich Ursache und Wirkung sauber zuordnen kann. Nach jeder Parameteränderung vergleiche ich identische Lastfenster, sonst ziehe ich falsche Schlüsse. Ich dokumentiere die Kurven, weil ein Bild mehr verrät als ein einzelner Messpunkt und ich so Trendbrüche sicher erkenne.
Schritt-für-Schritt-Tuning-Plan
Ich starte mit einer realistischen Messung der Schreibrate und setze daraus innodb_io_capacity fest. Danach definiere ich innodb_io_capacity_max als Notnagel für Drucksituationen, mit ausreichend Abstand zur Basis. Als Nächstes prüfe ich innodb_adaptive_flushing_lwm und senke ihn, wenn die Checkpoint-Age zu spät fällt. Anschließend setze ich innodb_max_dirty_pages_pct_lwm so, dass Preflushing rechtzeitig beginnt und Spitzen früh abgebaut werden. Am Ende justiere ich die Redo-Log-Größe, beobachte erneut mehrere Lastzyklen und dokumentiere jede Veränderung, bevor ich den nächsten Schritt wage.
Flush-Mechanik unter der Haube
Ich unterscheide zwischen zwei Haupttreibern fürs Schreiben: dem Flush-List-Flushing (getrieben vom Checkpoint-Fortschritt) und dem LRU-Flushing (getrieben von Free-List-Mangel). Läuft der Buffer Pool voll und fehlen freie Seiten, zwingt mich LRU-Flushing zu unmittelbaren Writes, was Latenzspitzen erzeugt. Adaptive Flushing zielt darauf, durch kontinuierliches Flush-List-Flushing diese Zwangslagen zu vermeiden. Damit das gelingt, halte ich den Anteil freier Seiten stabil und überwache Werte wie LRU-Scan-Tiefe und die Auslastung pro Buffer-Pool-Instanz. Je gleichmäßiger die Flush-List abgearbeitet wird, desto seltener muss ich im Foreground auf freie Seiten warten.
Ich beachte dabei die Beziehung zwischen innodb_buffer_pool_instances, innodb_page_cleaners und der physikalischen I/O-Kapazität. Mehr Instanzen und Cleaner-Threads erhöhen die Parallelität, doch nur so weit sinnvoll, wie die Storage-Warteschlangen nicht überlaufen. Erreichen Flush-Operationen hohe Queuelängen, ist das ein Zeichen, dass ich schon früher und langsamer hätte flushen müssen – genau das adressiere ich über innodb_adaptive_flushing_lwm und die Basis-/Max-Kapazitäten.
Transaktions-Commit, Redo und Binlog im Zusammenhang
Ich betrachte Commit-Pfade und Haltbarkeitsgarantien im Kontext von Flush-Glättung. innodb_flush_log_at_trx_commit und die Binlog-Synchronisation beeinflussen, wie oft das System fsyncs ausführt und wie stark kurzfristige Peaks auftreten. Meine Leitplanken:
- 1: Maximale Haltbarkeit (Redo bei jedem Commit auf Datenträger). Sicher, aber fsync-intensiv und potenziell zackiger.
- 2: Redo wird pro Sekunde geflusht, Commit schreibt nur in den OS-Cache. Geringere Spitzen, dafür riskiere ich Datenverlust bei OS-/Host-Ausfall.
- 0: Ähnlich 2, jedoch noch aggressiver gecached. Für Produktivsysteme nur mit Bedacht.
Zusammen mit der Binlog-Synchronisation (sync_binlog) und Group-Commit-Effekten kann ich Commits bündeln und die Zahl der harten Synchronisationen verringern. Wichtig ist, dass ich diese Hebel nicht als Ersatz für sauberes Adaptive-Flushing-Tuning missbrauche. Ich bewerte immer Risiko, Compliance-Anforderungen und das gewünschte Latenzprofil gemeinsam und justiere nur so weit, wie es die Geschäftsregeln erlauben.
Purge-Threads, History Length und Langläufer
Ich habe die InnoDB-Purge im Blick: Viele gelöschte oder aktualisierte Zeilen erzeugen Undo-Daten, die asynchron bereinigt werden. Wächst die History Length stark, nimmt der Hintergrundaufwand zu und konkurriert mit den Page-Cleanern um I/O. Das kann Adaptive Flushing indirekt ausbremsen. Gegenmittel sind ein adäquater Wert für die Purge-Parallelität und das Vermeiden von Langläufer-Transaktionen, die die History künstlich offenhalten. Ich plane außerdem Batch-Operationen so, dass ich das Redo- und Undo-Aufkommen kontrolliere, statt schubweise Millionen Zeilen in kurzer Zeit zu verändern.
Change Buffer und Merge-Phasen
Ich berücksichtige den Change Buffer bei intensiven Sekundärindex-Updates. Er reduziert Random-I/O zur Laufzeit, verschiebt einen Teil der Arbeit aber in spätere Merge-Phasen. Diese Merges können zusätzliche Flush-Last erzeugen, wenn sie ungünstig mit Produktionsspitzen zusammenfallen. Ich beobachte daher Größe und Aktivität des Change Buffers, limitiere ihn bei Bedarf und streue Bulk-Änderungen so, dass Merge-Phasen nicht mit Stoßzeiten kollidieren. Dadurch bleibt die Flush-Rate planbarer und gleichmäßiger.
Flush-Methoden und Dateisystem-Einflüsse
Ich entscheide bewusst über die Flush-Methode und die Dateisystem-Optionen. O_DIRECT vermeidet doppelte Caches und glättet dadurch oft die Schreiblatenzen, während AIO und Fsync-Pfade ihre eigenen Charakteristika haben. Ich messe, wie sich diese Methoden auf die Latenzverteilung und die Stabilität des Checkpoint-Fortschritts auswirken und referenziere bei Detailfragen die Hinweise zu Flush-Methoden. Ergänzend prüfe ich Dateisystem-Mount-Optionen und Wartungsroutinen (z. B. konsistente TRIM-/Discard-Strategien bei SSDs), damit der Unterbau nicht unbemerkt Jitter einführt.
Diagnose: Statusausgaben richtig lesen
Ich ziehe SHOW ENGINE INNODB STATUS heran, um Checkpoint-Age und Flush-Fortschritt zu beurteilen. Aus Log sequence number, Log flushed up to und Last checkpoint at ermittle ich, wie groß der Abstand zwischen erzeugten und persistierten Änderungen ist. Wächst der Abstand kontinuierlich stärker, als es die Redo-Log-Größe zulässt, ist mein Hintergrund-Flush zu zaghaft oder die I/O-Latenz zu hoch. Ich vergleiche diese Werte mit den InnoDB-Metriken zu Dirty Pages, Flush-Rate und Page-Cleaner-Aktivität, damit ich zielgerichtet an den passenden Stellschrauben drehe, statt Symptome zu kurieren.
Betriebsszenarien: Bulk, DDL und Wartungsfenster
Ich plane Bulk Loads und umfangreiche DDL-Operationen so, dass Adaptive Flushing nicht überfahren wird. Für planbare Wartungsfenster erhöhe ich temporär innodb_io_capacity_max, um anstehende Writes kontrolliert abzutragen, und senke ihn im Anschluss wieder auf das normale Niveau. Bei großen Imports moderiere ich Commit-Frequenzen, damit Redo-Wachstum und Checkpoint-Fortschritt Schritt halten. Ich beobachte währenddessen kontinuierlich Redo-Log-Füllstand, Dirty-Page-Quote und die Latenzperzentile, um bei Abweichungen sofort gegensteuern zu können.
Häufige Fehlannahmen und Anti-Pattern
Ich tappe nicht in die Falle, innodb_io_capacity_max als Dauerzustand zu nutzen. Ein zu hoher Max-Wert kann die Speicher-Queues fluten und Realtime-Lesezugriffe ausbremsen. Ebenso wenig „verstecke“ ich schwachen Speicher hinter einem riesigen Redo Log – größere Logs glätten, sie schaffen aber keine I/O-Reserven. Und ich nehme Latenzspitzen nicht als gegeben hin: Oft sind sie Resultat von zu spätem Preflushing oder stark schwankender Hintergrund-Last, die ich durch niedrigere LWM-Schwellen und realistische Kapazitätswerte entschärfen kann. Schließlich vermeide ich es, mehrere Stellschrauben gleichzeitig zu verändern; sonst verliere ich die Kausalität und kann Verbesserungen nicht reproduzierbar machen.
Kurz zusammengefasst
Ich nutze Adaptive Flushing, um Schreibarbeit gleichmäßig über die Zeit zu verteilen und damit Latenzspitzen zu vermeiden. Den größten Hebel liefert eine saubere Bestimmung von innodb_io_capacity und ein sinnvolles Verhältnis zu innodb_io_capacity_max. Früh greifende Schwellwerte für Redo-Log-Füllstand und Dirty-Page-Quote helfen mir, Warteschlangen klein zu halten. Mit passenden Redo-Logs, vernünftiger Parallelität der Page-Cleaner-Threads und wachem Monitoring schaffe ich verlässlichere Schreibroutinen. Laut MariaDB-Dokumentation zu Systemvariablen und Page-Flushing wirken diese Stellschrauben gemeinsam – ich justiere sie schrittweise und halte die Wirkung im Blick, bis das System ruhig und planbar läuft.


