
Ich vergleiche die wichtigsten Methoden für MariaDB Flush und zeige, wie ich innodb flush so einstelle, dass Schreiblatenz sinkt und Daten sicher bleiben. Der Fokus liegt auf den Optionen von innodb_flush_method, dem Durability-Regler innodb_flush_log_at_trx_commit sowie sinnvollen Werten für Dirty Pages und I/O-Kapazität auf HDD, SSD und NVMe.
Zentrale Punkte
- innodb_flush_method bestimmt, wie InnoDB mit dem OS-Cache interagiert und Double-Caching vermeidet.
- innodb_flush_log_at_trx_commit regelt Haltbarkeit vs. Latenz pro Commit.
- Dirty Pages und I/O-Kapazität glätten Schreibraten und verhindern Flush-Stürme.
- Flush-Neighbors trennt HDD-optimierte von SSD/NVMe-optimierten Strategien.
- Cloud-Setups erfordern O_DIRECT, passendes IOPS-Limit und sauberes Monitoring.
Was bedeutet innodb_flush_method konkret?
Ich wähle die Flush-Methode danach aus, wie InnoDB mit dem Betriebssystem-Cache zusammenarbeitet. Mit fsync landen Daten erst im OS-Cache und werden dann per fsync dauerhaft geschrieben; das kann zu Double-Caching führen. Setze ich O_DIRECT, umgeht InnoDB weitgehend den Page-Cache, was RAM spart und auf SSD/NVMe fast immer hilft. O_DSYNC nutzt Write-Through und reduziert Buffering, was in speziellen Kombinationen sinnvoll sein kann. O_DIRECT_NO_FSYNC baut auf O_DIRECT auf und passt das Sync-Verhalten an, was auf verlässlicher Hardware mit eigenem Schutzmechanismus eine starke Option ist.
Typische Werte und Versionen
Ab MariaDB 10.6 ist O_DIRECT oft die Voreinstellung, weil es Double-Caching vermeidet. In älteren Versionen dominiert fsync, was für HDD-Setups noch akzeptabel sein kann. Ab 11.0 steuern weitere Variablen wie innodb_data_file_buffering und innodb_log_file_buffering Details des Bufferings. Für die Praxis bleibt innodb_flush_method der zentrale Hebel, den ich zuerst prüfe. Danach feile ich an Detailparametern, bis Latenzen sinken und Durchsatz konstant bleibt.
innodb_flush_log_at_trx_commit gezielt einsetzen
Ich betrachte Durability und Latenz getrennt, denn innodb_flush_log_at_trx_commit bestimmt beides. Der Wert 1 schreibt und fsync’t bei jedem Commit, was maximale Sicherheit bietet, aber langsame Disks stark bremst. Wert 2 schreibt bei Commit in den OS-Cache und fsync’t ungefähr einmal pro Sekunde; das senkt Latenz, riskiert jedoch bei Stromausfall bis zu einer Sekunde Datenverlust. Wert 0 verschiebt Log-Schreibvorgänge komplett in den Sekundentakt und liefert höchste Schreibleistung mit dem größten Risiko. Wer zusätzlich auf die Binlog-Strategie achtet, koppelt Commit-Latenzen klug an die Replikationsanforderungen; Details zum Zusammenspiel erkläre ich hier: Binary Logs.
Page-Flushing und Dirty-Pages steuern
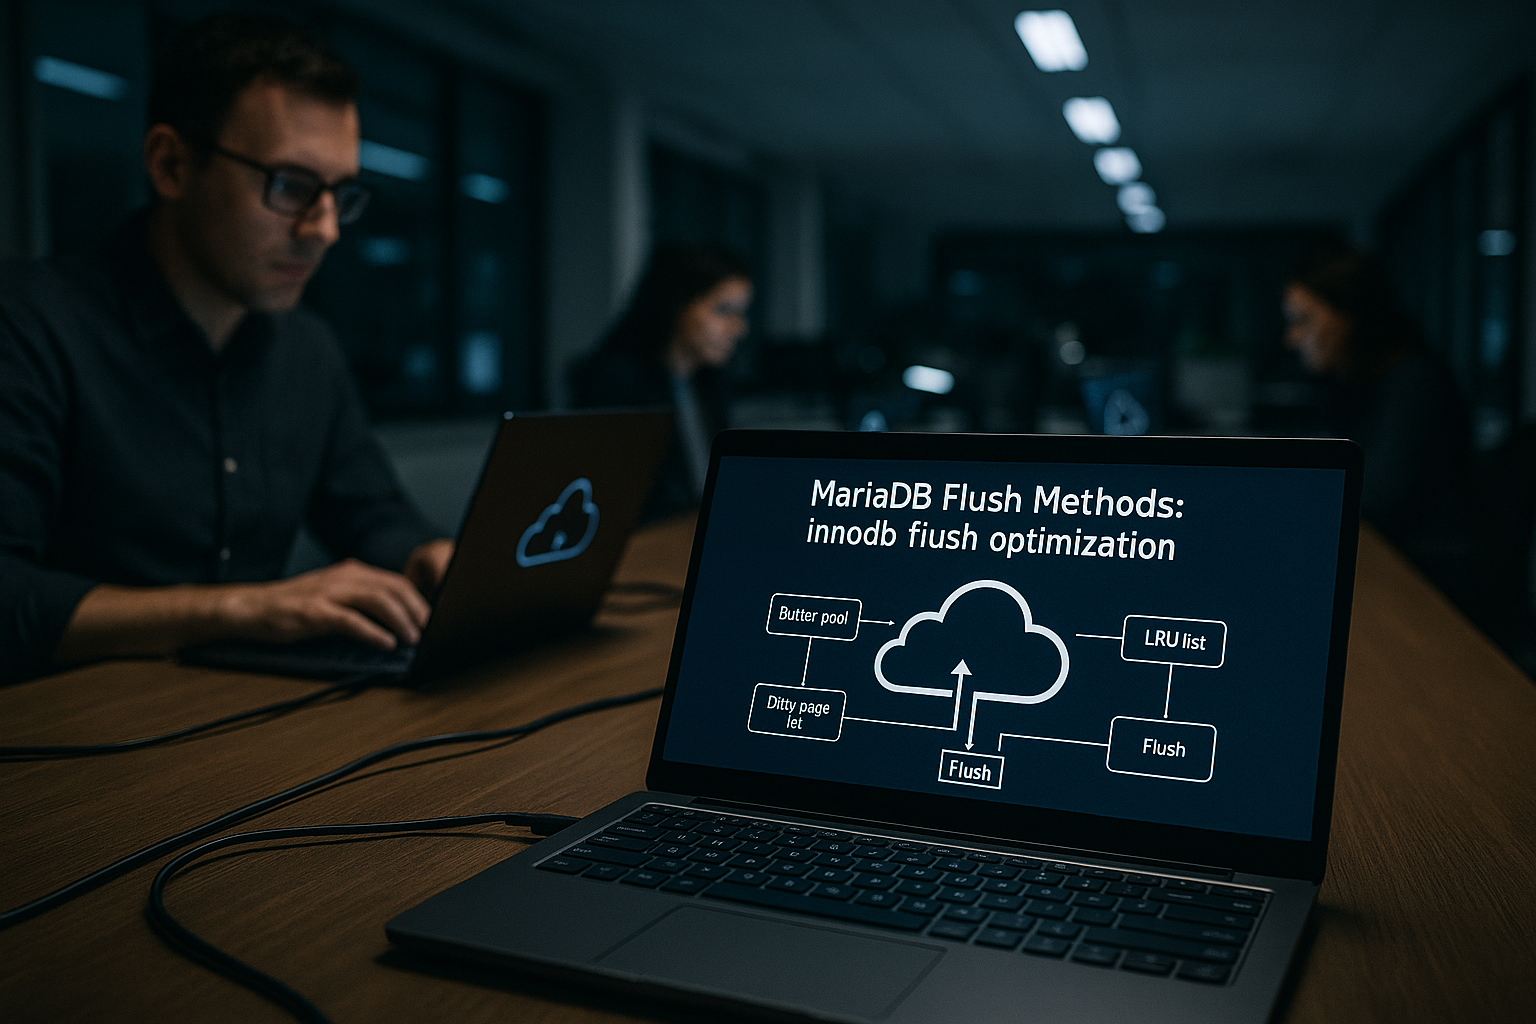
Ich halte den Anteil der Dirty Pages so, dass Schreibraten kontinuierlich bleiben. Dafür setze ich innodb_max_dirty_pages_pct moderat, damit keine plötzlichen Flush-Stürme entstehen. Die Werte innodb_io_capacity und innodb_io_capacity_max richte ich an den realen IOPS des Speichers aus: niedrig für HDD, höher für SSD/NVMe. Ein gut konfigurierter Page-Cleaner-Thread schreibt aus LRU-Sicht rechtzeitig zurück, bevor Seiten verdrängt werden. Mehr zur Thread-Feinabstimmung und zu sinnvollen Metriken beschreibe ich hier: Page-Cleaner-Threads.
Flush-Neighbors: HDD vs. SSD/NVMe
Mit innodb_flush_neighbors nutze ich hdd-freundliche Schreibmuster oder schalte sie ab. Auf HDDs bringt das Mitschreiben benachbarter Seiten Effizienz, weil der Kopf weniger springen muss. Auf SSD/NVMe ist die Lage auf dem Medium kaum relevant, dort erzeugt Mitschreiben unnötige Writes. Für HDD setze ich meist den Wert 1, für SSD/NVMe den Wert 0. So reduziere ich überflüssige Schreibarbeit und schone die Lebensdauer schneller Laufwerke.
fsync-Kosten verstehen und begrenzen
Ich messe die fsync-Latenz, weil jede Millisekunde Commits bremst. Write-heavy-Workloads verbringen sonst einen großen Teil der Zeit im Warten auf die Bestätigung vom Datenträger. Mit innodb_flush_log_at_trx_commit=2 oder 0 senke ich die Anzahl teurer Syncs deutlich. O_DIRECT oder O_DIRECT_NO_FSYNC hilft, Double-Caching zu vermeiden und I/O-Pfade zu vereinfachen. Auf langsamer Hardware gewinne ich oft spürbar, wenn ich Sync-Frequenz, Flush-Methode und Dirty-Page-Quote gemeinsam betrachte.
Empfohlene Startwerte nach Speichermedium
Ich starte mit sinnvollen Baseline-Werten und passe danach anhand von Messwerten an. Die Tabelle gibt Richtungen für typische Setups und Workloads. Entscheidend sind echte IOPS, Latenzen und der Anteil schreibender Transaktionen. Nach dem ersten Lauf kontrolliere ich Dirty-Page-Quote, Commit-Latenz und Anzahl fsync-Aufrufe. Anschließend feine ich schrittweise nach, bis das Profil sauber und konstant bleibt.
| Medium | innodb_flush_method | innodb_flush_log_at_trx_commit | innodb_io_capacity | innodb_flush_neighbors | Hinweise |
|---|---|---|---|---|---|
| HDD | fsync oder O_DIRECT | 1 (kritisch) / 2 (Balance) | 200–400 | 1 | Mehr Latenz pro Commit, kontinuierliches Flushing wichtig |
| SSD | O_DIRECT | 1 (kritisch) / 2 (Balance) | 1000–2000 | 0 | Double-Caching vermeiden, Dirty-Pages moderat halten |
| NVMe | O_DIRECT oder O_DIRECT_NO_FSYNC | 1 (kritisch) / 2 (Balance) / 0 (Spezialfall) | 2000–8000+ | 0 | Sehr niedrige Latenz, Sync-Frequenz sorgfältig wählen |
Ich beachte dazu den InnoDB Doublewrite-Buffer, der Datenkorruption bei Crashs reduziert, aber zusätzliche Writes erzeugt; die Hintergründe und Tuning-Optionen fasse ich hier kompakt: Doublewrite-Buffer. In Write-lastigen Umgebungen messe ich mit und ohne Doublewrite-Effekte, bevor ich Festlegungen treffe. Kritische Systeme priorisieren Integrität vor maximaler Schreibrate. Test- oder Analytics-Setups dürfen aggressiver sein. Entscheidungen sichere ich stets mit wiederholbaren Benchmarks ab.
Cloud- und Container-Umgebungen
Ich vermeide doppelten Page-Cache, weil RAM dort knapp ist; O_DIRECT passt deshalb oft gut. Die innodb_io_capacity richte ich an die IOPS-Limits des Volumes aus, damit ich keine Drossel auslöse. Der Buffer-Pool muss zum Cgroup-Limit passen, sonst drohen OOM-Kills. Persistente Volumes sind Pflicht, da ephemeral Storage keine Haltbarkeit bietet. In sehr elastischen Setups bremse ich zu viele gleichzeitige Verbindungen und setze den Thread-Pool überlegt ein.
Backup und Flush-Einstellungen
Ich prüfe, ob Backup-Werkzeuge eigene Flush-Einstellungen nutzen. mariadb-backup kann innodb_flush_method abweichend setzen, um konsistente Sicht zu erhalten. Stimmen Backup- und Server-Parameter nicht, entstehen unnötige I/O-Spitzen. Während geplanter Sicherungen reguliere ich I/O-Kapazität behutsam, damit Lese-/Schreibpfade sauber bleiben. Nach dem Lauf kontrolliere ich Latenzen und Dirty-Page-Anteile, um Seiteneffekte auszuschließen.
Schritt-für-Schritt-Tuning in der Praxis
Ich starte mit einer Bestandsaufnahme: Speichertyp, echte IOPS, Latenzen und Durchsatz. Danach lege ich die Buffer-Pool-Größe fest, passend zum vorhandenen RAM oder Cgroup-Limit. Anschließend wähle ich die Flush-Methode (HDD: fsync/O_DIRECT; SSD/NVMe: O_DIRECT oder O_DIRECT_NO_FSYNC). Für die Haltbarkeit setze ich innodb_flush_log_at_trx_commit auf 1 für kritische Daten oder 2, wenn eine Sekunde Verlust akzeptabel ist. Zum Schluss stelle ich innodb_io_capacity und innodb_max_dirty_pages_pct so ein, dass Flushing ruhig und stetig läuft, und kontrolliere die Metriken regelmäßig.
Redo-Log-Größe und Checkpoints richtig dimensionieren
Ich verhindere Flush-Spitzen, indem ich die Redo-Logs passend dimensioniere. Zu kleine Logs zwingen InnoDB zu häufigen Checkpoints; die Folge sind Backpressure und unruhige Latenzen. Mit größeren Logdateien glätte ich den Checkpoint-Verlauf, weil mehr Änderungsdaten gepuffert werden können, bevor sie gezwungen werden, auf die Datenfiles zu wandern. Dabei beachte ich zwei Grenzen: erstens die verfügbare I/O-Kapazität (ein großer Puffer schützt nicht vor zu langsamen Disks), zweitens den Crash-Recovery-Zeitraum, der mit sehr großen Redo-Logs ansteigt. In Write-intensiven Workloads setze ich die Loggröße so, dass typische Lastspitzen innerhalb des Logbudgets absorbiert werden, ohne dass die Recovery-Zeit unvernünftig wächst.
Ich beobachte zur Feinabstimmung die Metriken zum „checkpoint age“ und die Relation zwischen Log-Write-Rate und Flush-Rate der Datenpages. Wenn die Checkpoints wiederholt an die Obergrenze stoßen, skaliere ich entweder die Loggröße oder erhöhe vorsichtig die I/O-Kapazität für den Page-Cleaner. Ziel ist ein sanfter, kontinuierlicher Checkpoint-Fortschritt ohne Zwangsaktionen.
Adaptive Flushing und Schwellenwerte
Adaptive-Mechanismen von InnoDB helfen, Flushing dem aktuellen Write-Tempo anzupassen. Ich achte darauf, dass die LWM-Schwelle (Low Watermark) für Dirty Pages nicht zu niedrig liegt, damit der Page-Cleaner nicht ständig „auf Kante“ fährt. Gleichzeitig vermeide ich Maximalwerte, die zu aggressiven Bulk-Flushes führen. In der Praxis prüfe ich, ob das Verhältnis aus „neuen Dirty Pages pro Sekunde“ zu „Flush-IOPS“ langfristig stabil bleibt. Wenn der Pufferpool konstant über dem Ziel verschmutzt, erhöhe ich innodb_io_capacity schrittweise oder reduziere die Dirty-Page-Ziele.
Auf NVMe-Setups kann ich dem Page-Cleaner mehr Spielraum geben, weil die Geräte kurze Latenzen auch unter Last halten. Auf HDDs arbeite ich mit konservativeren Schwellen und limitiere starke Ausschläge, um Seek-bedingte Latenzspitzen zu vermeiden. Das Zusammenspiel mit innodb_flush_neighbors nutze ich gezielt: HDD profitiert von räumlicher Lokalität, Flash nicht.
Binlog und Group-Commit im Zusammenspiel
Wer Replikation einsetzt, berücksichtigt das Commit-Protokoll über Redo-Log und Binary Log. Ich richte die Flush-Frequenzen so ein, dass Group-Commit greift: Viele kleine Transaktionen sollen gemeinsam geflusht werden, statt jeden Commit einzeln zu synchronisieren. Dazu passt innodb_flush_log_at_trx_commit=1 für maximale Haltbarkeit oder 2 für niedrigere Latenz. Parallel stelle ich den Binlog-Sync-Mechanismus so ein, dass er zum Zielsystem passt. Eine niedrige Sync-Frequenz reduziert Kosten pro Commit, kann aber bei Crashs mehr Binlog-Verlust bedeuten. In Umgebungen mit hoher Schreibrate und tolerierbarer Verzögerung zwischen Master und Replica akzeptiere ich eine moderate Entkopplung der Binlog-Syncs, um Latenzen zu senken. Die übergeordnete Logik und Trade-offs führe ich im Beitrag zu Binary Logs aus und passe sie dann an das konkrete Flush-Profil an.
Dateisystem, Write-Cache und Stromausfallschutz
Ich bewerte die Speicher- und Controller-Eigenschaften vor dem Tuning. Geräte mit Power-Loss-Protection (PLP) können Write-Caches sicher nutzen; ohne PLP besteht das Risiko, dass als bestätigt gemeldete Writes bei Stromausfall verloren gehen. In solchen Fällen bleibe ich konservativer: fsync-Pfade bleiben Pflicht, O_DIRECT_NO_FSYNC nutze ich nur auf Hardware mit verlässlicher Absicherung. Auf Linux-Dateisystemen wie ext4 oder XFS gelten die Barrieren standardmäßig als aktiv; ich deaktiviere sie nicht leichtfertig, sondern richte Tuning rund um die existierenden Garantien aus. Auf ZFS betrachte ich zusätzlich dessen eigenes Intent Log und Caching-Strategien; je nach Setup lohnt sich eine separat abgestimmte Strategie, die Double-Caching ebenfalls minimiert.
Für konsistente Performance prüfe ich außerdem Alignments (z. B. 4K-Seiten bei SSD) und Aushandlung der Queue-Tiefe. Kurze, deterministische Latenzen sind für Commit-Pfade oft wichtiger als maximale IOPS in synthetischen Benchmarks. Daher teste ich mit realistischen Blöcken und Concurrency-Graden statt nur mit Peak-Workloads.
Messmethodik: Metriken, Status und Diagnose
Ich steuere das Tuning über harte Messwerte statt Gefühl. Zu meinen Standardindikatoren gehören:
- Commit-Latenz (p50/p95/p99) während Lastspitzen
- fsync-Latenz und -Rate für Log und Datenfiles
- Dirty-Page-Anteil im Zeitverlauf und dessen Varianz
- Checkpoint-Fortschritt und Verhältnis von Log-Write-Rate zu Flush-Rate
- Page-Cleaner-Backlog (liegen ausstehende Flushes konstant an?)
Ich ziehe dazu die Status-Ausgaben von InnoDB heran und korreliere sie mit OS-Metriken (iostat, vmstat). Speziell beobachte ich die Disk-Latenz in Millisekunden und die Verteilung auf Reads/Writes sowie den Anteil synchroner Operationen. Für reproduzierbare Tests variiere ich gezielt nur einen Parameter pro Schritt und protokolliere das Ergebnis über längere Intervalle, damit Ausreißer nicht dominieren.
Häufige Anti-Pattern und Gegenmaßnahmen
- Zu kleine Redo-Logs: führt zu häufigen Checkpoints. Gegenmaßnahme: Loggröße erhöhen und I/O-Kapazität fürs Flushing anpassen.
- Dirty-Pages dauerhaft zu hoch: Page-Cleaner überfordert, Flush-Stürme drohen. Gegenmaßnahme: innodb_max_dirty_pages_pct senken und io_capacity erhöhen.
- O_DIRECT ohne Monitoring: vermeidet zwar Double-Caching, kann aber bei falscher I/O-Kapazität zu Bursts führen. Gegenmaßnahme: enges Monitoring und Kapazitätswerte an reale IOPS koppeln.
- Unpassende Flush-Neighbors auf SSD/NVMe: erzeugt Mehrarbeit ohne Nutzen. Gegenmaßnahme: innodb_flush_neighbors=0 setzen.
- Commit-Syncs auf langsamen Medien: jede Transaktion zahlt den fsync-Preis. Gegenmaßnahme: Group-Commit fördern, ggf. innodb_flush_log_at_trx_commit=2 (mit Risikoabwägung).
- Container ohne RAM-Puffer: Buffer-Pool zu groß, OOM droht. Gegenmaßnahme: Buffer-Pool strikt an Cgroup-Limits ausrichten und Pressure beobachten.
Shutdown- und Recovery-Pfade mitdenken
Ich plane, wie sich Einstellungen auf Shutdown und Crash-Recovery auswirken. Ein zügiger, sauberer Shutdown reduziert Recovery-Zeiten, weil weniger Redo angewendet werden muss. Sehr große Redo-Logs begünstigen ruhige Checkpoints, verlängern aber im Fehlerfall das Nachholen. Für produktive Systeme wähle ich die Balance so, dass ich einerseits keine Flush-Stürme im Tagesgeschäft erzeuge, andererseits im Worst Case keine überlange Recovery in Kauf nehmen muss. Wartungsfenster und Backups berücksichtige ich dabei von Beginn an.
Praxisrezepte für typische Workloads
- OLTP mit vielen kleinen Commits auf SSD/NVMe: O_DIRECT, innodb_flush_log_at_trx_commit=1 oder 2 je nach Durability, innodb_io_capacity eher hoch, Dirty-Pages moderat, Flush-Neighbors=0. Binlog-Group-Commit aktiv nutzen.
- Schreiblastiger Batch-Import: temporär Dirty-Page-Ziel etwas erhöhen, I/O-Kapazität anheben, nach Abschluss wieder zurückdrehen. Bei akzeptabler Haltbarkeit vorübergehend innodb_flush_log_at_trx_commit=2 setzen.
- HDD-basierte Legacy-Systeme: konservative I/O-Kapazität, Flush-Neighbors=1, innodb_flush_method=fsync oder O_DIRECT je nach RAM-Druck. Besonderes Augenmerk auf kontinuierliches Flushing, um Seek-Stürme zu vermeiden.
- Cloud-Volumes mit IOPS-Budget: innodb_io_capacity streng an das garantierte Limit koppeln, Bursts vermeiden, O_DIRECT zum Einsparen von RAM. Bei Creditsystemen (Burst-I/O) arbeite ich mit Pacing, damit das Budget nicht schlagartig verbraucht wird.
Troubleshooting-Checkliste
- Lange p95-Commit-Latenzen? fsync-Dauer prüfen, Group-Commit aktivieren, ggf. Flush-Frequenz reduzieren (mit Risikoabwägung).
- Hohe Varianz im Dirty-Page-Anteil? io_capacity/io_capacity_max feinjustieren, adaptive Flushing-Schwellen prüfen.
- Plötzliche Latenzspitzen bei Backups? Backup-Tool-Parameter und Serverwerte synchronisieren, I/O-Drossel temporär anpassen.
- Replica hängt hinterher? Binlog-Flush-Strategie, Sync-Frequenzen und Netzwerk-Latenz gemeinsam bewerten; zu aggressive Syncs bremsen den Master.
- RAM-Druck nach O_DIRECT-Umstieg? Buffer-Pool- und OS-Cache-Balance neu einmessen; O_DIRECT reduziert OS-Cache, kann aber App-Pagecache betreffen.
Kurze Zusammenfassung
Ich ordne die Flush-Strategie immer der Hardware und den Haltbarkeitszielen unter. O_DIRECT verhindert Double-Caching und liefert auf SSD/NVMe meist die besten Ergebnisse. Der Regler innodb_flush_log_at_trx_commit entscheidet über das Tempo pro Commit und das Risiko bei Stromausfall. Sauber gewählte Werte für Dirty Pages, I/O-Kapazität und Flush-Neighbors halten Schreibraten gleichmäßig. Wer zusätzlich fsync-Kosten misst und Cloud-Limits einhält, bringt MariaDB zuverlässig auf Tempo, ohne Sicherheit zu opfern.


