
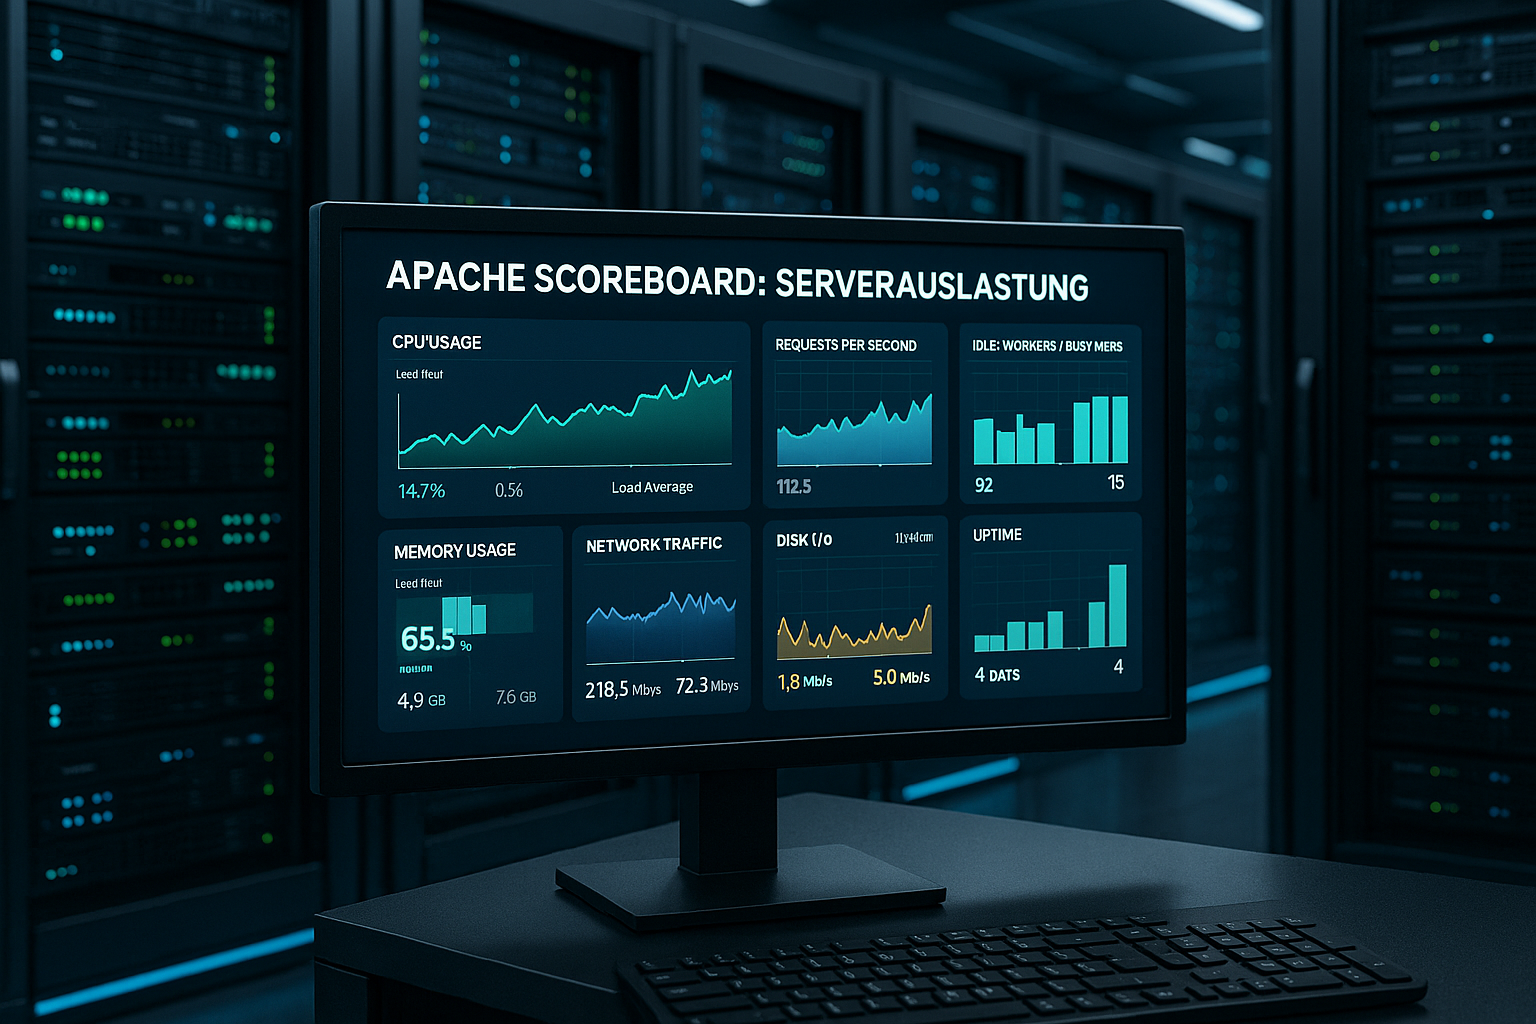
Das Apache Scoreboard zeigt mir in Echtzeit, wie viele Worker gerade Anfragen lesen, Antworten senden oder im Leerlauf warten, und ich bewerte damit die Serverauslastung ohne Rätselraten. Über mod_status greife ich strukturiert auf die Statusdaten zu, interpretiere Symbole, messe Durchsatz und leite daraus konkrete Tuning‑Schritte ab.
Zentrale Punkte
- Echtzeit‑Status aller Worker verstehen und Engpässe schnell erkennen.
- mod_status sicher bereitstellen und ExtendedStatus sinnvoll nutzen.
- Kennzahlen wie Req/s, Busy/Idle und CPU systematisch auswerten.
- Symbole des Scoreboards deuten und gezielt handeln.
- Monitoring automatisieren und Alarme datenbasiert setzen.
Was ist das Apache Scoreboard?
Im Scoreboard speichert Apache pro Worker einen aktuellen Status wie Lesen, Senden oder Idle, und ich sehe dadurch die Arbeitsverteilung der Prozesse. Die Daten liegen intern vor und gelangen über mod_status an die Oberfläche, wahlweise als HTML oder im maschinenlesbaren Modus. Ich prüfe dort Busy Workers, Idle Workers, CPU‑Last, Uptime sowie Zugriffe und Bytes. Besonders hilfreich finde ich die feingranulare Sicht auf einzelne Worker, weil ich Bearbeitungsdauer und aktiven Host erkenne. So entscheide ich fundiert, ob Kapazität fehlt, Anfragen zu lange dauern oder Keep‑Alive Slots blockiert; diese Transparenz spart Zeit bei der Ursachenanalyse.
So greife ich per mod_status zu
Über /server-status öffne ich eine übersichtliche HTML‑Seite; über /server-status?auto erhalte ich eine kompakte Textausgabe für Monitoring und Skripte. In produktiven Setups aktiviere ich ExtendedStatus On, weil mir zusätzliche Metriken pro Worker den nötigen Kontext liefern. Zugriffe beschränke ich strikt auf Admin‑Netze oder einzelne Hosts und lasse die Seite nicht öffentlich. Für eine manuelle Sichtung reicht eine kurze Browser‑Session, bei dauerhafter Erfassung binde ich die Auto‑Ansicht in ein Monitoring‑System ein. So halte ich den Overhead gering und sichere die Statusdaten sinnvoll ab.
Sichere Konfiguration und Overhead einschätzen
Ich schütze /server-status konsequent und entscheide situativ zwischen IP‑Freigaben, Authentifizierung oder einem internen Admin‑VHost. ExtendedStatus verursacht messbaren, aber in der Praxis geringen Overhead; ich aktiviere ihn dauerhaft, wenn ich die Daten auch im Monitoring nutze, oder nur temporär bei Ad‑hoc‑Analysen. Eine saubere Beispielkonfiguration hilft mir, Fehler zu vermeiden:
# Aktivieren
ExtendedStatus On

# Status nur intern bereitstellen
<Location "/server-status">
  SetHandler server-status

  # Variante 1: IP-basiert
  Require ip 10.0.0.0/8 192.168.0.0/16 ::1

  # Variante 2: Basic-Auth (z. B. zusätzlich zu IP)
  #AuthType Basic
  #AuthName "Server Status"
  #AuthUserFile "/etc/httpd/conf/.htpasswd"
  #Require valid-user
</Location>
Ich halte die Seite auch außerhalb der Produktions-VHosts verfügbar (z. B. über eine interne Adresse), damit keine Rewrite‑Regeln oder Proxy‑Routen dazwischenfunken. Wenn ich Debug‑Phasen beende, überprüfe ich, dass nur notwendige Details veröffentlicht werden.
Scoreboard‑Symbole schnell lesen
Bei Störungen schaue ich zuerst auf die Symbole, weil ein dichtes Muster aus R und W akute Last verrät und viele _ Ruhe signalisieren; diese Kodierung beschleunigt die Diagnose. Auch K zeigt mir offene Keep‑Alive‑Verbindungen, die bei unpassendem Timeout Worker binden. Ein Fokus auf D weist auf DNS‑Lookups hin, die Antworten verzögern. Häufige L‑Einträge deuten auf blockierendes Logging und Speichersubsysteme. Mit ein paar Blicken erkenne ich so den dominanten Bottleneck und starte zielgerichtete Maßnahmen.
| Symbol | Bedeutung | Sofort‑Hinweis |
|---|---|---|
| _ | Idle Worker | Ausreichende Kapazität vorhanden |
| R | Reading Request | Prüfe Netz‑Latenz oder Client |
| W | Sending Reply | Backend‑Zeit und Output‑Größe analysieren |
| K | Keep‑Alive | Timeouts und Slot‑Bindung überprüfen |
| D | DNS Lookup | Reverse DNS abschalten oder cachen |
| L | Logging | Asynchrones Loggen und I/O prüfen |
| C | Closing | Normales Verbindungsende, kurz sichtbar |
| G | Gracefully finishing | Beendete Anfrage, Worker räumt auf |
| I | Idle cleanup | Unkritisch, Worker bereinigt |
| . | Untätig | Ruhige Phase, Ressourcen frei |
Erweiterte Muster und Angriffsprofile erkennen
Ich werte nicht nur Einzelzustände aus, sondern die Dauer und Verteilung der Symbole. Viele lang andauernde R‑Zustände bei gleichzeitig niedriger Netzwerkbandbreite deuten auf langsame Clients oder Slowloris‑Muster hin; dann begrenze ich Lese‑Zeiten pro Anfrage (z. B. mit RequestReadTimeout) und setze realistische Min‑Rates. Überwiegen W‑Zustände mit hoher Bytes/Request‑Zahl, ist eher Bandbreite oder Storage limitierend. Häufungen von D und L zur gleichen Zeit lassen mich Namensauflösung und Log‑I/O priorisieren. Entscheidend ist, ob Muster breit (alle Worker) oder lokal (nur ein VHost oder Pfad) auftreten – so finde ich Hotspots in der Anwendung schneller.
Kennzahlen für die Webserver‑Analyse
Requests pro Sekunde zeigen mir den Durchsatz, doch ich bewerte parallel Bytes pro Sekunde und Bytes pro Request für die Nutzlast. Busy‑zu‑Idle‑Verhältnis verrät, ob Slots fehlen oder Settings zu konservativ sind. Ich korreliere CPU‑Auslastung mit Antwortzeiten, um CPU‑bound von I/O‑bound zu trennen. Die Uptime hilft, frische Restarts von echten Trends zu unterscheiden. Aus dieser Kombination leite ich konkrete Tuning‑Hebel für Worker, Keep‑Alive und Timeouts ab.
Grenzwerte und Alarmierung in der Praxis
Ich setze Alarme nicht auf Momentwerte, sondern auf gleitende Mittel und Dauern. Bewährt haben sich z. B. folgende Heuristiken: Idle < 10 % für länger als 5 Minuten signalisiert Kapazitätsmangel. Busy/Idle > 4:1 über denselben Zeitraum deutet auf Sättigung. Req/s fällt bei konstantem Traffic, während Busy konstant bleibt – dann steckt oft ein Backend dahinter. K‑Anteil > 50 % zur Primetime spricht für zu großzügiges Keep‑Alive. Ich ergänze Schwellen um Trend‑Alarme (steigende Antwortzeiten bei gleicher Last) und Saisonalität (Tages‑ und Wochenmuster), damit ich echte Veränderungen von normalem Verhalten unterscheiden kann.
ScoreboardFile richtig einordnen
Auf einigen Plattformen schreibt Apache Statusdaten in eine Scoreboard‑Datei, und ich lege sie in ein schnelles, abgesichertes Verzeichnis wie /var/run/httpd; das erhöht die Zuverlässigkeit. Ich verhindere, dass mehrere Instanzen dieselbe Datei nutzen, sonst drohen verfälschte Werte. Manche Tools lesen direkt aus der Datei, was den HTTP‑Endpunkt überflüssig macht. Für Härtung und Performance ist das attraktiv, sofern Berechtigungen stimmen. Ich dokumentiere Pfad und Zugriff, damit Wartung und Monitoring konsistent bleiben.
Betriebssystem‑ und Container‑Besonderheiten
Ich stelle sicher, dass Dateideskriptor‑Limits, Backlogs und temporäre Pfade zum Workload passen. Unter systemd prüfe ich, ob PrivateTmp oder ReadOnlyPaths den Scoreboard‑Pfad beeinflussen. In Containern plane ich den Speicherbedarf pro Prozess/Thread konservativ und lege den Scoreboard‑Pfad in ein beschreibbares Runtime‑Verzeichnis. Für Spitzenlast passe ich Kernel‑Parameter an:
# Beispielhafte Sysctl-Werte (systemweit testen und dokumentieren)
net.core.somaxconn = 4096
net.ipv4.tcp_max_syn_backlog = 4096
fs.file-max = 1048576
Außerdem kalibriere ich das ulimit -n für den Apache‑Dienst so, dass es zur maximalen Gleichzeitigkeit passt (Daumenregel: offene FDs ≈ 2–3 × MaxRequestWorkers bei proxylastigen Setups). Nach Änderungen beobachte ich das Scoreboard erneut, um Effekte zu bestätigen.
Typische Anwendungsfälle: Überlastete Worker erkennen
Sind fast alle Slots mit R oder W belegt und erscheinen kaum _‑Einträge, läuft der Server an seinem Limit. Dann prüfe ich MaxRequestWorkers, Response‑Zeiten und blockierende Backends. Helfen zusätzliche Worker nicht, liegt das Nadelöhr oft in Applikation, Datenbank oder Storage. Über /server-status?auto verfolge ich die Entwicklung in Intervallen, statt nur Momentaufnahmen zu betrachten. So entscheide ich, ob ich Settings anpasse, Caching stärke oder Skalierung plane.
Ressourcenmodell und Kapazitätsformeln
Ich rechne Kapazitäten vorab durch, damit ich keine Speicherengpässe erzeuge. Für Prefork gilt: Memory ≈ Anzahl Prozesse × RSS pro Prozess. Für Worker/Event: Memory ≈ Anzahl Prozesse × (RSS pro Prozess) + Threads × Thread‑Overhead. Ich messe den realen RSS mit Werkzeugen des Systems und halte Sicherheitsmargen. Ein kleines Beispiel: 20 Prozesse × 50 MB + 500 Threads × 1 MB ergeben ≈ 1,5 GB, plus Cache und OS‑Puffer. Daraus leite ich MaxRequestWorkers, ServerLimit und ThreadsPerChild ab. Ich beachte außerdem, dass Module wie SSL, PHP oder Reverse‑Proxying den Speicher je Thread erhöhen können; daher teste ich unter realer Nutzlast, nicht nur im Leerlauf.
Warteschlangen und Latenz deuten
Bleiben Anfragen lange im Accept‑ oder Schreib‑Zustand, steigt die gefühlte Latenz, und ich befasse mich mit Queue‑Längen sowie Accept‑Backlog; das Scoreboard liefert dafür wertvolle Indikatoren. Eine tiefergehende Erklärung zu Warteschlangen, Latenzen und Request‑Handling liefert mir dieser Beitrag: Warteschlangen und Latenz. Mit diesen Grundlagen messe ich, ob die Engpässe vor dem Apache, im Apache oder dahinter entstehen. Kurze Peaks toleriere ich, doch Dauerstaus behebe ich über Kapazität oder Architektur. So verhindere ich, dass Timeouts eskalieren und Clients abbrechen.
Backend‑ und Proxy‑Bezug herstellen
In proxylastigen Umgebungen lese ich aus W‑Phasen heraus, ob Worker auf Upstreams warten. ExtendedStatus zeigt mir den VHost und die angefragte Ressource; damit korreliere ich Pfade mit langsamen Backends. Ich setze realistische Timeouts (TimeOut, ProxyTimeout) und prüfe Connection‑Pooling, damit Threads nicht unnötig blockieren. Staut sich die Pipeline bei Uploads, reguliere ich Lese‑Raten pro Client und schütze mich gegen langsame Sender. Werden viele große Antworten generiert, ziehe ich Komprimierung, Chunking und Caching in Betracht, um W‑Zeiten zu verkürzen.
Keep‑Alive gezielt einstellen
Viele K‑Einträge deuten auf Clients hin, die Verbindungen offen lassen; das beschleunigt Folgerequests, kann aber Slots binden. Ich setze Timeouts so, dass echte Wiederholungen profitieren, während Leerlauf nicht zu lange blockiert. Auf stark frequentierten Sites hilft mir ein vorgeschalteter Proxy, der Keep‑Alive effizient bündelt. Für Details zur Feinabstimmung nutze ich diesen Leitfaden: Keep-Alive-Timeout einstellen. Mit einem sinnvollen Timeout sinkt die Slot‑Bindung, und der Server bleibt unter Last reaktionsfähig.
HTTP/2, TLS und MPM im Zusammenspiel
Mit HTTP/2 sehe ich in der Regel weniger K‑Bindung pro Client, weil mehrere Streams eine Verbindung teilen. Event‑MPM spielt hier seine Stärken aus: Keep‑Alive wird effizienter behandelt, aktive Arbeit bleibt Threads vorbehalten. TLS erhöht CPU‑Bedarf pro Verbindung; ich beobachte, ob hohe W‑Anteile mit hoher CPU korrelieren, und optimiere Cipher‑Suites sowie Session‑Resumption. In Status‑Ansichten erkenne ich pro VHost, ob HTTP/2 oder TLS‑Terminationspfade dominieren und richte Kapazitäten entsprechend aus (z. B. mehr Threads statt mehr Prozesse, wenn Kontextwechsel teuer sind).
DNS‑Lookups und Logging im Griff
Häuft sich D im Scoreboard, prüfe ich Reverse‑DNS und aktiviere einen lokalen Cache oder schalte Lookups ab; das senkt die Latenz. Sehe ich viele L‑Einträge, bremst Logging die Verarbeitung, also verteile ich Logfiles, nutze schnelleren Storage oder asynchrone Pipelines. Rotierende Logs konfiguriere ich so, dass Flush‑Spitzen ausbleiben. Parallel messe ich Schreib‑I/O und Dateisperren, um blockierende Muster aufzubrechen. So gewinne ich Bearbeitungszeit zurück und entlaste die Worker.
Integration in Monitoring‑Systeme
Ich sammle /server-status?auto periodisch, speichere die Werte als Zeitreihe und visualisiere Busy‑vs‑Idle, Req/s, Bytes/s und CPU‑Last auf Dashboards. Alarme definieren Schwellwerte für dauerhaft volle Slots, ansteigende Antwortzeiten oder ungewöhnliche Traffic‑Muster. Mit Annotations markiere ich Deployments, damit ich Effekte sofort sehe. Diese Historie unterscheidet einmalige Peaks von echten Trends. So steuere ich Kapazität planvoll und verhindere Überraschungen.
Automatisierte Erfassung mit Skripten
Für schnelle Checks genügt mir ein leichtgewichtiges Skript, das die Auto‑Ansicht parst und nur die Kernzahlen ausgibt. Ich halte die Abfrageintervalle moderat (z. B. 10–30 Sekunden), um den Overhead niedrig zu halten, und tagge jede Probe mit Host, VHost und Environment.
#!/bin/sh
URL="http://127.0.0.1/server-status?auto"
curl -s "$URL" | awk -F': ' '
  /BusyWorkers/ {busy=$2}
  /IdleWorkers/ {idle=$2}
  /ReqPerSec/   {rps=$2}
  /BytesPerSec/ {bps=$2}
  END { printf("busy=%s idle=%s rps=%.2f bps=%.0f\n", busy, idle, rps, bps) }
'
In größeren Umgebungen aggregiere ich zusätzlich per‑Worker‑Zeiten, ordne sie VHosts zu und berechne Quantile für Antwortzeiten. So erkenne ich, ob nur ein Teil der Nutzer Probleme sieht oder die Mehrheit betroffen ist.
MPM und Kapazitätsplanung
Das MPM legt fest, wie Apache Verbindungen verarbeitet; Scoreboard‑Daten zeigen mir, ob Prozesse oder Threads der limitierende Faktor sind. Für die Auswahl und Tuning vergleiche ich Event und Worker, messe Idle‑Zeiten, Keep‑Alive‑Bindung und Kontextwechsel. Einen kompakten Vergleich liefert dieser Beitrag: Event vs. Worker MPM. Nach Änderungen prüfe ich erneut Busy/Idle und Req/s, um Effekte zu belegen. So treffe ich Entscheidungen datenbasiert und erhöhe die Effizienz.
Graceful Restart, Rolling Deployments und Wartung
Bei Deployments oder Konfigurationswechseln löse ich bevorzugt einen graceful Restart aus. Im Scoreboard erkenne ich daran viele G‑Zustände, während neue Prozesse starten und alte sauber auslaufen. Ich plane Rolling‑Änderungen so, dass genug Idle‑Kapazität verbleibt: erst Last reduzieren, dann graceful neu laden, anschließend die restlichen Knoten. Langanhaltende G‑Phasen sind ein Indiz, dass alte Prozesse auf langsame Requests warten – dann überprüfe ich Timeouts und Keep‑Alive, um die Umschaltzeit zu verkürzen.
Schritt für Schritt zur fundierten Analyse
Ich aktiviere mod_status, sichere den Zugriff und schalte ExtendedStatus ein, damit ich alle Details bekomme. Danach prüfe ich die HTML‑Seite im Browser und lerne das Live‑Muster der Symbole. Im nächsten Schritt binde ich /server-status?auto in mein Monitoring ein und validiere die Metriken. Dann optimiere ich nacheinander: Worker‑Anzahl, Keep‑Alive, Timeouts, Caching und Applikationspfade. Jede Änderung messe ich erneut, bis Req/s, Antwortzeit und Busy/Idle wieder im Grünbereich liegen.
Zusammenfassung: Apache Scoreboard als Kompass
Das Apache Scoreboard liefert mir eine klare, sofort nutzbare Sicht auf Auslastung, Engpässe und Verhalten der Worker. Mit mod_status, ExtendedStatus und sauberem Monitoring verwandle ich Rohdaten in belastbare Entscheidungen. Symbole und Metriken zeigen, ob ich Kapazität erweitere, Timeouts trimme oder die Anwendung anpacke. Eine kleine Änderung am Keep‑Alive oder am MPM kann große Wirkung haben, wenn die Datenlage stimmt. Wer die Zeichen richtig liest, hält den Apache unter Last reaktionsschnell und planbar.


