 Videre til indhold

Jeg viser dig, hvordan du læser vmstat i Linux målrettet: Du kan på få sekunder identificere CPU-flaskehalse, belastning på hukommelsen, swap og I/O-ventetider. Sådan fortolker du kolonnerne r, b, free, si/so, bi/bo og us/sy/id/wa/st på en sikker måde og udleder konkrete tiltag ud fra mønstrene – uden at gætte, med klar Regler.
Centrale punkter
- Kø vs. blokeringer: r viser CPU-belastning, b advarer om I/O-ventetider.
- Hukommelse Vurder det realistisk: »gratis« i sig selv tæller ikke; det afgørende er, om det er sådan eller ej.
- I/O I fokus: bi/bo er ukritiske, så længe wa forbliver lav.
- CPU-andele Læs: us+sy højt, id lavt → høj udnyttelsesgrad.
- Basislinjer Udarbejde: Sammenligne værdier i hverdagen med problemfaser.
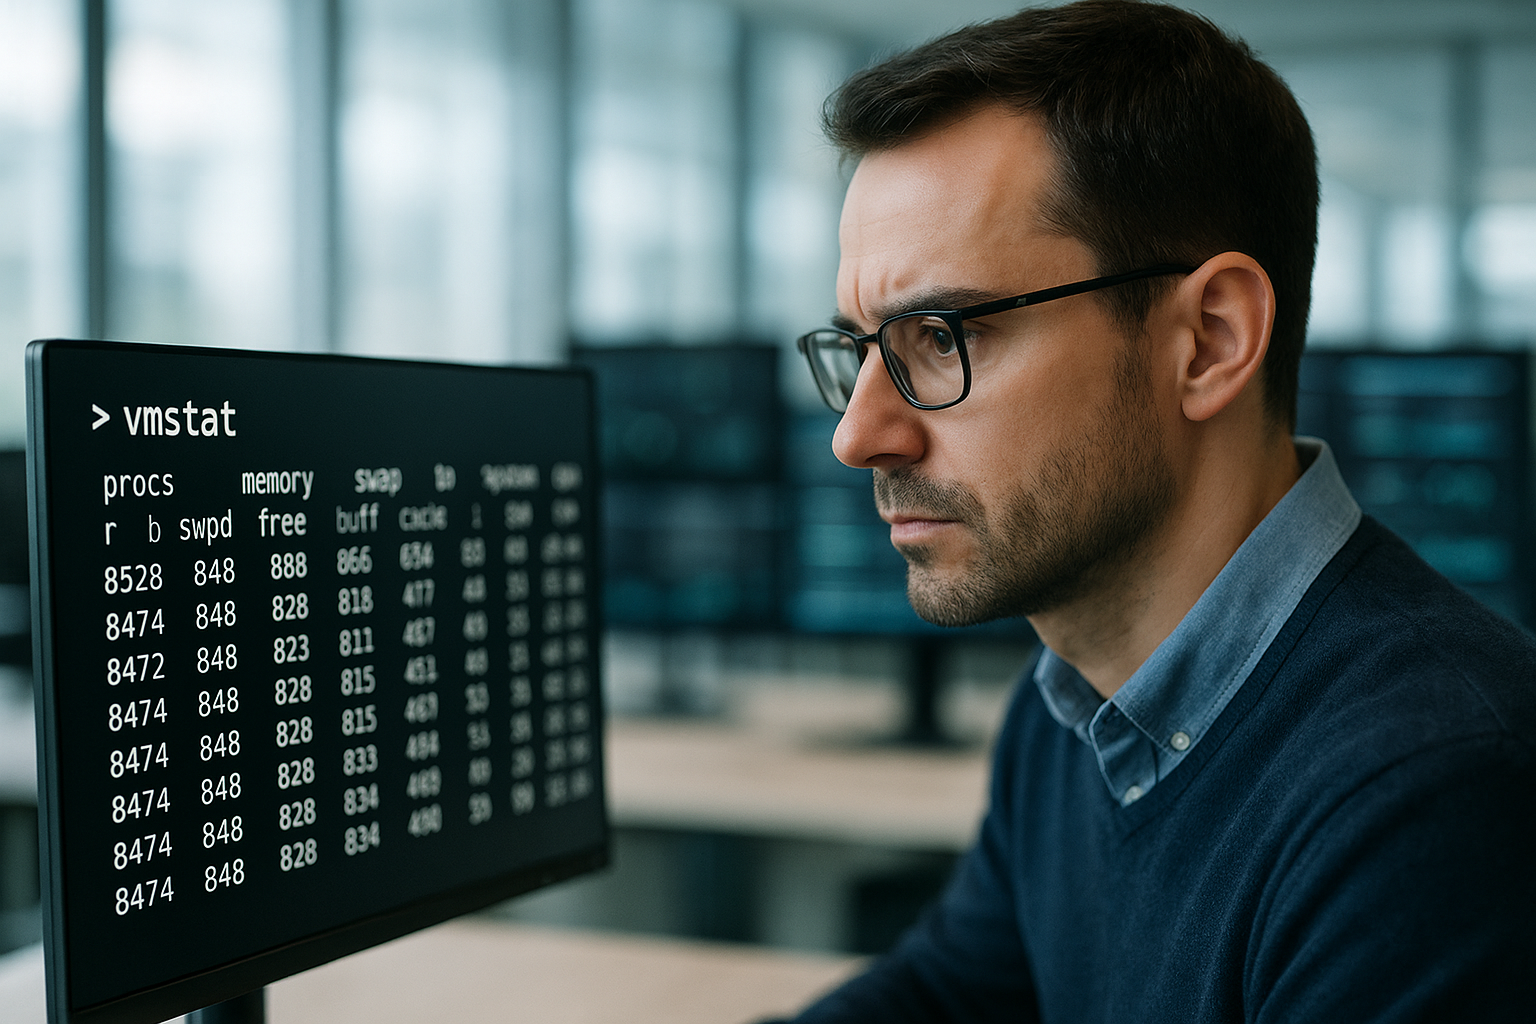
Hvad viser vmstat egentlig?
Vmstat samler processtatus, hukommelse, swap, blok-I/O og CPU-andel i en kompakt udskrift, der på få sekunder giver et systemomfattende Giver et godt indtryk. Først læser jeg „procs“ for r/b, derefter „memory/swap“ for free, buff, cache samt si/so. Så tjekker jeg „io“ med bi/bo og afslutter med „cpu“ for us, sy, id, wa og eventuelt st. Denne rækkefølge hjælper mig med at skelne mellem årsag og virkning: et højt r-tal betyder regnebelastning, et højt b-tal peger på I/O-ventetider, og et højt wa-tal forbinder CPU-inaktivitet med I/O-latens. På den måde kan jeg se, om det er regnearbejdet, hukommelsesmangel eller datamediet, der bremser systemet – og jeg sparer mig selv for Omveje.
Start om 60 sekunder: Opkald og intervaller
For at få et øjebliksbillede lige fra opstarten kører jeg „vmstat“ uden parametre; til løbende analyser bruger jeg „vmstat 1“ eller „vmstat 5 12“ for tolv målepunkter hvert femte sekund og får en tidsmæssig Række. Vigtigt: Den første linje viser gennemsnitsværdier siden systemstart, så jeg lægger især vægt på de følgende linjer. Med Delay/Count styrer jeg samplingsfrekvensen og varigheden, f.eks. „vmstat 1 30“ ved korte spidsbelastninger. Ved ustabile arbejdsbelastninger indstiller jeg 1–2 sekunder, ved rolige scenarier snarere 5 sekunder. Jeg observerer tendenser, ikke enkeltbilleder, fordi mønstre afslører de reelle Årsager vise.
At forstå processer: r og b i hverdagen
Kolonnen r viser tråde, der er klar til at køre, men venter på CPU-tid, mens b tæller blokerede tråde, ofte i I/O-ventetilstand. Hvis r ligger markant over antallet af fysiske kerner, tyder det på, at CPU-flaskehals ; på fire kerner betragtes r=8 over længere tid som et tydeligt signal. En b-værdi større end 0 over længere tid tyder på langsomme datamedier, overbelastede databaser eller langsomme netværks- eller lagringsstier. Jeg korrelerer r med us+sy og id: hvis id er lavt og r højt, kæmper CPU'en; hvis wa er højt og b højt, bremser I/O. Sådan beslutter jeg, om jeg skal skalere regnekraft, optimere forespørgsler eller Opbevaringssystem Tjek.
Fortolkning af hukommelsesvariabler: free, buff, cache, swpd
En lav free-værdi er normalt under Linux, da kernen bruger RAM intensivt som cache, hvilket fremskynder filadgangen og giver reel Gennemstrømning medfører. Derfor lægger jeg mere vægt på swpd og swap-strømmene si/so end på free alene. En høj cache er god, så længe si/so næsten altid forbliver 0; først vedvarende swap-aktivitet indikerer reelt pres. Hvis der desuden opstår latenstid eller endda OOM, griber jeg ind: øger RAM, trimmer processer i tide eller justerer cache- og JVM-størrelser. Konteksten er stadig vigtig: Arbejdsbelastning, hukommelsesstørrelse og NUMA-layout bestemmer, hvad der i dit miljø betragtes som sund gælder.
Swap-aktivitet: klassificering på den ene eller den anden måde
Kolonnerne »si« og »so« måler den konstante datastrøm mellem RAM og swap i KB/s og viser det reelle belastningsniveau på hukommelsen, ikke blot det, man oplever Mangel. Korte spidsbelastninger er normale, f.eks. når sider, der sjældent bruges, flyttes. Det bliver kritisk, hvis de på den ene eller anden måde vedvarende forbliver større end 0; det bremser det hele, da hver eneste udlagring medfører ekstra I/O-omkostninger. Høje so-værdier tyder på aktiv udlagring, og responstiderne stiger markant. På dette tidspunkt stopper jeg årsagerne: reducere hukommelsesforbruget, udvide RAM eller hukommelseskrævende tjenester Melodi.
Forståelse af blok-I/O: bi og bo
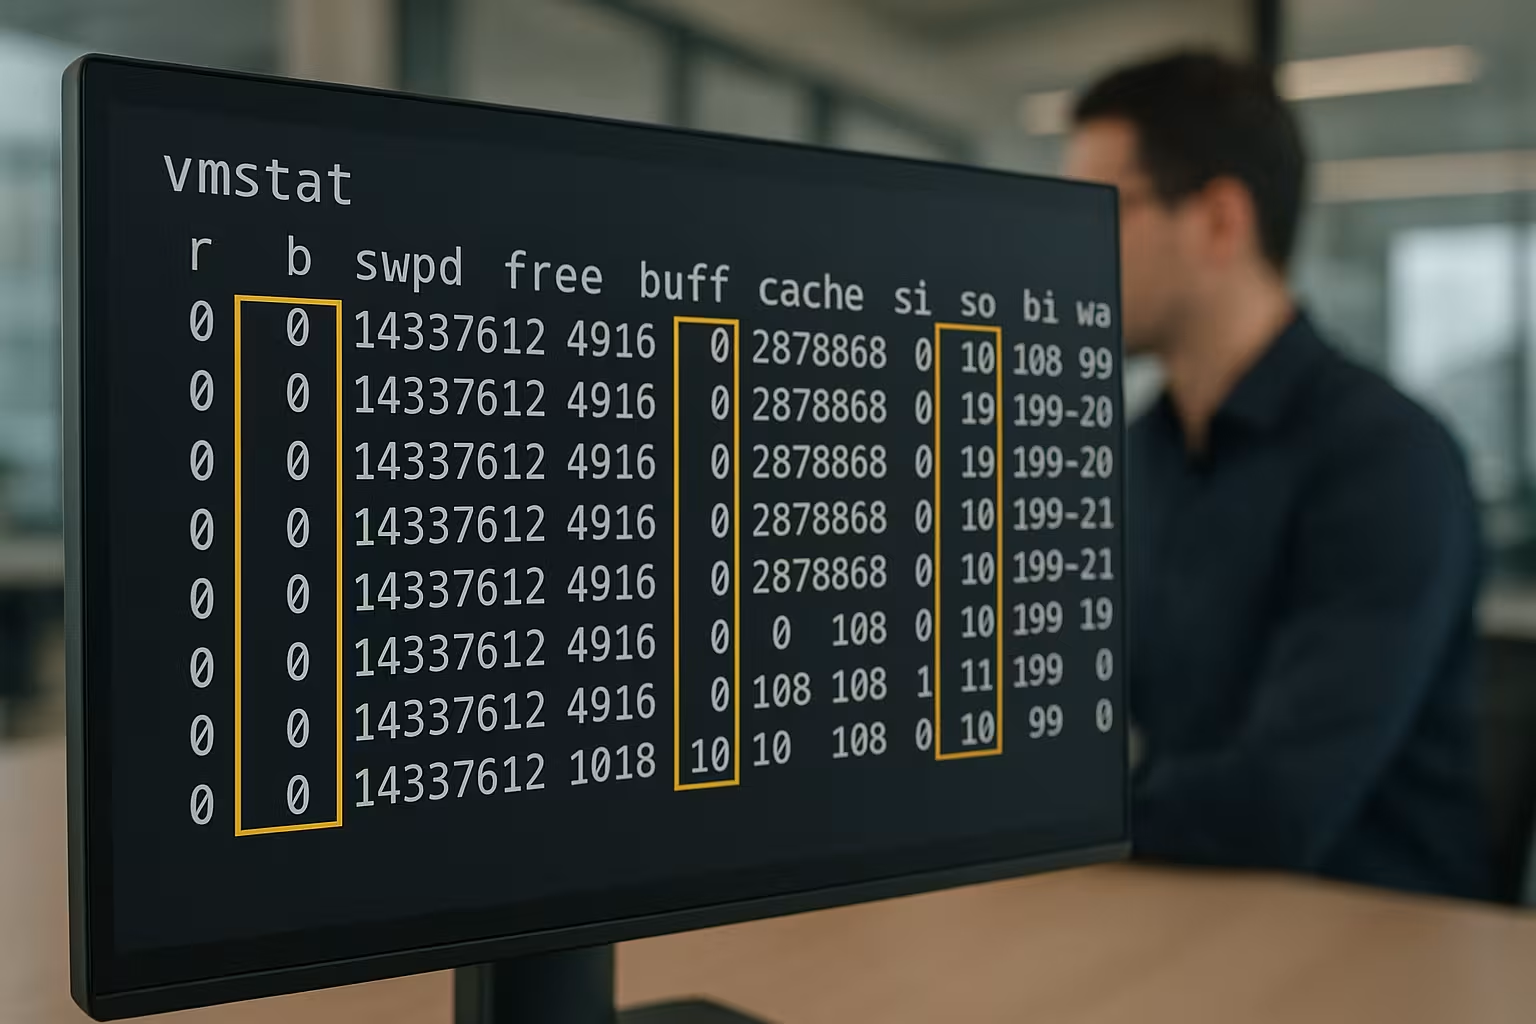
Med bi/bo kan jeg måle læse- og skrivehastigheden i blokke pr. sekund, men uden kontekst vurderer jeg den ikke; det afgørende er samspillet med wa. Høje bi/bo-værdier og samtidig en høj wa-værdi viser, at lagringssystemet ikke kan følge med. Hvis jeg ser høje bi-værdier i forbindelse med en database, tjekker jeg forespørgselsprofiler og cache-hits, før jeg udskifter hardware. For en mere detaljeret timing bruger jeg iostat og analyserer køens længde og latenstider, så jeg Analyse af I/O-ventetid og målrettet kan løse flaskehalse. Først når wa forbliver lavt, men bi/bo eksploderer vedvarende, overvejer jeg at Skalering af lagringssystemet.
CPU-andele: us, sy, id, wa, st
Høje US-værdier ved lav WA indikerer produktivt nyttearbejde, mens høje SY-værdier tyder på en stor mængde kerneoverhead, f.eks. utallige små I/O-operationer eller mange Ændring af konteksten. Hvis id ligger tæt på 0 og forbliver der, kører CPU’en på grænsen; kombineret med et højt r-tal tyder det på en stor regnebelastning. Stiger wa, venter CPU’en på I/O – her giver finjustering af lagringssystemet ofte større gevinst end CPU-opgraderinger. I VM’er holder jeg øje med st (steal): Høje st-værdier afslører, at hypervisoren afleder CPU-tid, så jeg tager en snak med operatøren om værtsudnyttelsen. Jeg vurderer altid us+sy som en sum, da denne viser den aktive Arbejde i systemet.
Hurtigvejledning: Kolonner og vejledende værdier
Jeg bruger nedenstående tabel som en kortfattet huskeliste, når jeg skal gennemgå vmstat-udskrifter for en første Vurdering tværlæsning.
| Kolonne | Betydning | Hvad jeg lægger mærke til |
|---|---|---|
| r | Tråde, der er klar til afspilning | Permanent > Kerner → CPU-belastning |
| b | Blokerede tråde | Konstant > 0 + wa høj → I/O-problem |
| gratis | Gratis RAM | Et lavt tal er i orden, så længe si/so forbliver ≈ 0 |
| buff/cache | FS-buffer/sidebuffer | Meget cache er godt; kan godkendes blive |
| si/so | Swap ind/ud | Konstant > 0 → faktisk lagertryk |
| bi/bo | Blok-I/O | Kun kritisk, hvis wa samtidig er høj |
| us/sy | Bruger/Kerne | us+sy vedvarende > 80% → høj Belastning |
| id | tomgang | Tæt på 0 over tid → CPU overbelastet |
| wa | I/O-ventetid | Højt med b højt → Lagerplads som årsag |
| st | Steal (VM'er) | Høj → Hypervisor tager CPU-tid |
Baselinjer og løbende overvågning
Jeg stoler ikke på enkeltstående øjebliksbilleder, men sammenligner værdierne med referenceværdier fra rolige perioder, så jeg kan fjerne afvigelser på en præcis måde genkende. „vmstat 1 60“ giver mig et belastningsprofil for et minut, som jeg sammenligner med kendte normale faser. For at få et historisk overblik bruger jeg sar/sysstat-overvågning, for at vurdere tendenser over flere dage og skærpe grænseværdierne. Jeg indstiller alarmerne konservativt: r i forhold til kernerne, si/so ulig 0 over flere intervaller, wa mærkbart forhøjet. På den måde reagerer jeg tidligt, inden brugerne rapporterer forsinkelser, og inden Toppen-faser eskalerer.
Vmstat i kombination med andre værktøjer
Jeg starter med vmstat, træffer en beslutning ud fra mønstrene og går derefter målrettet i dybden med iostat, mpstat, pidstat eller applikationsmetrikker, så jeg kan finde årsagerne klar tildele. Mens vmstat viser I/O-ventetider, måler jeg med iostat latenstider og køer for hvert enkelt enhed. Hvis r indikerer en kernebegrænsning, viser mpstat kerneasymmetrier. Ved spidsbelastning i processerne leverer pidstat Procesanalyse de mest heftige tråde om tid. Først sammenhængen med logfiler og applikationstider gør billedet klarere og fører mig til den egentlige Årsag.
Genkende mønstre og handle
Hvis jeg ser, at r er høj, id lav og wa moderat, optimerer applikationen ofte på en måde, der kræver for meget regnekraft, og derfor tjekker jeg koden eller paralleliteten og planlægger CPU-ressourcerne, før jeg Hardware kræver. Hvis b, wa og bi/bo alle er høje, overvejer jeg lagringsoptimering, forespørgselsoptimering og caching. Ved lav free med si/so større end 0 reducerer jeg lagerforbruget, streamer resultaterne eller øger RAM. Hvis us er moderat og sy meget høj, ser jeg på pakkefiltre, filsystemindstillinger eller drivere. Med denne tjekliste kan jeg handle hurtigt og bruge tiden der, hvor den gør mest tæller.
Sådan undgår du målefejl: Prøveudtagning, enheder, første linje
Jeg vælger bevidst ikke at bruge den første linje til at identificere akutte fejl, da den har udført gennemsnitsberegning siden opstart og udjævner spidsbelastninger fuldstændigt. Desuden tilpasser jeg samplingsfrekvensen efter hypotesen om årsagen: CPU-spidsbelastninger registrerer jeg med intervaller på 1 sekund, langsomme hukommelseslækager med intervaller på 5–10 sekunder. Jeg tager højde for enhederne: si/so er KB/s, bi/bo er „blokke/s“ (historisk set 1 KB pr. blok, varierer afhængigt af vmstat-versionen). Jeg kontrollerer, om „vmstat -w“ (bred udskrift) undgår afskæring af kolonner, og om ændringer i clockfrekvensen (P-stater, Turbo) påvirker den kortsigtede opfattelse af belastningen. Jeg synkroniserer målingerne med applikationsspidser i stedet for blindt at se på „hele minutter“.
Afkodning af systemsektionen: in og cs
Ud over procs/memory/swap/io/cpu viser vmstat også „system“: på (afbrydelser/sek.) og cs (Kontekstskift pr. sekund). Disse to værdier fortæller mig meget om kernel-overhead.
- cs er meget højt ved moderat arbejdsbelastning: trådfladder, for små worker-batches eller lock-konflikter. Jeg øger batchstørrelserne, justerer paralleliteten (trådpuljer) og tjekker scheduler-/mutex-hotspots.
- i pludselige stigninger: netværks- eller lagringsinterrupt-storme, NAPI/polling-effekter eller timer-interrupts. Jeg sammenligner med sy-andelen og iostat-resultaterne for at undersøge drivere eller netværksstier.
- cs er proportional med r: Det tyder på et konstant pres for at skifte kontekst på grund af overdreven parallelitet. Jeg begrænser den aktive parallelitet eller binder hot-threads til kerner.
Jeg sammenholder altid in/cs med sy og b/wa: Først når man ser det i sammenhæng, fremkommer et klart billede af, om kernel-arbejdet er meningsfuldt (f.eks. gennemstrømning) eller udgør ren overhead.
Nyttige vmstat-varianter og indstillinger
Jeg bruger vmstat fleksibelt for at få yderligere perspektiver uden at skifte værktøj:
- vmstat -s: Sumtæller (f.eks. processer, der er startet siden opstart, major/minor page faults). Ideel til at sammenligne lækager eller antal tilfælde over bestemte tidsintervaller.
- vmstat -m: Slab-anvendelse – hjælper med at klassificere kernel-cacher (Dentry/Inode, netværk) som RAM-forbrugere.
- vmstat -d: Diskhændelser på samlet niveau. Er ikke en erstatning for iostat, men god til en hurtig realitetstjek.
- vmstat -S M: Skift enheder (M/K) for at gøre tallene lettere at læse.
- vmstat -w: Bredere kolonner forhindrer, at store talrækker bliver afskåret.
Jeg kombinerer disse varianter med korte intervaller, så jeg ikke går glip af begivenheder og alligevel bevarer overblikket.
Containere, VM'er og cgroups: Særlige forhold
I containere fortolker jeg vmstat med forsigtighed: Mange kerneoplysninger gælder for hele værten, mens begrænsningerne stammer fra Cgroups. Høje r-værdier i en container afspejler navnerummets perspektiv, men den reelle CPU-tid kan være begrænset af CPU-kvoter eller CPU-andele. Jeg henviser til st (Steal) i VM’er: En høj st-værdi betyder, at hypervisoren tager tid fra mig – så hjælper selv perfekt app-optimering ikke meget, så længe værten er overbelastet. Ved hukommelsesbegrænsninger i Cgroups kan si/so udblive, selvom containeren „spjætter“ ved grænsen (OOM-kills i stedet for swap). Derfor tjekker jeg desuden OOM-logfiler og Cgroup-statistikker og sammenligner vmstat-billeder med grænserne.
NUMA og affinitet: Når lokalitet er afgørende
På NUMA-værter tjekker jeg r og us/sy pr. kerne (med mpstat) og holder øje med, om enkelte sockets „kører varmt“, mens andre står i tomgang. Uhensigtsmæssig hukommelseslokalisering fører til flere stigninger i cs/sy og b/wa på grund af fjerne hukommelsesadgange. Jeg tester CPU- og hukommelsesaffinitet (cpuset, numactl), indstiller store heaps til „interleaved“ eller »strictly local« og sørger for, at hot-threads kører der, hvor deres data-footprint befinder sig. Et stabilt NUMA-layout udjævner cs, reducerer wa-udfald og øger Planlægbarhed under belastning.
Undgå misforståelser: wa og b er mere end blot „langsomme datamedier“
wa stiger ikke kun ved klassiske diskforsinkelser: Også NFS/netværk med høj forsinkelse, mættet objektlagring, blokerende cloud-volumener eller langsomme page-cache-writebacks presser wa op. b tæller opgaver i uafbrydelig dvaletilstand (D-state) – herunder også fastlåsninger i drivere, netværksstier eller filsystemlåse. Derfor vurderer jeg aldrig wa/b isoleret, men altid sammen med bi/bo og applikationstiminger. Hvis wa er højt, men bi/bo er lavt, er der ofte tale om en Afhængighed af ventetid ud over det rent tekniske spørgsmål om enhedens gennemstrømning (f.eks. locking, remote I/O, writeback-kø).
Tuning med sans for proportioner: Swappiness, Writeback, Scheduler
Jeg ændrer først Kernel-Tuner efter at have foretaget målinger og med en plan for tilbageførsel:
- vm.swappiness: En lav værdi dæmper proaktivt swapping, hvilket er godt for applikationer, hvor latenstiden er afgørende – en for lav værdi kan øge presset på sidecachen.
- vm.dirty_background_ratio / vm.dirty_ratio (eller *_bytes): Påvirker tidspunktet for writeback. For høje værdier medfører lange skrivebursts (wa-spidser), mens for lave værdier øger antallet af små, konstante flushes (sy/bo stiger).
- I/O-scheduler/kødybde: Andre Optima-indstillinger på NVMe end på HDD/RAID. Jeg måler afvejningerne mellem latenstid og gennemstrømning med iostat, før jeg foretager ændringer.
- Netværksstier: Der strømmer mange små pakker/interrupts ind i /cs/sy. De vigtigste indstillingsmuligheder er GRO/LRO, RPS/RFS og IRQ-affinitet – jeg måler før og efter.
Mit mål er stabile, forudsigelige kurver i vmstat: us/sy skal være mere jævne, wa/b lavere, si/so tæt på 0. Først da opgraderer jeg hardwaren.
Playbook: 3-minutters analyse med vmstat
- 0:00–0:30 – „vmstat 1 30“: Ignorer den første linje, og gennemgå derefter r/b, us/sy/id/wa. Spørgsmål: CPU-begrænsning (r høj, id lav) eller I/O-begrænsning (b/wa høj)?
- 0:30–1:00 – Visning af akkumulator: Kontroller swpd og si/so. Er si/so konstant > 0? → ægte akkumulatortryk. free er underordnet.
- 1:00–1:30 – I/O-kontekst: bi/bo vs. wa. Høje bi/bo-værdier uden wa? → I/O kobles fra. Høje wa-værdier ved moderate bi/bo-værdier? → Latens/lock/remote-I/O.
- 1:30–2:00 – system-sektion: in/cs i forhold til sy. Er cs meget højt? → Undersøg trykket fra kontekstskift, parallelitet/låsning.
- 2:00–3:00 – Fastlægge hypotesen og vælge det rette værktøj: iostat til I/O-indeks, mpstat til kerneasymmetrier, pidstat til proces-hotspots. Først derefter tuning/skalering.
Udvidede eksempler fra praksis
- CPU-mætning uden høj r: us+sy ved 90%+, id ≈ 0, men r er moderat → single-thread-hotspot eller affinitetsproblem. Løsning: Paralleliser hot-path, kontroller core-pinning.
- Swap-Thrash: uanset hvad er værdien tydeligt > 0, b/wa stiger, us falder → RAM er alt for lille, eller heap er forkert dimensioneret. Foranstaltninger: Øg RAM, reducer arbejdsmængden, juster swappiness.
- Kernel-overhead: sy høj, cs/in høj, us moderat → mange små systemkald/I/O. Løsning: Batch-behandling, reduktion af systemkald, tjek af filsystemets mount-indstillinger.
- Tilbageførselsophobning: wa høj, bo høj, korte bølger → dirty-grænser for høje, lagringslatens varierer. Gennemgå writeback-tuning og I/O-scheduler.
- Presset for virtualisering: st synlig, r svinger, id „springer“ → Værten deler CPU. Løsning: Kontroller vCPU-tildeling/placering, reducer overcommit.
Kend vmstats begrænsninger
Vmstat er et fremragende Tidlig varslingssensor, men ikke et mikroskop. Det viser mig, at der er et problem, og hvor det ligger – ikke den enkelte skyldige fil, forespørgselen eller tråden. Derfor går jeg efter vmstat-diagnosen konsekvent i gang med avancerede værktøjer, bekræfter hypoteser fra flere vinkler og ændrer derefter kun én ting ad gangen. På den måde forbliver forbedringerne målbare og reproducerbare.
Opsummering fra praksis
Med vmstat kan jeg på få sekunder se, om det er CPU, RAM, swap eller I/O, der bremser, ved at se på r, b, si/so, bi/bo og us/sy/id/wa/st i samspil læse. Jeg vurderer tendenser frem for enkeltværdier, sammenligner med referenceværdier og inddrager om nødvendigt iostat, mpstat, pidstat samt historiske målinger. Den første linje ignorerer jeg i tilfælde af akutte forstyrrelser og koncentrerer mig om de efterfølgende linjer med fast samplingsfrekvens. Jeg træffer datadrevne beslutninger: r i forhold til kerner, si/so vedvarende forskellig fra 0, wa vedvarende forhøjet, us+sy tæt på fuld udnyttelse. På den måde udleder jeg hurtigt konkrete foranstaltninger og holder systemerne mærkbart reaktiv.


