 Videre til indhold

Adaptiv flushing i MariaDB styrer, hvor hurtigt jeg Beskidte sider skriver fra bufferpoolen til datamediet, så redo-loggen aldrig bliver et flaskehals. Når jeg optimerer MariaDB Adaptive Flushing, falder latenstidstoppe, og Kontrolpunkt-Fremskridtet forbliver stabilt, og skrivebelastningen kan fortsat planlægges.
Centrale punkter
- Målte værdier Først: Redo-log-fyldningsgrad, andel af beskidte sider, checkpoint-alder
- I/O-kapacitet at bestemme det nøjagtigt, ikke at anslå det
- Tærskelværdier Anvendelse med omtanke: adaptive_flushing_lwm og Dirty-Page-LWM
- Baggrunds-I/O dosering: io_capacity og io_capacity_max
- Redo-logfiler Dimensionering, der sikrer en jævn strømning
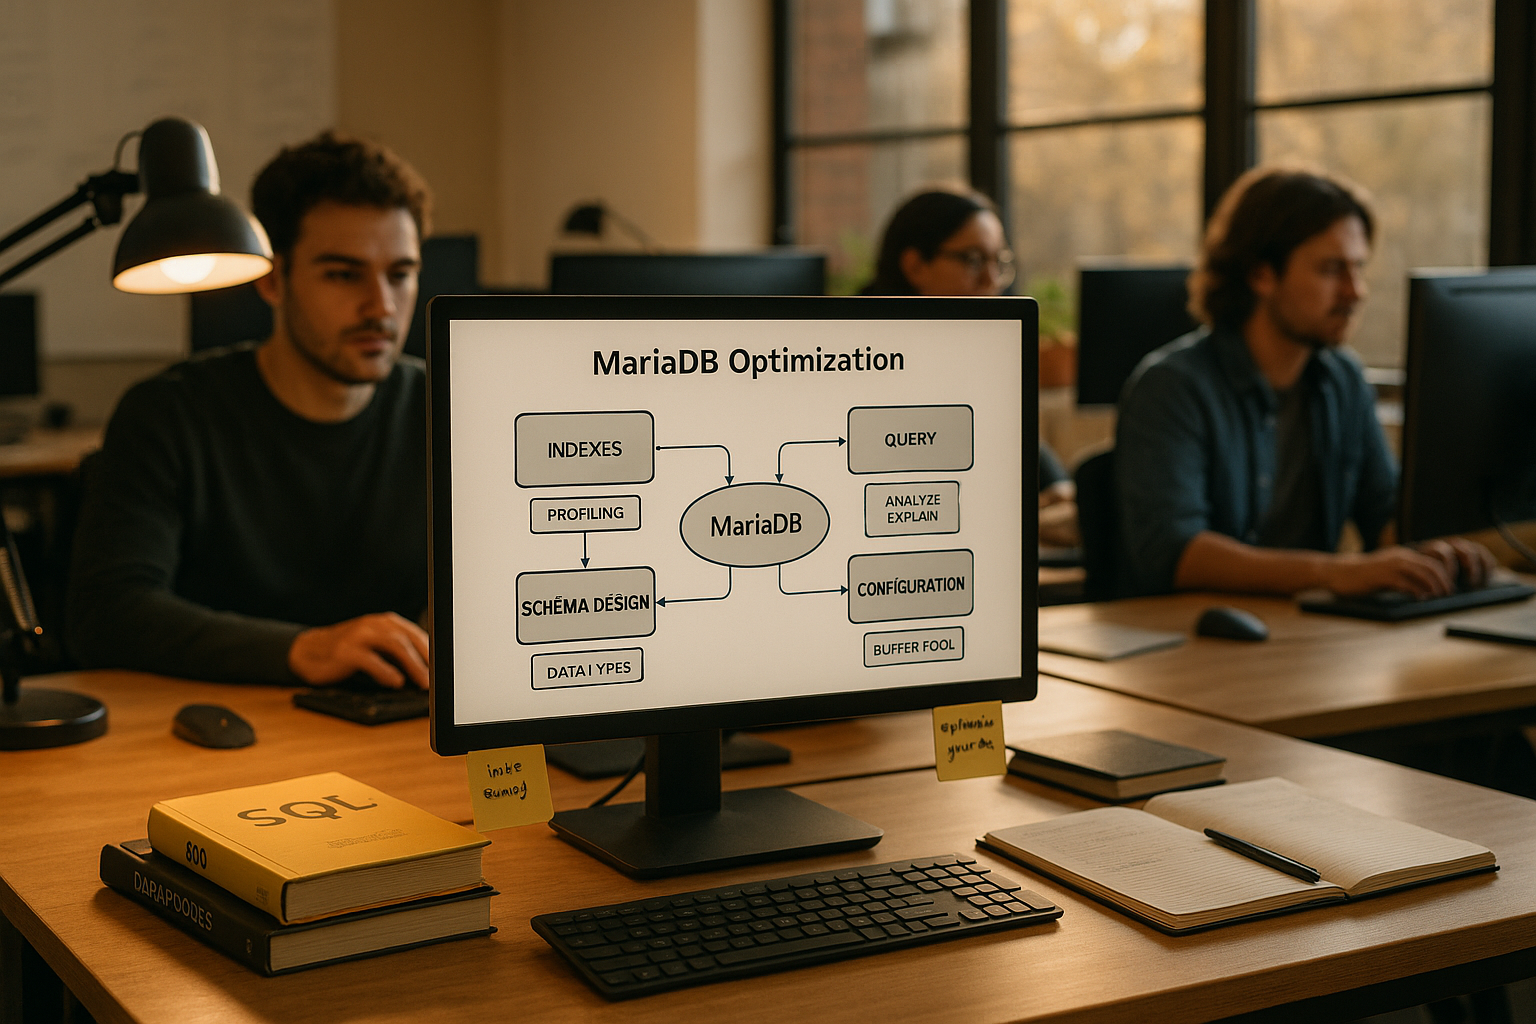
Sådan fungerer Adaptive Flushing i MariaDB
Jeg aktiverer den dynamiske logik via innodb_adaptive_flushing og bidrage til at forme adfærden i forbindelse med tidlig varsling innodb_adaptive_flushing_lwm. Jo mere fyldt redo-loggen er, og jo hurtigere den vokser, desto mere aggressivt udfører InnoDB flush-operationer for at undgå flashtilstand. Denne regel knytter flush-frekvensen til den faktiske ændringsgennemstrømning, hvilket gør, at korte I/O-spidsbelastninger forekommer sjældnere. Ifølge MariaDB-dokumentationen tilpasses intensiteten efter checkpoint-fremskridtet for at undgå ventetider på disk-skrivninger. Jeg er dog opmærksom på, at Adaptive Flushing fordeler arbejdet, men ikke kompenserer for for lav lagerydelse.
Forstå nøgletal: Redo-log, dirty pages og checkpoints
Først ser jeg på den procentvise fyldningsgrad af Redo-logfiler, andelen af »dirty pages« i bufferpoolen og checkpoint-alderen. Disse tre parametre viser mig, om serveren kan tømme bufferen i tide og jævnt, eller om der hober sig arbejde op. Hvis checkpoint-alderen stiger for hurtigt, reagerer Adaptive Flushing, men jeg tjekker da også lagringslatensen. Hvis jeg har detaljerede spørgsmål om I/O-strategien, hjælper det mig at kigge på de relevante Flush-metoder, fordi de bestemmer, hvor effektivt kernen behandler skrivekommandoerne. Jeg sammenkæder disse signaler med den målte I/O-kapacitet, så jeg kan foretage målrettede ændringer af tærskelværdierne, samtidig med at det samlede system forbliver sammenhængende.
Indstil justeringsskruerne korrekt
Jeg begynder med innodb_io_kapacitet og sæt værdien tæt på akkumulatorens reelle kontinuerlige ydelse, ikke på de teoretiske maksimumsværdier. Hvad angår spidsbelastninger, mener jeg, at innodb_io_capacity_max betydeligt højere, så InnoDB kortvarigt kan øge ydeevnen under belastning uden at overbelaste CPU’en. Tærskelværdien innodb_adaptive_flushing_lwm Jeg indstiller det således, at serveren begynder med preflushing i god tid, før redo-loggen bliver fuld. Derudover indstiller jeg innodb_max_dirty_pages_pct_lwm således at InnoDB griber ind tidligt, når andelen af beskidte sider stiger, og der dermed undgås flaskehalse. Jeg ændrer kun én parameter pr. cyklus, registrerer virkningen nøje og giver systemet tid til at gennemgå flere belastningsfaser, før jeg fortsætter med at optimere.
Konkret måling af I/O-kapacitet
Jeg måler den kontinuerlige skriveydelse under produktionsbelastning, fordi syntetiske spidsbelastningstests ofte skaber falske forventninger, og Ensartethed skjule. Det er de mellem- til langsigtede gennemsnit og percentiler, der er relevante, da de holder stand over korte udjævningsperioder. Jeg ser på Write-IOPS, Write-Throughput, latenstider og fordelingen af responstiderne, så jeg ikke kun ser på gennemsnitsværdien. Hvis man kun tager udgangspunkt i maksimumsværdien, risikerer man aggressive flush-faser, mens de egentlige transaktioner bliver langsommere. Jeg drager konklusioner for innodb_io_kapacitet ud fra den observerede holdbarhed, ikke ud fra kortvarige rekordtider.
Oversigt over startværdier og grænseværdier
Jeg bruger standardværdier som udgangspunkt, aldrig som et dogme, og sammenligner dem med den faktiske arbejdsbelastning, størrelsen på bufferpoolen og væksten i Redo-logfiler. SSD- og NVMe-systemer har klart højere værdier end HDD’er, men jeg indstiller hastighederne kun så højt, at læseadgange ikke havner i køen. For systemer med høj belastning øger jeg kapaciteten gradvist og overvåger samtidig latenstid, checkpoint-alder og CPU-forbrug. Hvis andelen af beskidte sider falder jævnt, og udsvingene i redo-log-fyldningsgraden mindskes, har jeg opnået en sund sikkerhedsmargen. Det er stadig afgørende for mig, at jeg Tips kontroller dem i stedet for at overdøve dem med overdreven baggrunds-I/O.
| Variabel | Effekt | Typisk startværdi for HDD | Typisk startværdi for SSD | Typisk startværdi for NVMe | Hvad jeg lægger mærke til |
|---|---|---|---|---|---|
| innodb_adaptive_flushing | Aktiverer dynamisk flush | ON | ON | ON | Udligning af bursts |
| innodb_adaptive_flushing_lwm | Tidlig forskylning | 20–30% | 20-40% | 30–50% | Redo-log-fyldningsniveau |
| innodb_io_kapacitet | Grundlæggende flush-rate | 100-300 | 800–2000 | 2000–8000 | Vedvarende skrive-IOPS |
| innodb_io_capacity_max | Nødgrænse | 400–800 | 2000-6000 | 6000–20000 | Fjerne spidser |
| innodb_max_dirty_pages_pct_lwm | Dirty Page – Lavt vandniveau | 5–10% | 5–15% | 5–15% | Tidlig indgriben |
At genkende problemtilfælde og symptomer
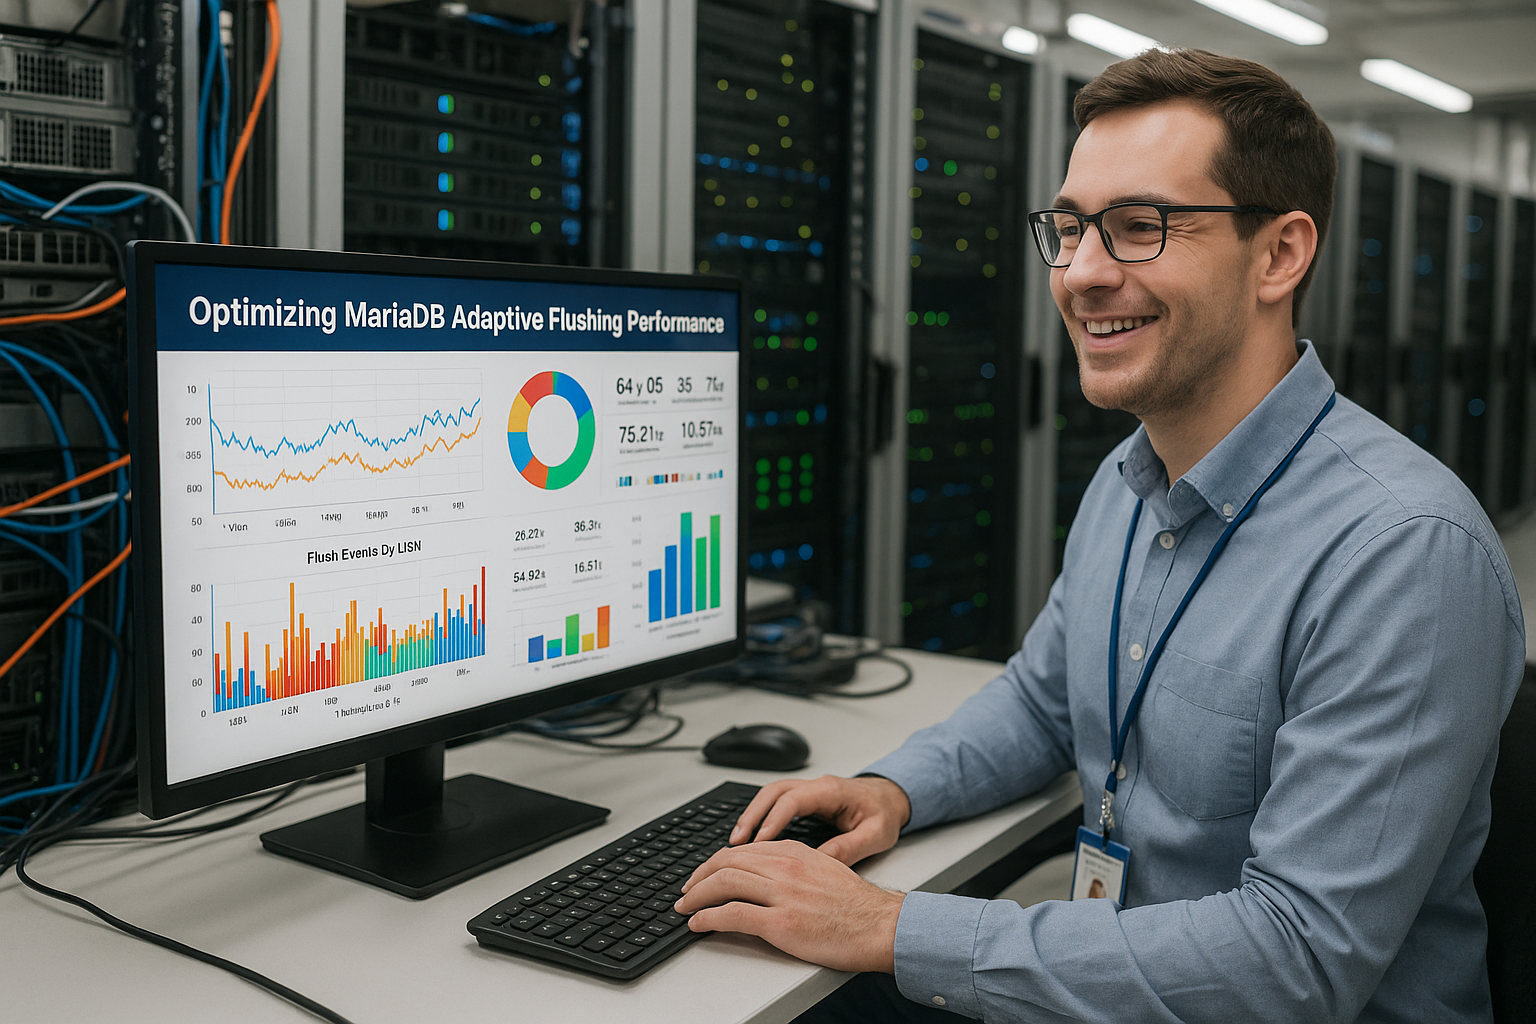
Når jeg Skylle-spidser, tjekker jeg først I/O-værdien: hvis den er for lav, hober de »dirty pages« sig op, og systemet bliver nødt til hurtigt at rydde op. Er værdien for høj, overskygger baggrunds-I/O den aktuelle arbejdsbelastning og tvinger læseoperationer til at vente. En træg checkpoint-alder, der pludselig skyder i vejret, afslører, at serveren reagerer for sent. Samtidig signalerer en hurtigt stigende redo-log-fyldningsgrad, at skrivesiden ikke kan følge med, eller at loggen er for lille. Jeg fortolker disse mønstre samlet, fordi et enkelt tal sjældent fuldt ud forklarer, hvordan Adaptive Flushing opfører sig.
Dimensionering af redo-log for jævn belastning
Jeg vælger størrelsen på Redo-logfiler således at der er tilstrækkelig buffer til belastningsbølger, uden at checkpoints bliver for lange. En større logfil giver Adaptive Flushing mere spillerum til at sprede arbejdet, men jeg holder øje med gendannelsestider og lagerbudget. Hvis logfilen vokser med hvert sekund mod grænsen, mindsker en moderat forøgelse presset og udjævner flush-kurven. Hvis forøgelsen ikke giver nogen aflastning, ligger problemet oftest i utilstrækkelig I/O-kapacitet eller svingende lagringslatens. Jeg beslutter først efter observationsvinduer, ikke ud fra øjebliksbilleder, om jeg skal hæve logstørrelsen yderligere.
Page Cleaner-tråde og parallelitet
Jeg ser på antallet af Page-Cleaner-tråde, fordi de udfører den parallelle Skylle-Styre ydeevnen for bufferpool-instanserne. Ved høj skrivebelastning giver yderligere parallelitet større gennemstrømning, men jeg overvåger lagringskøen nøje. Hvis datamediet mister sin effektivitet på grund af overfyldte køer, reducerer jeg antallet af tråde eller begrænser I/O-kapaciteten. For at få en bedre forståelse af denne mekanisme hjælper oversigten over Page-Cleaner-tråde, så jeg kan opretholde balancen mellem pres og retfærdighed. Jeg træffer en pragmatisk beslutning: så mange tråde som nødvendigt, så få som fornuftigt, så læsningerne ikke kommer i baggrunden.
Doublewrite-buffer: Sikkerhed kontra skrivehastighed
Jeg tager højde for Doublewrite-Buffer, da den beskytter mod delvise skrivefejl, men medfører ekstra I/O. På pålidelige NVMe-systemer vejer den ekstra belastning mindre tungt, mens den mærkes tydeligere på langsommere lagringsenheder. Jeg måler den faktiske effekt på latenstider og page-flush-rate, før jeg justerer denne indstilling. For at kunne træffe en velovervejet beslutning benytter jeg mig af uddybende oplysninger om Doublewrite-buffer og undersøger, om en anden risiko- og afkastprofil passer bedre. Jeg træffer aldrig en beslutning på letfærdig vis, fordi datasikkerhed og gennemstrømning her hænger direkte sammen.
Overvågning og måleparametre i praksis
Jeg vurderer andelen af »Dirty Pages«, forholdet mellem flush-rate og ændringsrate samt udviklingen i Kontrolpunkt-Age. Derudover overvåger jeg den procentvise udnyttelse af redo-loggen over tid, da en lineær stigning tyder på, at tærskelværdierne snart er nået. Jeg holder øje med I/O-forsinkelserne sideløbende med InnoDB-statistikkerne, så jeg klart kan sammenholde årsag og virkning. Efter hver parameterændring sammenligner jeg identiske belastningsvinduer, ellers drager jeg forkerte konklusioner. Jeg dokumenterer kurverne, fordi et billede siger mere end et enkelt målepunkt, og jeg dermed sikkert kan genkende brud på tendenser.
Trin-for-trin tuningsplan
Jeg begynder med en realistisk måling af Skrivehastighed og fastsætter ud fra dette værdien for innodb_io_capacity. Derefter definerer jeg innodb_io_capacity_max som en nødløsning i pressede situationer, med tilstrækkelig afstand til basisværdien. Dernæst tjekker jeg innodb_adaptive_flushing_lwm og sænker værdien, hvis Checkpoint-Age falder for sent. Herefter indstiller jeg innodb_max_dirty_pages_pct_lwm, så preflushing starter i tide, og spidsbelastninger afvikles tidligt. Til sidst justerer jeg redo-log-størrelsen, observerer igen flere belastningscyklusser og dokumenterer hver ændring, før jeg tager det næste skridt.
Flush-mekanisme under hætten
Jeg skelner mellem to hovedmotiver for at skrive: det Flush-List-Flushing (drevet af fremskridtet i Checkpoint) og det LRU-rensning (forårsaget af mangel på ledige sider). Hvis bufferpoolen bliver fuld, og der mangler ledige sider, tvinger LRU-flushing mig til at foretage øjeblikkelige skrivninger, hvilket skaber spidsbelastninger i latenstiden. Adaptiv flushing har til formål at undgå disse tvangssituationer ved løbende at tømme flush-listen. For at dette skal lykkes, holder jeg andelen af frie sider stabil og overvåger værdier som LRU-scanningsdybde og udnyttelsesgraden pr. bufferpool-instans. Jo mere jævnt flush-listen behandles, desto sjældnere skal jeg vente på frie sider i forgrunden.
I den forbindelse tager jeg højde for forholdet mellem innodb_buffer_pool_instances, innodb_page_cleaners og den fysiske I/O-kapacitet. Flere instanser og Cleaner-tråde øger paralleliteten, men kun i det omfang, det er fornuftigt, så længe lagringskøerne ikke løber over. Hvis flush-operationer når høje kø-længder, er det et tegn på, at jeg burde have foretaget flush tidligere og langsommere – netop dette løser jeg via innodb_adaptive_flushing_lwm og basis-/maks-kapaciteterne.
Transaktions-commit, redo og binlog i sammenhæng
Jeg ser på commit-stier og holdbarhedsgarantier i sammenhæng med flush-udjævning. innodb_flush_log_at_trx_commit og binlog-synkroniseringen påvirker, hvor ofte systemet udfører fsyncs, og hvor store de kortvarige spidsbelastninger bliver. Mine retningslinjer:
- 1: Maksimal holdbarhed (Redo ved hver commit på lagringsmediet). Sikkert, men kræver mange fsync-kommandoer og kan potentielt være mere ustabilt.
- 2: Redo tømmes hvert sekund, mens Commit kun skriver til operativsystemets cache. Der er færre spidsbelastninger, men til gengæld risikerer jeg datatab i tilfælde af nedbrud i operativsystemet eller på værten.
- 0: Ligner 2, men cachen er endnu mere aggressiv. Bør kun bruges med forsigtighed i produktionssystemer.
Sammen med Binlog-synkroniseringen (sync_binlog) og Group-Commit-effekter kan jeg samle commits og reducere antallet af hårde synkroniseringer. Det er vigtigt, at jeg ikke misbruger disse værktøjer som erstatning for en ordentlig finjustering af Adaptive Flushing. Jeg vurderer altid risiko, compliance-krav og den ønskede latenstidsprofiler samlet og justerer kun i det omfang, forretningsreglerne tillader det.
Ryd tråde, historiklængde og langvarige tråde
Jeg har den InnoDB-rensning Vær opmærksom på: Mange slettede eller opdaterede linjer genererer fortrydelsesdata, der ryddes asynkront. Hvis Historiens længde Hvis belastningen er stor, stiger baggrundsbelastningen og konkurrerer med side-cleanerne om I/O. Dette kan indirekte bremse Adaptive Flushing. Løsningen er at indstille en passende værdi for purge-parallellitet og undgå langvarige transaktioner, der kunstigt holder historikken åben. Desuden planlægger jeg batch-operationer således, at jeg kontrollerer mængden af redo- og undo-operationer i stedet for at ændre millioner af rækker i små portioner på kort tid.
Change Buffer og Merge-faser
Jeg tager højde for Skift buffer ved intensive opdateringer af sekundære indekser. Det reducerer tilfældig I/O under kørsel, men flytter en del af arbejdet til senere sammenlægningsfaser. Disse sammenlægninger kan skabe en ekstra flush-belastning, hvis de uheldigvis falder sammen med spidsbelastninger i produktionen. Jeg overvåger derfor størrelsen og aktiviteten i ændringsbufferen, begrænser den om nødvendigt og spreder bulkændringer, så sammenlægningsfaser ikke kolliderer med spidsbelastninger. Dermed forbliver flush-frekvensen mere forudsigelig og jævn.
Flush-metoder og filsystemets indflydelse
Jeg træffer en bevidst beslutning om Flush-metoden og filsystemindstillingerne. O_DIRECT undgår dobbelte cacher og udjævner dermed ofte skrivelatenser, mens AIO og Fsync-stier har deres egne karakteristika. Jeg måler, hvordan disse metoder påvirker latenstidsfordelingen og stabiliteten i checkpoint-fremskridtet, og henviser ved detaljerede spørgsmål til vejledningen om Flush-metoder. Derudover tjekker jeg filsystemets monteringsindstillinger og vedligeholdelsesrutiner (f.eks. konsistente TRIM-/Discard-strategier for SSD’er), så infrastrukturen ikke ubevidst forårsager jitter.
Diagnose: Korrekt aflæsning af statusmeddelelser
Jeg trækker VIS INNODB-STATUS FOR MOTOREN for at vurdere Checkpoint-Age og Flush-fremskridt. Fra Log-sekvensnummer, Loggen er ryddet frem til og Sidste kontrolpunkt ved undersøger jeg, hvor stor forskellen er mellem genererede og gemte ændringer. Hvis forskellen vokser kontinuerligt hurtigere, end redo-log-størrelsen tillader, er min baggrunds-flush for forsigtig, eller er I/O-latensen for høj. Jeg sammenligner disse værdier med InnoDB-metrikkerne for »Dirty Pages«, flush-rate og Page Cleaner-aktivitet, så jeg målrettet kan justere de relevante parametre i stedet for blot at behandle symptomerne.
Driftsscenarier: Bulk, DDL og vedligeholdelsesvinduer
Jeg planlægger Storlast og omfattende DDL-operationer, så Adaptive Flushing ikke overskrides. I forbindelse med planlagte vedligeholdelsesvinduer øger jeg midlertidigt innodb_io_capacity_max, for at udføre de forestående skrivninger på en kontrolleret måde, og sænker den derefter igen til det normale niveau. Ved store importoperationer justerer jeg commit-frekvenserne, så væksten i redo-loggen og fremskridtet i checkpoint-processen holder trit. I mellemtiden overvåger jeg løbende redo-log-fyldningsgraden, andelen af beskidte sider og latenstidens percentiler, så jeg straks kan gribe ind, hvis der opstår afvigelser.
Almindelige misforståelser og anti-mønstre
Jeg falder ikke i fælden, innodb_io_capacity_max at bruge det som en permanent tilstand. En for høj Max-værdi kan overbelaste hukommelseskøerne og bremse realtidslæseadgang. Jeg „skjuler“ heller ikke svag hukommelse bag en kæmpe redo-log – større logfiler udjævner belastningen, men skaber ikke I/O-reserver. Og jeg accepterer ikke latenstops som en given kendsgerning: Ofte er de resultatet af for sen preflushing eller stærkt svingende baggrundsbelastning, som jeg kan afbøde ved hjælp af lavere LWM-tærskler og realistiske kapacitetsværdier. Endelig undgår jeg at ændre flere indstillingsparametre på samme tid; ellers mister jeg kausaliteten og kan ikke gøre forbedringerne reproducerbare.
Kort opsummeret
Jeg bruger Adaptiv Flushing for at fordele skriveopgaver jævnt over tid og dermed undgå spidsbelastninger. Den største indflydelse opnås ved en præcis indstilling af innodb_io_capacity og et fornuftigt forhold til innodb_io_capacity_max. Tidligt indsatte tærskelværdier for redo-log-fyldningsgrad og andel af beskidte sider hjælper mig med at holde køerne små. Med passende redo-logs, fornuftig parallelitet mellem page-cleaner-trådene og opmærksom overvågning opnår jeg mere pålidelige skriverutiner. Ifølge MariaDB-dokumentationen om systemvariabler og sideflushing virker disse justeringsmuligheder sammen – jeg justerer dem trin for trin og holder øje med effekten, indtil systemet kører stabilt og forudsigeligt.


