Der Linux cgroup CPU Controller steuert, wie viel Rechenzeit Dienste, Container und Prozesse erhalten, und macht Leistung gezielt planbar. Ich erkläre konkret, wie Gewichtung, Quoten und Praktiken zusammenspielen, damit du CPU-Zeit sicher zuteilst und Engpässe vermeidest.
Zentrale Punkte
- Gewichtung versus Limit verstehen: fair teilen oder harte Obergrenze
- cgroup v2 bevorzugen: klare Semantik, konsistente Hierarchie
- cpu.weight und cpu.max: die zwei Stellhebel
- systemd nutzen: Regeln pro Dienst setzen
- Monitoring und Transparenz: cpu.stat und PSI lesen
cgroups verstehen: Prozessgruppen und Ziele
Ich fasse Prozesse in Gruppen zusammen und steuere darüber Ressourcen wie CPU, Speicher und I/O in sauber abgegrenzten Hierarchien. Statt einzelne PIDs zu jonglieren, ordne ich komplette Dienste, Container oder Worker-Pools einer Control Group zu und lege klare Regeln fest. So verhindere ich, dass ein ausufernder Task die Maschine ausbremst, während wichtige Komponenten reagieren müssen. Gerade im Hosting-Kontext zahlt sich diese Herangehensweise aus, weil viele Mandanten und Dienste auf gleicher Hardware laufen. Einen guten Überblick zur praktischen Einordnung liefert dieser Beitrag zu cgroups und Hosting, der die Trennung von Lasten nachvollziehbar macht.
Wie der CPU-Controller arbeitet
Der CPU-Controller teilt Rechenzeit über zwei Mechanismen zu: relative Gewichtung und absolute Bandbreitenbegrenzung. Gewichtung bedeutet, dass Gruppen im Verhältnis zueinander CPU-Anteile bekommen, sobald Konkurrenz entsteht; höhere Werte gewinnen dann häufiger Zeitscheiben. Ein Limit per Quote deckelt den Verbrauch in einem festen Zeitfenster, auch wenn keine Konkurrenz besteht. Ich wähle Gewichtung, wenn Fairness und dynamische Auslastung im Vordergrund stehen, und setze Quoten, wenn eine harte Obergrenze unverrückbar bleiben muss. Die Kernel-Dokumentation stellt diesen Unterschied klar dar und zeigt, wie beide Mechanismen zusammen ein schlüssiges Steuerungsmodell ergeben [1].
cgroup v1 vs. v2: Unterschiede und Dateien
Mit cgroup v2 verwalte ich CPU-Regeln einheitlich und übersichtlicher gegenüber der älteren v1-Variante. In v1 nutzte ich verschiedene Dateien je Controller; in v2 konzentriere ich mich auf cpu.weight für relative Priorität und cpu.max für ein hartes Bandbreitenlimit. Diese klare Trennung verkürzt Einrichtungszeit, vermeidet Missverständnisse und erleichtert Audits. In Hosting-Szenarien mit vielen Containern sorgt die v2-Hierarchie für nachvollziehbare Regeln über alle Ebenen. Eine Einschätzung zur Praxis liefert der Beitrag zu cgroup v2 im Hosting, der auf konsistente Steuerung bei gemeinsam genutzter Hardware eingeht.
| Thema | cgroup v1 | cgroup v2 | Typische Parameter |
|---|---|---|---|
| CPU-Gewichtung | cpu.shares | cpu.weight | cpu.weight (Standard oft 100) |
| CPU-Quote/Limits | cpu.cfs_quota_us + cpu.cfs_period_us | cpu.max | cpu.max (z. B. 20000 100000) |
| Hierarchie | Getrennte Controller | Einheitliche Baumstruktur | Gemeinsame Regeln je Ebene |
| Echtzeit | Separater rt-Controller | Einschränkungen für RT | Siehe Kernel-Hinweise [1] |
Für Administratoren zählt, dass Konsistenz im Regelwerk Fehler reduziert und Änderungen schneller durchgreifen. Ich dokumentiere Parameter an den Gruppenknoten, damit jede Person die aktuelle Wirkung erkennt. Bei Migrationen von v1 prüfe ich Äquivalente sorgfältig, vor allem Shares zu Weight und CFS-Quota zu cpu.max. Erst wenn Testlasten erwartungsgemäß reagieren, verschiebe ich produktive Dienste in die neue Hierarchie. Diese disziplinierte Umstellung spart später viele Supportzyklen.
Hierarchie, Subtrees und Delegation
In cgroup v2 steuere ich Controller pro Ebene und delegiere sie nach Bedarf weiter. Über cgroup.subtree_control aktiviere ich den CPU-Controller für Kindknoten; systemd übernimmt das in der Regel automatisch, wenn ich CPU-Properties setze. Wichtig: In v2 halte ich Prozesse idealerweise in Blattgruppen und nicht in Zwischenknoten. So bleiben Regeln eindeutiger, und die Lastverteilung folgt klar der Baumstruktur. In komplexen Setups ordne ich ganze Dienste Slices zu (z. B. tenant-a.slice), darunter Services und Worker-Pools. Diese saubere Trennung erleichtert Delegation an Teams, die in „ihren“ Subtrees arbeiten, ohne globale Policies zu verletzen.
Wichtige Parameter: cpu.weight und cpu.max
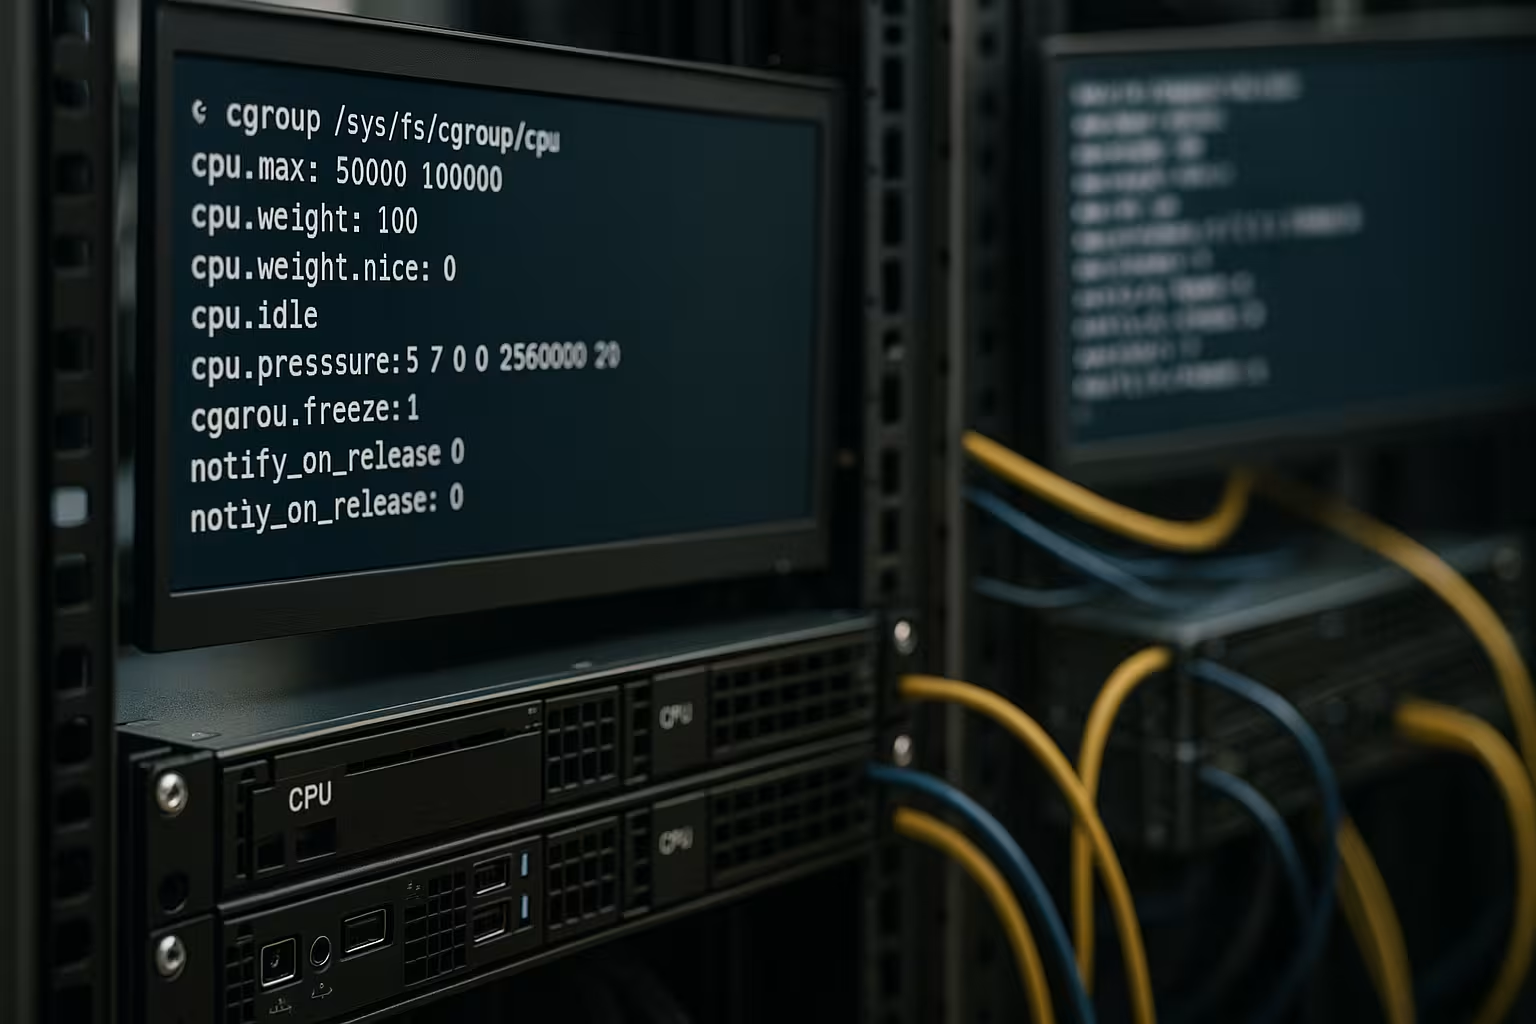
Ich nutze cpu.weight, um Dienste relativ zu priorisieren: Erhält Service A ein höheres Gewicht als Service B, bekommt A unter Last häufiger CPU-Zeiten. Der Standard in v2 liegt häufig bei 100; größere Werte bevorzugen die jeweilige Gruppe, ich bleibe aber innerhalb sinnvoller Spannen, um das Verhältnis kontrollierbar zu halten. Für harte Deckelung schreibe ich in cpu.max eine Quote und Periode, zum Beispiel 20000 100000 für ungefähr 20 Prozent eines vCPU-Slots. Mit max als erstem Wert hebe ich die Deckelung auf, lasse aber die Periode bestehen, was Diagnosen vereinfacht. Red Hat dokumentiert gängige Einstellungen verständlich und zeigt die Auswirkungen im Betrieb [2].
Ergänzende Stellschrauben: cpu.weight.nice und UClamp
Für Teams, die von der klassischen nice-Semantik kommen, bietet v2 mit cpu.weight.nice eine praktische Brücke: Ich kann Gruppen im Bereich -20..19 einstufen, der intern auf die Weight-Skala abgebildet wird. So bleiben relative Erwartungen („ein bisschen bevorzugen“, „leicht drosseln“) konsistent, ohne jedes Mal konkrete Gewichte festzulegen. Darüber hinaus setze ich bei Bedarf Utilization Clamping via cpu.uclamp.min und cpu.uclamp.max, um eine Mindest- bzw. Obergrenze für die effektive CPU-Auslastung auf Scheduler-Ebene vorzugeben. Damit stelle ich z. B. sicher, dass ein latenzkritischer Dienst auch bei geringer Threadzahl nicht unter die benötigte Grundauslastung fällt, oder dass Batch-Jobs keinen zu hohen Boost erhalten. Diese Feineinstellung ergänzt Gewichtung und Quoten, ersetzt sie aber nicht: Ich messe immer, wie sich UClamp mit meiner Governor- und Energiepolitik verträgt, bevor ich es breit ausrolle.
Planung für Workloads: Fairness versus harte Grenzen
Ich entscheide bewusst, ob Fairness oder strikte Obergrenzen Vorrang haben. Für latenzkritische Webdienste erhöhe ich das Gewicht leicht, damit sie bei Konkurrenz bevorzugt laufen, ohne andere Gruppen übermäßig zu benachteiligen. Für rechenintensive Batch-Jobs setze ich zusätzlich eine Quote, damit sie nie zu viel Zeit belegen, selbst wenn das System ansonsten Leerlauf hat. Datenbanken halte ich moderat gewichtet und beobachte, wie Checkpoints, Rebuilds oder große Abfragen wirken; bei Bedarf passe ich zeitlich begrenzt an. Diese Regeln kombiniere ich mit Alarmen, damit ich früh reagiere, bevor Latenzen eskalieren.
Quotenverhalten auf Multicore und Periodenwahl
Ein häufiger Stolperstein ist die Interpretation von Quoten auf Multicore-Systemen. Eine Quote bezieht sich auf die Gesamtrechenzeit der Gruppe pro Periode, nicht auf einzelne Kerne. CPUQuota=200% oder cpu.max = 200000 100000 erlauben grob zwei CPU-Sekunden pro 100 ms Periode – verteilt über alle Threads/Kerne. Das kann bedeuten, dass viele Threads kurzzeitig parallel laufen, bis die Gruppe in der aktuellen Periode „aufgebraucht“ ist und gedrosselt wird. Ich vermeide Missverständnisse, indem ich Quoten stets in „CPU-Slots“ denke und sie an die Parallelität des Dienstes anpasse.
Die Standardperiode liegt häufig bei 100 ms. Engere Perioden (z. B. 50 ms) lassen Drosselung schneller greifen, können aber Mikro-Jitter erzeugen; weitere Perioden glätten, reagieren jedoch träger. Unter systemd passe ich das mit CPUQuotaPeriodSec= an und verifiziere, ob Latenzspitzen oder Throughput-Ziele besser getroffen werden. Für interaktive Dienste messe ich End-to-End-Latenz, für Batch orientiere ich mich an Gesamtdurchsatz und Fairness gegenüber Nachbarn.
Praxis: Einrichtung mit systemd und cgroup v2
Unter systemd setze ich Regeln je Dienst, weil Dienstdateien reproduzierbare Konfiguration ermöglichen. Mit systemctl set-property ändere ich laufend, mit Drop-In-Dateien versioniere ich die Einstellungen sauber. Ein Beispiel: systemctl set-property --runtime nginx.service CPUWeight=150 priorisiert NGINX leicht; systemctl set-property --runtime batch.service CPUQuota=20% deckelt Batch-Jobs. Dauerhaft trage ich in /etc/systemd/system/service.d/limits.conf entsprechende Optionen ein und re-loade die Units. Für einen praktischen Einstieg lohnt ein Blick auf diese Anleitung zu systemd-Resource-Control, die die häufigsten Optionen kurz zusammenfasst.
# Beispiele für systemd v245+ mit cgroup v2
# Relative Priorisierung
systemctl set-property --runtime nginx.service CPUWeight=150

# Harte Obergrenze
systemctl set-property --runtime batch.service CPUQuota=20%

# Kombination in einer Drop-In-Datei
mkdir -p /etc/systemd/system/php-fpm.service.d
cat << 'EOF' > /etc/systemd/system/php-fpm.service.d/cpu.conf
[Service]
CPUWeight=120
CPUQuota=50%
EOF
systemctl daemon-reload
systemctl restart php-fpm.service
Slices für Tenants und Teams
Für Mandanten- oder Teamgrenzen nutze ich Slices als organisatorische Klammer. Ein Slice kapselt mehrere Services und Scopes, die gemeinsam reglementiert werden. So vergebe ich Budgets pro Kunde, ohne jede Unit einzeln zu pflegen, und delegiere Änderungen kontrolliert.
# Tenant-Slice mit Standardregeln
mkdir -p /etc/systemd/system/tenant-a.slice.d
cat << 'EOF' > /etc/systemd/system/tenant-a.slice.d/cpu.conf
[Slice]
CPUWeight=120
CPUQuota=150%
# Optional: Periode für feineres Drosseln
CPUQuotaPeriodSec=100ms
EOF
systemctl daemon-reload
systemctl restart tenant-a.slice
Alle Dienste unter tenant-a.slice erben diese Vorgaben. Für kurzzeitige Peaks erhöhe ich das Gewicht temporär, lasse die Quote aber stabil, damit Nachbarsysteme nicht verdrängt werden.
Monitoring und Troubleshooting
Ich überprüfe Wirkung und Seiteneffekte mit Transparenz in Metriken. Die Dateien cpu.stat und cpu.pressure (PSI) pro cgroup geben mir Anteile, Wartezeiten und Staus, die auf Drosselung oder Überlast hindeuten. Mit top, htop und systemd-cgtop erkenne ich Verteilungstrends live und gleiche sie mit meinen Regeln ab. Wenn Latenzen hochgehen, aber CPU-Idle besteht, liegt das Problem eher an I/O oder Locks statt an CPU-Limits; ich passe Gewichtung dann nicht übereilt an. Nach Änderungen dokumentiere ich Messwerte über mindestens einen Lastzyklus, damit ich falsche Korrelationen vermeide.
Monitoring-Playbook: Was ich konkret lese
cpu.stat: usage_usec, user_usec, system_usec zeigen Verbrauch; nr_periods, nr_throttled, throttled_usec entlarven harte Drosselung. Steigt nr_throttled/nr_periods über einige Prozent, ist die Quote zu eng oder die Periode zu kurz.cpu.pressure: Ich beobachte some avg10/60/300 für latenzrelevante Staus. Ein dauerhaft erhöhter Wert trotz freier CPUs weist auf Lock-Contention, Affinitätskonflikte oder NUMA-Fernzugriffe hin.systemd-cgtopundps: Ich prüfe, ob Threads wirklich parallel arbeiten können oder auf Exklusiv-Ressourcen warten.
Für reproduzierbare Tests setze ich stress-ng, sysbench oder eigene Lastgeneratoren ein und halte vorm/nachher Metrik-Snapshots fest. Erst wenn Messwerte stabil den Erwartungen folgen, rolle ich Änderungen aus.
Echtzeit und Besonderheiten
Bei Echtzeit-Workloads beachte ich die Hinweise der Kernel-Dokumentation, da v2 den CPU-Controller für RT nur eingeschränkt führt. Bestimmte RT-Threads müssen in der Root-cgroup liegen, und die Konfiguration verlangt vorsichtiges Vorgehen. Ich prüfe außerdem, wie sich RT-Scheduling mit Quoten verträgt, damit keine Deadline unbeabsichtigt kippt. Für typische Web- und Datenbankdienste nutze ich normale Policies, weil diese Konstellation im Alltag sicherer planbar bleibt. Wenn ich RT brauche, trenne ich Systeme oder reserviere Kerne klar, damit keine unerwarteten Wechselwirkungen eintreten [1].
Feinsteuerung auf Multi-Core-Systemen
Der CPU-Controller teilt Zeitfenster, nicht Taktrate, daher kombiniere ich ihn bei Bedarf mit cpuset und Affinität. Für rauscharme Latenz kappe ich Cross-Socket-Wechsel, binde Threads an NUMA-lokale Kerne und optimiere IRQ-Verteilung. Batch-Services lasse ich flexibler laufen, damit sie Restkapazität einsammeln, ohne Kerne für kritische Frontends zu blockieren. Ich überprüfe Turbo- oder Powersave-Politiken, weil Frequenzänderungen das Verhalten unter Last stark verändern können. Erst die Summe aus Quoten, Gewichten, CPU-Affinität und Energie-Strategie liefert konsistente Ergebnisse.
SMT, NUMA und Affinität in der Praxis
Auf Systemen mit SMT/Hyper-Threading beachte ich, dass zwei logische Threads auf einem physischen Kern nicht zwei volle CPU-Slots liefern. Eine Quote von „100 %“ deckt einen logischen Slot ab, nicht zwingend eine volle physische Kernleistung. Ich messe deshalb Latenz und Throughput mit und ohne SMT-Nutzung. Bei NUMA-Systemen beschränke ich kritische Dienste mit AllowedCPUs= (cpuset) oder CPUAffinity= auf lokale Kerne und stelle Speicherbindung entsprechend ein, damit Remote-Zugriffe nicht jede Feinplanung zunichtemachen.
Best Practices für Hosting und Container
Ich starte mit moderaten Defaults: Webdienste leicht höher gewichten, Datenbanken nahe Standard, Batch mit Quote. Für Tenants setze ich Obergrenzen pro Kunde und erlaube Burst über Gewichtung, solange kein anderer Bedarf besteht. Ich dokumentiere Profile nach Use-Case, etwa „latenzkritisch“, „gemischt“ und „rechenlastig“, und lege pro Profil klare Spannweiten für weight und cpu.max fest. Änderungen spiele ich zuerst in Staging und mit synthetischer Last aus, die Spitzen realistisch abbildet. Logs und Metriken halte ich nah an den cgroup-Grenzen, damit Diagnosen nicht im Nebel enden.
Container-Orchestrierung: Shares, Requests und Limits
In Container-Umgebungen mappe ich Requests auf relative Gewichtung und Limits auf harte Quoten. Das erlaubt Burst, solange Knoten freie Kapazität haben, und sorgt unter Konkurrenz für faire Verteilung gemäß Gewicht. Kritische Pods oder Services erhalten etwas mehr Gewicht, ohne dass Limits anderen die Luft nehmen. Ich achte darauf, dass die Summe der Limits pro Node realistisch zur vorhandenen CPU passt; sonst kommt es trotz sauberer Regeln zu systemweiter Drosselung, die alle Tenants trifft.
Beispiel-Konfigurationen und Rechenbeispiele
Ich rechne Quoten immer in Anteile pro vCPU-Slot um: cpu.max = QUOTA PERIOD entspricht QUOTA/PERIOD des Slots. Beispiel: 20000 100000 sind 0,2 einer einzelnen CPU; auf vier CPUs ist das maximal 0,8 Gesamtslot, aber nicht garantiert verteilt. Für Prozentangaben unter systemd schreibe ich CPUQuota=20%, was je nach Version mit cpu.max harmoniert. Wer harte Grenzen setzt, muss Burst-Verhalten gegen Latenz messen: Eine zu enge Periode kann Mikroruckler erzeugen, eine zu weite Periode verteilt glatter, reagiert aber träger. Ich teste daher Perioden zwischen 50–100 ms und wähle die Variante, die zur Latenzklasse des Dienstes passt [2].
Migration v1 → v2 ohne Überraschungen
Beim Umstieg überführe ich cpu.shares in cpu.weight und cpu.cfs_quota_us/period_us in cpu.max. Ein pragmatisches Mapping für Shares ist: 1024 → ~100, 2048 → ~200, 512 → ~50. Feinkorrekturen nehme ich nach Lasttests vor, denn die Skalen unterscheiden sich. Ich plane außerdem, dass v2-Regeln für Kinder kumulativ wirken: Eine drosselnde Quote am Elternknoten limitiert alle Untergruppen zusammen. Deshalb hebe ich Elternquoten oft auf (max) und reguliere granular in den Blättern, damit ich Seiteneffekte vermeide.
Häufige Fehlerbilder und Gegenmaßnahmen
- 100 % verwechselt mit „alle Kerne“: 100 % entsprechen einem logischen CPU-Slot, nicht der gesamten Maschine. Lösung: Quote anhand benötigter Slots kalkulieren (z. B. 400 % für vier Slots).
- Zu enge Periode: Mikroruckler bei interaktiven Diensten. Lösung: Periode erhöhen oder Gewicht statt Quote nutzen.
- Gewichtung ohne Konkurrenz gemessen: Gewicht entfaltet Wirkung erst bei Wettbewerb. Lösung: Tests mit realer Parallel-Last fahren.
- Eltern-Quoten vergessen: Ein limitierter Parent drosselt alle Kinder. Lösung:
cpu.max=maxam Parent, Limits an den Blättern. - NUMA/Sockel ignoriert: Latenz trotz freier CPU. Lösung: Affinität/CPUSets und Speicherlokalität prüfen.
Zusammenfassung
Mit dem CPU-Controller teile ich Rechenzeit gezielt zu, lege faire Prioritäten fest und setze harte Grenzen dort, wo sie nötig sind. cgroup v2 bringt dabei klare Parameter mit cpu.weight und cpu.max, die ich je nach Workload plane und messe. Über systemd setze ich Regeln pro Dienst, prüfe die Wirkung mit cpu.stat und PSI und justiere ohne Ratespiel. Für Tenants, Container und gemischte Serverlandschaften bleibt diese Steuerung ein Schlüssel, um Verlässlichkeit und Vorhersagbarkeit zu erreichen. Wer Regeln dokumentiert, schrittweise einführt und mit Lasttests absichert, verhindert Engpässe und behält die Kontrolle über die CPU-Zeit.