Ich erkläre kurz und fundiert, wie Event MPM die Apache Event Queue nutzt, um viele gleichzeitige HTTP-Verbindungen effizient zu steuern. Dabei zeige ich die Grundlagen, den Event-Loop, interne Warteschlangen und konkrete Optimierungsschritte für eine performante Konfiguration.
Zentrale Punkte
- Event-Loop trennt Verbindungsverwaltung und Request-Arbeit
- Keep-Alive blockiert keine Threads mehr
- Event Queue sortiert Sockets nach Zustand
- Parameter wie MaxRequestWorkers gezielt abstimmen
- Monitoring sichert verlässliche Kapazitätsplanung
Wie Event MPM Verbindungen steuert
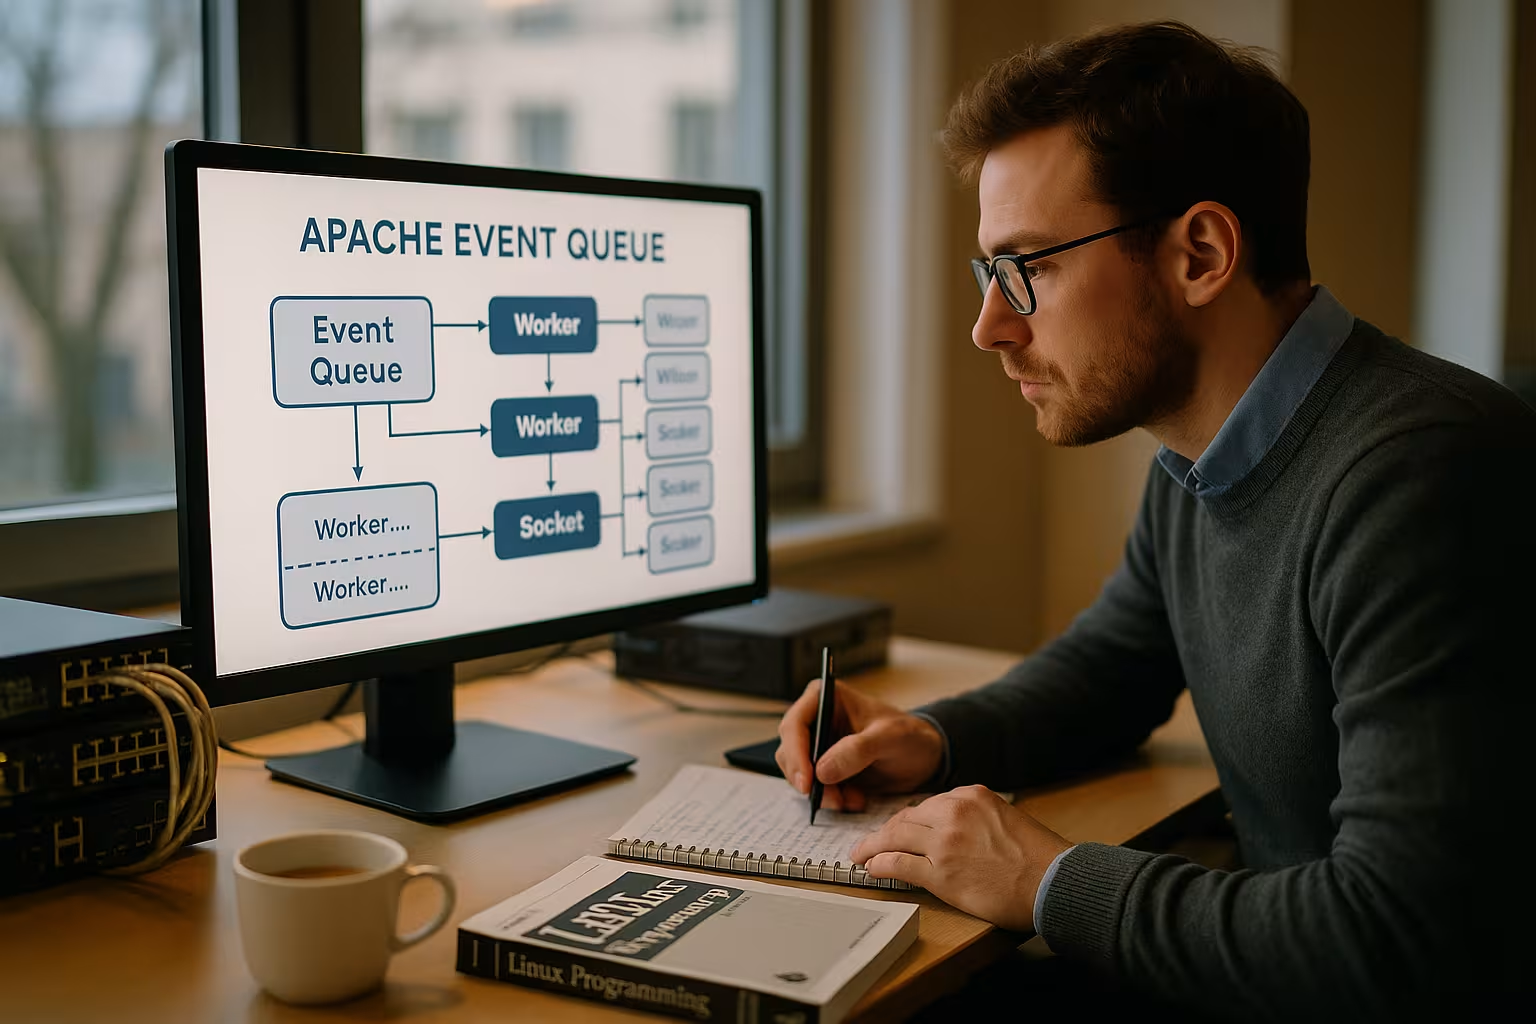
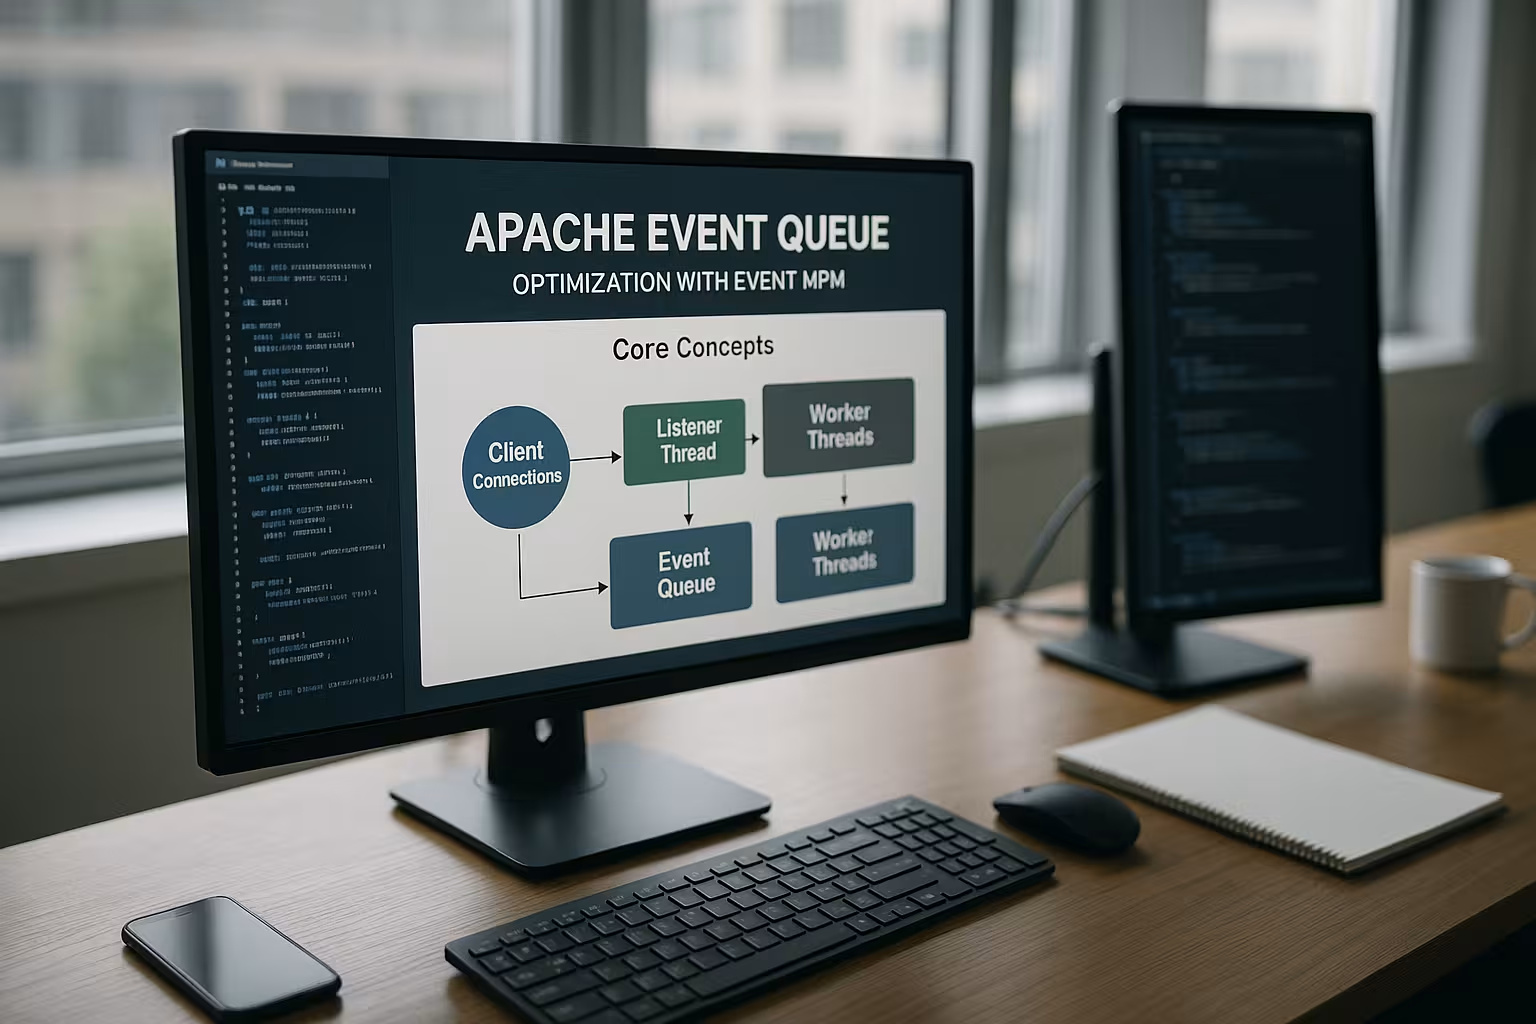
Ich starte mit der Frage, wie Apache unter Last so viele Verbindungen verwaltet. Event MPM kombiniert Prozesse und Threads, priorisiert aber Ereignisse über einen Event-Loop. Listener-Threads akzeptieren neue Sockets und beobachten bestehende Verbindungen, ohne sofort einen Worker zu blocken. Erst sobald Daten lesbar oder schreibbar sind, übergibt die Event-Schicht den Socket an einen freien Worker-Thread. So verhindenre ich, dass Leerlauf-Verbindungen Threads besetzen und Speicher verschwenden.
Diese Trennung senkt die RAM-Last spürbar. Threads machen vor allem „echte Arbeit“ wie Request-Parsing, Antwortgenerierung oder Proxying. Der Event-Loop bringt Sockets danach wieder in den passenden Zustand, etwa zurück in Keep-Alive oder in die Abschlussphase. Ich beobachte in der Praxis kürzere Warteschlangen bei Lastspitzen, weil freie Threads schneller wieder verfügbar werden. Die Architektur liefert eine klar skalierende Reaktionsfähigkeit für typische HTTP/1.1- und HTTP/2-Workloads.
Die Apache Event Queue im Detail
Die Event Queue ordnet jede Verbindung einem Zustand zu, und genau hier liegt der Gewinn gegenüber klassischen MPMs. Neue Verbindungen landen zuerst in einer Queue, die auf Lesbarkeit prüft. Treffen Daten ein, verschiebt der Event-Loop den Socket in eine „readable“-Queue und weist ihn einem Worker zu. Nach der Bearbeitung entscheidet der Status erneut: Schreiben beenden, Keep-Alive parken oder schließen. Dieser Kreislauf bleibt schlank, weil die Queue-Verwaltung kostengünstig über epoll oder kqueue getrieben wird.
Ich sehe oft Missverständnisse: Die Event Queue ersetzt keine Worker, sie koordiniert deren Einsatz effizienter. Threads arbeiten weiterhin Requests ab, aber nur, wenn wirklich Bytes fließen. Das schont CPU und Speicher in Szenarien mit vielen „idle“ Keep-Alive-Verbindungen. Je sauberer das Timeout- und Buffer-Design, desto geringer das Risiko, dass Verbindungen unnötig lange in teuren Zuständen liegen. So lässt sich auch bei tausenden offenen Sockets die Antwortzeit konstant halten.
Keep-Alive-Problem klassischer MPMs
Bei HTTP/1.1 bleiben Verbindungen oft offen, um mehrere Requests ohne neuen Handshake zu senden, was Latenz spart. Prefork oder Worker binden dafür aber Prozesse oder Threads, die nur warten. Bei Lastspitzen blockieren dann viele Keep-Alive-Verbindungen wertvolle Ausführungsressourcen. Das treibt den RAM-Verbrauch hoch und limitiert die Zahl paralleler Clients. Event MPM entschärft das, indem die Event Queue Leerlauf-Sockets ohne Thread in einer günstigen Wartestellung hält.
So parke ich zahlreiche Verbindungen und starte die Verarbeitung erst bei tatsächlichem Bedarf. Das ändert das Kapazitätsmodell: Statt Threads = Verbindungen nutze ich Threads = aktive Arbeit. In Benchmark-Szenarien kann ich dadurch signifikant mehr offene Verbindungen zulassen, ohne Einbrüche bei der Reaktionszeit. Für API-Backends, WordPress-Hosting und große Content-Sites bedeutet das eine deutlich gleichmäßigere Auslastung. Die Keep-Alive-Vorteile bleiben erhalten, ohne dass Threads blockieren.
Event MPM vs. Worker MPM
Ich fasse die Unterschiede kompakt in einer Tabelle zusammen. Ziel ist ein schneller Blick auf Handling, Ressourcenbedarf und typische Einsatzfelder. Beide Varianten setzen auf Prozesse mit mehreren Threads, aber Event bindet Keep-Alive seltener an einen Thread. Worker bleibt solide für moderate Last, während Event bei vielen parallelen Verbindungen glänzt. Diese Einordnung hilft, Entscheidungen für die eigene Umgebung schlüssig zu treffen. Einen tieferen Vergleich biete ich unter Event vs. Worker.
| MPM | Keep-Alive-Handling | Threads/Prozesse | RAM-Bedarf | Geeignet für |
|---|---|---|---|---|
| Prefork | Prozess blockiert bei Leerlauf | Nur Prozesse | Hoch | Legacy-PHP ohne Thread-Safety |
| Worker | Thread bleibt oft gebunden | Prozesse + Threads | Mittel | Moderate Last, einfache Setups |
| Event | Event-Loop parkt Leerlauf-Sockets | Prozesse + Threads | Niedrig bis mittel | Viele Clients, lange Keep-Alive-Phasen |
Typische Einsatzszenarien
Ich setze Event MPM ein, wenn viele parallele Clients kleine bis mittlere Payloads anfragen. High-Traffic-Blogs, Shops mit Caching, statische Assets und API-Endpunkte profitieren spürbar. Genauso Hosting-Setups mit vielen Websites pro Server, in denen Keep-Alive-Verbindungen dominieren. Die Event Queue hält dort die Zahl aktiver Threads klein und verteilt Arbeit gleichmäßig. Wer HTTP/2 nutzt, profitiert nochmals, weil eine Verbindung mehrere Streams tragen kann, während die Event-Schicht die Zustände sauber koordiniert.
Auch bei Reverse-Proxy-Topologien zeigt Event seine Stärken. Ich lasse Apache SSL terminieren, Caching übernehmen und Requests an eine App-Schicht weitergeben. Dabei bleibt die Verbindungsverwaltung leichtgewichtig, was Engpässe entschärft. Selbst bei Traffic-Spitzen bleiben Antwortzeiten kontrollierbar, sofern Limits klug gesetzt sind. Das senkt das Risiko von Queue-Rückstau und Timeouts.
Konfiguration: Schlüssel-Direktiven
Für eine tragfähige Einstellung prüfe ich zuerst ServerLimit, StartServers, ThreadsPerChild und MaxRequestWorkers. Die Faustregel: ServerLimit × ThreadsPerChild sollte nahe an MaxRequestWorkers liegen, mit Puffer für Wartung und Wachstum. Ein zu kleiner Wert klemmt die Parallelität ab, ein zu großer bläht den RAM-Bedarf auf. Ich setze KeepAlive auf On, aber dimensioniere KeepAliveTimeout moderat, damit Leerlauf nicht ausartet. Werte zwischen wenigen und niedrigen zweistelligen Sekunden funktionieren oft gut, abhängig vom Traffic-Profil.
Weiterhin beachte ich Timeouts für Lesens, Schreiben und Proxies. Kürzere Werte schützen vor hängenden Backends, längere helfen bei träge reagierenden Clients, was Trade-offs erfordert. Für statische Dateien lohnt Senden in größeren Blöcken und der Einsatz effizienter Filterketten. Bei PHP via FPM oder Proxy-Balancern skaliere ich Backend-Worker zur Frontend-Parallelität passend. Ich dokumentiere jede Änderung und messe die Wirkung, bevor ich weiter drehe.
Tuning der Event Queue: Schritt für Schritt
Ich beginne mit einem klaren Lastprofil: gleichzeitige Verbindungen, Requests pro Sekunde, Antwortgrößen, Keep-Alive-Anteile. Danach lege ich MaxRequestWorkers so fest, dass die CPU nicht im Leerlauf bleibt, der RAM aber komfortabel reicht. ThreadsPerChild passe ich an, bis Lastspitzen ohne Wartezeit durchlaufen. KeepAliveTimeout kalibriere ich für eine gute Balance aus UX und Ressourcenschonung. Wer Queuing-Verhalten tiefer verstehen will, findet Grundlagen unter Webserver-Queueing.
Ich teste iterativ mit Tools wie ab, wrk oder k6 und analysiere Latenzen im P50, P95 und P99. Dabei beobachte ich, wann Verbindungen in Keep-Alive bleiben und wann sie schließen. Eine leichte Überprovisionierung an Threads hilft, kurze Spitzen abzufangen, ohne die Maschine zu überladen. Gleichzeitig prüfe ich Error-Logs auf Meldungen wie „server reached MaxRequestWorkers“. So erhalte ich ein stimmiges Zusammenspiel aus Event Queue und Worker-Pool.
Monitoring und Metriken
Gute Metriken sichern eine verlässliche Kapazität. Ich aktiviere mod_status und verfolge aktive, idle und wartende Worker. Das Scoreboard zeigt, ob Requests warten oder ob Ressourcen frei sind. Ergänzend messe ich Prozess- und Thread-Anzahl, RAM-Auslastung und Netz-I/O. Eine visuelle Auswertung hilft, Trends und Kipppunkte zu erkennen. Mehr Details liefert das Apache Scoreboard.
Ich korreliere diese Werte mit Access-Logs und Fehlercodes. Steigen 5xx-Raten bei gleichzeitig voller Auslastung, sind Limits oft zu niedrig. Nehmen Timeouts zu, prüfe ich Backend-Services, DNS-Auflösung und Netzwerkpfade. Ich schaue ebenso auf TCP-Backlogs und SYN-Retransmits bei Hochlast. So erkenne ich, ob die Ursache im Webserver, im Backend oder im Netzwerk liegt.
HTTP/2, Reverse Proxy und Module
HTTP/2 bündelt mehrere Streams über eine Verbindung, was die Event-Architektur ideal bedient. Ich achte auf die Balance zwischen Stream-Limits und Thread-Pool, damit viele kleine Streams nicht in Warteschlangen landen. Als Reverse Proxy profitiert Apache von schlanken Timeouts und verlässlichen Backend-Verbindungen. Module, die stark blockierend arbeiten, können jedoch Threads binden und die Vorteile schmälern. Ich prüfe daher Kompatibilität und ersetze veraltete Komponenten, wenn sie Latenzspitzen erzeugen.
Cache-Module und Kompression steigern Effizienz, solange CPU-Profile dazu passen. TLS-Optimierung mit modernen Ciphers und HTTP/2-Priorisierung hilft bei zügiger Auslieferung. Ich setze Session-Resumption ein und beobachte Handshake-Kosten unter Last. Für statische Assets funktionieren Zero-Copy-Ansätze und sendfile gut. Die Kunst liegt darin, die Kette aus TLS, Event Queue, Worker und Backend schlank zu halten.
Interner Ablauf und Zustände im Event MPM
Um die internen Abläufe zu verstehen, denke ich in Zuständen: accept → readable → processing → writable → keep-alive → close. Listener-Threads überwachen Sockets mithilfe effizienter Kernel-Mechanismen (epoll/kqueue) und wecken Worker nur, wenn ein Ereignis anliegt. Nach dem Abarbeiten eines Requests entscheidet die Event-Schicht, ob die Verbindung in Keep-Alive geparkt, direkt geschlossen oder in einen „lingering close“-ähnlichen Abschluss geht, damit späte TCP-Pakete sauber verarbeitet werden. Dieser Zustandsautomat verhindert „busy waiting“ und minimiert Kontextwechsel.
Wichtig ist dabei die Trennung von I/O-Wartezeit und CPU-Arbeit: Das Request-Parsing, Filter-Pipelines (z. B. Kompression) und das Generieren der Antwort laufen in Worker-Threads. Das reine Warten auf Lesbarkeit/Schreibbarkeit bleibt im Event-Loop. Dadurch nutzt Apache die vorhandenen Threads besser aus und reduziert die Thread-Dichte pro offene Verbindung drastisch.
Ich berücksichtige außerdem das Scoreboard-Verhalten: In mod_status lassen sich Phasen wie „R“ (Reading), „W“ (Sending Reply), „K“ (Keepalive) und „G“ (Gracefully finishing) ablesen. Eine hohe „K“-Quote bei gleichzeitig freien Workern zeigt, dass die Event Queue korrekt parkt und keine Threads verschwendet. Steigen „R“-Zeiten markant, deuten langsame Clients oder zu restriktive Read-Timeouts auf Optimierungspotenzial hin.
Ressourcenplanung: Beispielrechnung und sinnvolle Defaults
Ich kalkuliere die Parallelität aus CPU, RAM und Workload. Ein Beispiel: 8 vCPU, 16 GB RAM, primär gecachte Inhalte und PHP-FPM im Backend. Ich starte mit MaxRequestWorkers 512–768, ThreadsPerChild 32–64, ServerLimit entsprechend 8–12. Ich plane pro aktivem Worker 1–3 MB Apache-Overhead plus Module ein, hinzu kommen Antwortpuffer, TLS-Overhead und Backend-Sockets. Realistisch reserviere ich 4–8 GB für Apache-Prozesse/Threads, 2–4 GB für OS-Cache und den Rest für Backends. Ich achte darauf, dass ServerLimit × ThreadsPerChild nie kleiner als MaxRequestWorkers ist; etwas Puffer bleibt sinnvoll.
Nutzbringende Direktiven im Überblick: – MinSpareThreads/MaxSpareThreads: Halte die Reserve so, dass Lastspitzen ohne „Kaltstart“ abgefangen werden, aber nicht zu viele Idle-Threads Speicher binden. – MaxConnectionsPerChild (alias MaxRequestsPerChild): Ein endlicher Lebenszyklus pro Prozess hilft, Speicherfragmentierung und Leaks im Langzeitbetrieb zu vermeiden (z. B. 5k–20k). – MaxKeepAliveRequests: Limitiert Requests pro Verbindung; moderate Werte schützen vor „unendlichen“ Sessions, ohne den Keep-Alive-Nutzen zu beschädigen (z. B. 100–1000). – Timeout, Read/Write-Timeouts und ProxyTimeout: Verhindern Hänger; ich setze differenzierte Werte pro Kontext, statt global zu konservativ zu sein.
Für statische Dateien nutze ich EnableSendfile und EnableMMAP bewusst: Auf lokalen Disks können beide Vorteile bringen; bei NFS/Cloud-Volumes deaktiviere ich sendfile oft, um Edge-Cases zu vermeiden. In TLS-Pfaden hat sendfile bauartbedingt weniger Wirkung, da Daten durch Verschlüsselungspipelines laufen; hier zählt vor allem eine effiziente Filterkette.
Betriebssystem- und Netzwerklimits
Die beste Event-Architektur nützt wenig, wenn OS-Limits bremsen. Ich prüfe: – File Descriptors (ulimit -n): Der Wert sollte komfortabel über der maximalen Zahl gleichzeitiger Verbindungen plus Backend-Sockets liegen; mehrere zehntausend sind für Busy-Hosts üblich. – ListenBacklog: Ein ausreichend großer Accept-Backlog verhindert abgelehnte SYNs bei Spitzen. – Kernel-Backlogs (z. B. somaxconn) und SYN-Queues: Sie müssen zur erwarteten „Burst“-Rate passen. – Netzwerkpuffer (rmem/wmem): Nicht überdrehen, aber so dimensionieren, dass hohe RTT- oder High-Bandwidth-Strecken nicht kollabieren.
Ich verteile Accept-Last mit mehreren Listener-Threads und lasse die Plattform im Regelfall den Accept-Mechanismus wählen (AcceptMutex auto). Auf Systemen, die es unterstützen, kann SO_REUSEPORT (plattformabhängig per Listen-Option) die Akzeptanzpfade glätten. Wichtig ist, Thundering-Herd-Situationen zu vermeiden, in denen viele Threads um den gleichen Accept kämpfen.
Auch TCP-Ephemeral-Ports (ip_local_port_range) und TIME-WAIT-Verhalten müssen zur Anzahl paralleler Proxy-Verbindungen passen. Ich vermeide aggressive Tweaks, sondern teste realistisch und sichere, dass Backends Keep-Alive sprechen, damit Verbindungen wiederverwendet werden können und weniger Portdrehs entstehen.
Reverse-Proxy-Feinheiten: Verbindungspools und Backends
Als Reverse Proxy hängt die Gesamtleistung stark an stabilen Backend-Verbindungen. Ich sorge dafür, dass Proxy-Verbindungen persistent bleiben (Keep-Alive zum Backend) und dimensioniere Backend-Pools so, dass sie der Frontend-Parallelität folgen. Zu kleine Pools erzeugen Frontend-Stau, zu große erzeugen unnötige Last auf der App.
Praktische Stellschrauben: – ProxyTimeout: Kürzer für unkritische Pfade, länger für „teure“ Endpunkte – differenzieren, nicht global pauschalieren. – Balancer-Einstellungen (bei mod_proxy_balancer): Gewichte, Maximalverbindungen pro Backend, gesundheitssensitive Retry-Intervalle. – mod_proxy_fcgi für PHP-FPM: Die FPM-pm.*-Werte (pm.max_children, pm.start_servers etc.) müssen zur Apache-Parallelität passen, um 502/504-Spitzen zu vermeiden.
Ich achte darauf, dass Backend-Fehler sauber und schnell eskaliert werden, statt Frontend-Threads zu binden. Health-Checks, vorsichtige Retry-Politik und circuit-breaker-ähnliche Patterns halten die Latenzen stabil. Wo möglich, sorge ich für Antwort-Caching an geeigneten Stellen, damit das Event MPM vor allem leichte, kurze Antworten verschicken kann.
HTTP/2-Feintuning unter Event
Für HTTP/2 optimiere ich neben TLS vor allem Stream-Limits und Worker-Zuordnung. Viele kleine Streams pro Verbindung können die Latenz drücken, aber die Thread-Auslastung anheben. Ich setze die maximale Stream-Anzahl pro Session so, dass Multiplexing greift, aber kein „Head-of-line“-Ersatz entsteht. Zusätzlich skaliere ich die Anzahl der Worker konservativ nach oben, damit Burst-Phasen abgefedert werden, ohne den RAM zu sprengen.
Ich beobachte, wie oft Streams warten, obwohl Threads frei sind. Ist das der Fall, begrenzen meist Stream-Limits oder Puffergrößen den Durchsatz. Eine Priorisierung kritischer Ressourcen (z. B. CSS/JS über HTTP/2-Prioritäten) zahlt direkt auf die wahrgenommene Performance ein. Auf TLS-Seite senken Session-Resumption, 0-RTT-ähnliche Mechanismen (sofern sicher und verfügbar) und moderne Ciphers die Handshake-Kosten.
Robustheit: Timeouts, Schutz vor Slowloris und Graceful Shutdown
Ich aktiviere mod_reqtimeout, um Slowloris-ähnliche Muster zu entschärfen. Lesende Timeouts verhindern, dass Clients Bytes im Schneckentempo liefern und so Ressourcen belegen. Schreibende Timeouts schützen vor zähen Verbindungen Richtung Client. Diese Werte sind kontextabhängig zu wählen – APIs benötigen andere Profile als große Dateidownloads.
Für Rollouts und Neustarts setze ich auf Graceful-Abläufe. Mit einem sinnvollen Graceful-Timeout fahren alte Prozesse kontrolliert leer, während neue Prozesse übernehmen. So bleiben Keep-Alive-Verbindungen stabil, und die Event Queue beendet Restlast ohne abrupte Abbrüche. Rotierende Logs, geringe Log-Verbalität im Peak (z. B. „info“ statt „debug“) und optional BufferedLogs senken I/O-Last spürbar.
Fehlersuche unter Last: Muster erkennen
Typische Symptome und Ansätze: – Hohe P95/P99-Latenzen bei freien Workern: Meist Backend- oder Netzwerkwartezeiten; Proxy- und Read-Timeouts sowie Backend-Pools prüfen. – „server reached MaxRequestWorkers“: Parallelität zu knapp – MaxRequestWorkers und/oder ThreadsPerChild anheben, RAM-Footprint prüfen. – Viele Keep-Alive-Verbindungen, wenige aktive Threads, trotzdem langsam: Häufig blockierende Module/Filter oder Backend-Engpässe; Profiling der Filterkette, CPU-Sättigung und I/O prüfen. – 5xx-Spitzen mit korrelierender TLS-Last: CPU-bound Handshakes – Ciphers, Session-Resumption und gegebenenfalls Offload optimieren.
Ich trenne Engpässe entlang der Kette: Socket-Akzeptanz (Backlog), Event-Loop (Wartezustände), Worker (CPU-bound), Filter (I/O-bound), Proxy (Backend-bound). Dieses Denkmodell verhindert, dass ich an MaxRequestWorkers drehe, obwohl eigentlich das Backend knapp ist.
Praxis-Checkliste und typische Stolpersteine
Ich arbeite mit einer kurzen Checkliste: aktuelle Apache-Version, Event MPM aktiv, Limits sauber dimensioniert, Timeouts sinnvoll. Danach verifiziere ich Keep-Alive-Raten und die Relation zwischen Verbindungen und aktiven Threads. Ich prüfe, ob Module Thread-Safety mitbringen und ob Filter keine langen Blockaden verursachen. Für PHP via FPM stelle ich sicher, dass FPM-Worker zur Frontend-Parallelität passen. Ebenso kalibriere ich OS-Limits wie file descriptors, TCP-Backlog und Kernel-Parameter für Netzwerkpuffer, damit die Pipeline nicht stockt.
Häufige Stolpersteine erkenne ich schnell: zu große KeepAliveTimeouts, zu knappe MaxRequestWorkers, niedrige ThreadsPerChild oder unpassendes Logging. Übermäßig detailliertes Logging frisst I/O und verlangsamt Antworten. Eine zu kleine Proxy-Backend-Poolgröße entwertet Frontend-Tuning. TLS-Fehlkonfigurationen verlängern Handshakes unnötig. Wer diese Punkte sauber sortiert, schafft eine zuverlässige Grundlage für konstante Latenzen.
Zusammenfassung für Technik-Verantwortliche
Event MPM trennt Verbindungsverwaltung und Ausführung klar und setzt auf eine Event-Queue, die Leerlauf-Verbindungen günstig parkt. Dadurch skaliert Apache bei vielen gleichzeitigen Clients, ohne Threads in der Luft hängen zu lassen. Die richtige Mischung aus MaxRequestWorkers, ThreadsPerChild und durchdachten Timeouts hält Latenz und RAM-Verbrauch in Schach. Mit kontinuierlichem Monitoring, Benchmarking und wenigen gezielten Anpassungen entsteht ein System, das Spitzen abfängt und konsistent antwortet. Wer diese Prinzipien beherzigt, holt aus seiner Apache-Installation deutlich mehr heraus und bleibt zugleich kompatibel zu gängigen Anwendungen und Protokollen.