
CloudLinux Reports zeigen mir klar, welche LVE-Grenzen einzelne Accounts treffen und wo CPU, Speicher, I/O oder Entry Processes tatsächlich bremsen. Ich lese diese Daten gezielt, um wiederkehrende Faults, Tagesmuster und akute Engpässe zu erkennen und daraus konkrete Optimierungen abzuleiten.
Zentrale Punkte
Die folgenden Stichpunkte fasse ich vorab zusammen, damit du die Analyse fokussiert starten kannst.
- LVE-Kennzahlen richtig lesen: SPEED, MEM, IO, IOPS, PNO, EP
- Live-Daten mit LVE Manager und lvetop prüfen
- Verlauf via lveinfo, lvechart, cloudlinux-statistics
- Faults priorisieren: Häufigkeit, Zeitpunkt, Ursache
- Maßnahmen für CPU, RAM, I/O, EP ableiten
Die richtigen Kennzahlen lesen: SPEED, MEM, IO, IOPS, PNO, EP
Ich starte jede Analyse mit den Kennzahlen, die CloudLinux im LVE-Kontext ausweist. SPEED beschreibt die zugeteilte CPU-Rechenleistung, MEM steht für den RAM-Verbrauch, IO für Datendurchsatz und IOPS für die Anzahl der I/O-Operationen. PNO zeigt die Gesamtzahl laufender Prozesse, EP die gleichzeitigen Entry Processes, die Webzugänge begrenzen. Wer dauerhaft hohe Werte sieht, hat meist kein kurzes Peak-Problem, sondern ein strukturelles Lastprofil. Ich prüfe dabei immer, ob Limits kontinuierlich berührt werden oder ob nur einzelne Abrisse auftreten, die sich ohne Drosselung erklären lassen.
| Kennzahl | Bedeutung | Typische Symptome | Erste Checks |
|---|---|---|---|
| SPEED | CPU-Leistung (Anteil/Limit) | Lange PHP-Laufzeiten, Timeouts | PHP-Profile, Opcode-Cache, Caching prüfen |
| MEM | Arbeitsspeicher je Account | OOM-Kills, 500-Fehler unter Last | PHP memory_limit, Plugins, Queries sichten |
| IO | Durchsatz in MB/s | Langsame Downloads/Uploads | Static-Cache, Medien-Komprimierung, Storage |
| IOPS | Anzahl I/O-Operationen | Träge DB/Dateizugriffe | Indexe, Query-Plan, Objekt-Cache |
| PNO | Gesamtprozesse | Erhöhte Serverlast | Daemon-/Cron-Überhänge, Worker-Limits |
| EP | Gleichzeitige Web-Einstiege | 503-Fehler bei Peaks | HTTP-Cache, Rate-Limits, Bots prüfen |
Live-Überwachung mit LVE Manager und lvetop
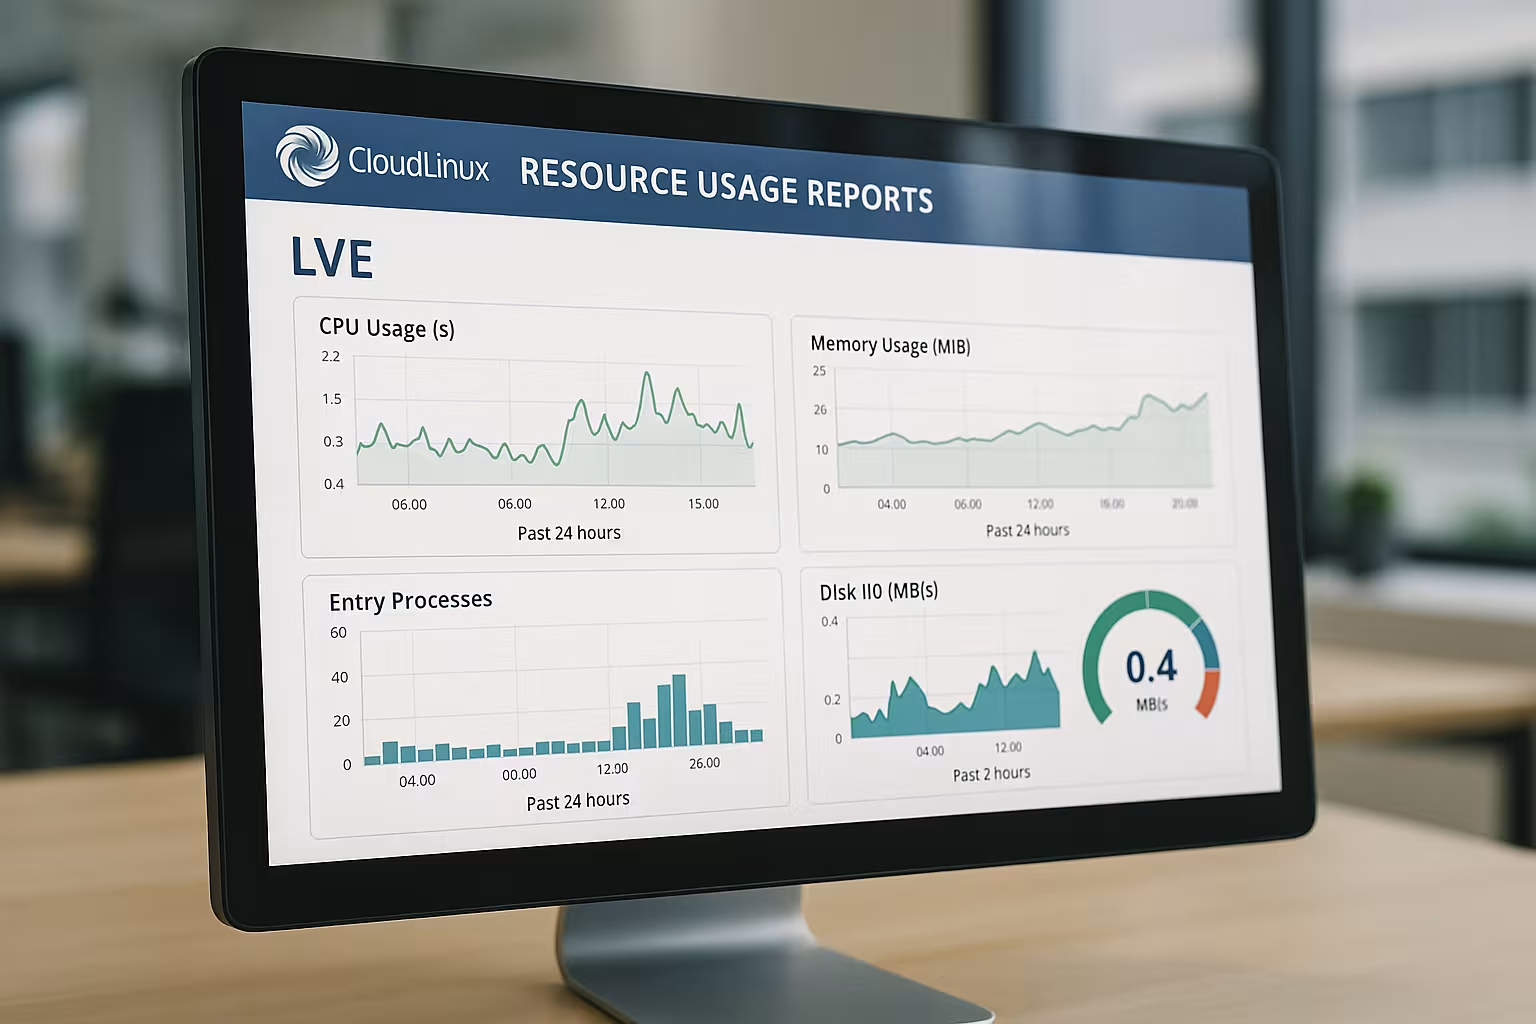
Für akute Analysen nutze ich die Live-Daten im LVE Manager und lvetop auf der Shell. Die Current-Usage-Ansicht zeigt mir in Echtzeit, wie CPU, RAM, I/O, IOPS, Prozesse und Entry Processes laufen. Bei Lastwellen beobachte ich, ob EP oder SPEED zuerst an die Grenze stoßen, denn das beeinflusst die nächsten Schritte. lvetop eignet sich, um die lautesten Accounts sofort herauszufiltern und im Fall der Fälle zu drosseln oder zu optimieren. Wer tiefer in die Oberfläche einsteigen will, passt Limits und Ansichten gezielt an – ich nutze dafür gern diesen Leitfaden: LVE Manager konfigurieren.
Historische Analyse: lveinfo, lvechart und cloudlinux-statistics
Trends erkenne ich über Verlauf und Fault-Historie, nicht nur über Momentaufnahmen. Mit lveinfo ziehe ich Zeitfenster und sehe, wann Limits exakt ausgelöst haben und wie häufig das geschah. lvechart liefert mir visuelle Peaks über Stunden oder Tage, wodurch Tageszeitmuster sichtbar werden. cloudlinux-statistics ergänzt die Auswertung, wenn ich pro Account längere Zeitreihen brauche. Aus der Kombination gewinne ich Antworten auf die Fragen „wann“, „wie oft“ und „unter welchen Bedingungen“ Belastungen entstehen.
Faults verstehen und priorisieren
Ein Fault bedeutet: Das Limit wurde getroffen, und CloudLinux hat gedrosselt. Ich sortiere Faults daher zuerst nach Häufigkeit, dann nach Ressourcenart und Tageszeit. Tägliche EP-Faults zur Mittagszeit weisen oft auf Traffic-Peaks oder Bots hin, während nächtliche RAM-Faults eher mit Cronjobs und Backups zu tun haben. Häufen sich CPU-Faults, suche ich ineffiziente PHP-Routinen, defekte Caches oder ungebremste Tasks. Diese Einordnung spart Zeit, weil ich Optimierungen genau dort ansetze, wo Nutzer spürbar eingeschränkt werden.
Ursachen ableiten: typische Muster und Gegenmaßnahmen
Aus der Erfahrung heraus ordne ich Muster schnell konkreten Ursachen zu. Dauerhaft hohe EP-Werte sprechen für zu viele gleichzeitige Requests oder fehlendes Edge-Caching. Anhaltend hoher RAM-Verbrauch zeigt häufig auf Plugins, Themes oder leaky Prozesse. IO- und IOPS-Spitzen deuten auf datenintensive Tasks, unindizierte Abfragen oder viele kleine Dateizugriffe. Um Fehlinterpretationen zu vermeiden, prüfe ich parallel System-Health-Indikatoren – ein schneller Einstieg gelingt mit den CloudLinux Health Checks.
Cronjobs, Backups und Bots erkennen
Viele Fault-Serien erklärt ein Blick auf Zeitpunkte und Aufgaben. Tritt die Drossel immer kurz nach voller Stunde auf, laufen oft Cronjobs parallel und konkurrieren mit Besuchern. Wiederkehrende Peaks nachts verweisen häufig auf Backups, die I/O und IOPS ausreizen. Auffällige EP-Faults ohne passenden Traffic in Analytics weisen oft auf Bots oder Scraper hin, die statische Inhalte umgehen. In solchen Fällen setze ich Rate-Limits, verschiebe Jobs in ruhigere Fenster und aktiviere Edge- oder Page-Caches konsequent.
Daten pro Reseller und Account auswerten
In größeren Setups trenne ich die Ebenen sauber: Reseller, deren Kunden und einzelne Accounts. Der LVE Manager erlaubt genau diese Sicht und zeigt mir, welcher Teilbaum Limits treibt. So erkenne ich, ob ein einzelner Kunde auffällig ist oder ob mehrere Projekte einer Wiederverkäufer-Struktur gleichzeitig drücken. Für Support-Prozesse markiere ich betroffene Accounts und hinterlege Maßnahmen, damit wiederkehrende Tickets schneller gelöst werden. Diese Transparenz hilft, Ressourcen fair zu verteilen und Kosten pro Mandant nachvollziehbar zu halten.
Grenzwerte richtig dimensionieren und Tarife anpassen
Limits setze ich realistisch, nicht maximal. Zu enge EP-Grenzen erzeugen 503-Fehler, während zu niedrige SPEED-Werte jede PHP-Antwort verzögern. Wer regelmäßig Faults sieht, prüft zuerst Optimierungen und danach die Tarife. Werden Projekte geschäftskritisch, lohnt sich ein höheres Profil, das Spitzen abnimmt und Konstanz bringt. Ich dokumentiere die Effekte in den Verlaufsgrafen, damit die Entscheidung nachvollziehbar bleibt.
Datenbank-lastige Projekte: I/O und IOPS optimieren
Bei datenbankzentrierten Sites prüfe ich IOPS und IO immer parallel zur Query-Qualität. Viele kleine Abfragen ohne Indexe erzeugen hohe IOPS und drücken die Reaktionszeit. Objekt-Cache, Query-Caching und angepasste Indizes reduzieren diese Flut erfahrungsgemäß deutlich. Für Trendanalysen lese ich zusätzlich die Datenbankberichte und gleiche sie mit LVE-Verläufen ab. Einen fundierten Einstieg liefert mir dieser Leitfaden zu MySQL Governor Reports, um DB-Last sauber einzuordnen.
Monitoring-Playbook: Von Alarm zu Aktion
Aus Messwerten forme ich ein Playbook, das jede Eskalation klar abbildet. Schritt 1: Live prüfen, ob aktuell Limits greifen, und welche Ressource zuerst fällt. Schritt 2: Historie öffnen, Zeitfenster abgleichen und Wiederholungen markieren. Schritt 3: Ursache lokalisieren – Codepfad, Cache, DB, Cron, Bot – und Gegenmaßnahme mit Testkriterium definieren. Schritt 4: Nach dem Eingriff erneut live und historisch prüfen, ob Faults und Latenz sinken. Diese feste Reihenfolge vermeidet Aktionismus und schafft reproduzierbare Ergebnisse.
Interdependenzen der Limits richtig deuten
In der Praxis greifen Limits selten isoliert. Ich bewerte deshalb die Wechselwirkungen zwischen EP, SPEED, MEM und IO/IOPS: Steigen EP und SPEED zeitgleich, limitiert meist CPU pro Request; hilft dann ein Page- oder Edge-Cache, fallen beide Kennzahlen gemeinsam. Sehe ich erhöhte EP mit konstant niedriger SPEED, stauen Requests im Webserver, häufig wegen knapper Worker, Keep-Alive-Konfigurationen oder blockierender externer Calls (z. B. API, Mail). MEM-Faults bei moderatem SPEED deuten auf wenige, aber speicherhungrige Prozesse hin (etwa Bildkonvertierung, große Exporte). IO/IOPS-Peaks ohne nennenswerte CPU-Last verweisen auf datenintensive Datei- oder Datenbankzugriffe. Diese Korrelationen nutze ich, um die erste Hypothese zu setzen, bevor ich tiefer in Code- oder Serverdetails einsteige.
Praxis: lvetop, lveinfo und cloudlinux-statistics effizient bedienen
Für schnelle Befunde arbeite ich mit klaren Abfragen und Filtern. lvetop hilft mir im Sekundentakt, die Top-Verbraucher zu sehen und zwischen CPU-, MEM- oder IO-Sortierung zu wechseln. Mit lveinfo ziehe ich 1h-, 24h- und 7d-Fenster, um Fault-Zeitpunkte, Spitzenwerte und betroffene Ressourcen je Account zu listen. cloudlinux-statistics liefert mir längere Zeitreihen und eignet sich, um Maßnahmen zu belegen (vorher/nachher). Ich dokumentiere pro Eingriff immer: Zeitraum, betroffene Accounts, Maxima je Ressource, Fault-Anzahl sowie Response-Zeiten aus dem Application- oder Web-Monitoring. Dadurch kann ich Optimierungen belegen und verhindern, dass Limits „auf Verdacht“ gelockert werden.
Webstack-Feinheiten: PHP-Handler, Worker und OPcache
Ein großer Hebel liegt in der PHP-Ausführung: Anzahl der PHP-Worker pro Account, deren RAM-Budget (memory_limit) und der OPcache. Zu viele Worker ohne Cache erhöhen EP/PNO und MEM, zu wenige Worker stauen Requests (EP wächst, Antwortzeit steigt). Ich ermittle daher einen Sweet Spot: so viele Worker wie nötig, so wenige wie möglich. Der OPcache muss ausreichend dimensioniert sein (Speicher und interned strings), sonst kompiliert PHP ständig neu und treibt SPEED. Ergänzend prüfe ich, ob statische Ressourcen wirklich vom Webserver (und nicht von PHP) bedient werden und ob Keep-Alive/HTTP/2-Multiplexing richtig greifen. Ziel ist, dynamische Requests zu reduzieren und die verbliebenen zügig abzuarbeiten.
Caching-Strategien konsequent einsetzen
Ich unterscheide drei Ebenen: Edge-/CDN-Cache für globale Entlastung, HTTP-/Page-Cache direkt vor PHP und Objekt-Cache innerhalb der Anwendung. Edge-Cache senkt EP und IO für statische Assets drastisch. Page-Cache reduziert dynamische Hits und wirkt direkt auf EP/SPEED. Objekt-Cache (z. B. für häufige DB-Lookups) senkt IOPS und CPU. Wichtig ist ein stabiler Cache-Key (z. B. keine unnötigen Cookies) sowie sinnvolle TTLs pro Seitentyp. Für Admin- oder Warenkorb-Bereiche plane ich Ausnahmen, überall sonst strebe ich eine möglichst hohe Cache-Quote an. Nach Aktivierung beobachte ich: Fallen EP-Faults? Reduzieren sich mediane Antwortzeiten?
RAM-Management: memory_limit, Prozesse und Leaks
MEM-Faults entstehen oft, weil memory_limit großzügig gesetzt ist und parallele Prozesse die Summe sprengen. Ich kalibriere daher: wie viel RAM braucht ein typischer Request? Daraus leite ich die maximal sinnvolle Worker-Zahl ab. Zusätzlich halte ich PHP-Libs und Plugins schlank, entferne ungenutzte Erweiterungen und prüfe Long-Running-Skripte (Exporte, Importe, Bildverarbeitung) auf Leaks. Der OPcache reduziert RAM-Druck, wenn er Kompilate zwischenhält, darf aber selbst nicht zu klein bemessen sein. Bei wiederkehrenden Peaks isoliere ich mit Profiling die „teuren“ Pfade und setze gezielt an – das spart häufiger RAM als pauschale Limit-Erhöhungen.
I/O und IOPS gezielt drücken
IO/IOPS-Spitzen entstehen durch viele kleine Datei- oder DB-Zugriffe. Ich bündele Workloads, wo möglich: Thumbnail-Generierung als Batch statt On-Demand, Asset-Minifizierung im Build statt bei jedem Request, Session- und Transient-Speicher in einen Objekt-Cache auslagern, damit weniger Dateizugriffe anfallen. In der Datenbank priorisiere ich Indizes für häufige WHERE-/JOIN-Klauseln und eliminiere N+1-Queries. Parallel vergleiche ich LVE-Verläufe mit den DB-Reports aus dem MySQL Governor, um Hotspots zu belegen. Ziel ist, viele kleine IOPS in wenige, effiziente Zugriffe zu verwandeln – das glättet Peaks und verringert Fault-Wahrscheinlichkeit.
EP-Fehler entschärfen: Queueing und Besucherströme
EP begrenzt gleichzeitige Einstiege. Treffen viele Requests auf karge Caches, schlagen EP-Faults schnell durch. Ich verhindere das, indem ich Warteschlangen vor PHP einführe (kurze Request-Queues im Webserver), Keep-Alive sinnvoll setze und dynamische Pfade, die nicht personalisiert sind, konsequent cachen lasse. Für Bots definiere ich Rate-Limits und blockiere offensichtliche Bad Actors früh. Zusätzlich prüfe ich Third-Party-Aufrufe im Request-Pfad – blockierende externe Dienste erhöhen Verweildauer pro Request und verbrauchen damit EP. Wo möglich, verschiebe ich externe Integrationen in Jobs/Queues.
Cronjobs und Backups ressourcenschonend planen
Wiederkehrende Aufgaben entkopple ich von Stoßzeiten und reguliere sie: Cron-Tabellen entzerre ich (Minuten versetzen), parallele Läufe verhindere ich mit Lockfiles, und ich reguliere Last per Nicing und Batch-Größen. Backups plane ich auf Zeitfenster mit geringem Traffic und achte auf inkrementelle Verfahren, damit IO/IOPS im Rahmen bleiben. Für aufwändige In-App-Jobs setze ich Limits für gleichzeitige Worker, damit MEM und SPEED nicht sprunghaft steigen. Die Auswirkung prüfe ich im Verlauf: sinken nächtliche Faults, reduzieren sich Lastzacken nach voller Stunde?
CageFS, Dateisystem und Inodes im Blick
Neben LVE-Limits beeinflussen Dateisystem-Faktoren die Performance: Millionen kleiner Dateien (etwa Cache-Fragmente) erhöhen Metadatenzugriffe und treiben IOPS. Ich halte Cache-Verzeichnisse aufgeräumt, begrenze Dateiflut durch sinnvoll aggregierte Caches und prüfe Inode-Auslastung. CageFS sorgt für Isolation, doch falsch platzierte temporäre Dateien (z. B. im Webroot statt im tmp-Verzeichnis) erhöhen IO unnötig. Ein periodischer Health-Check dieser Bereiche verhindert, dass I/O-Engpässe fälschlich als reine CPU- oder RAM-Probleme interpretiert werden.
Transparenz und Kommunikation im Reseller-Kontext
In Reseller-Umgebungen dokumentiere ich Lasttreiber je Unterkunde und halte Maßnahmen fest: Welche Limits wurden getroffen? Welche Optimierungen sind geplant? Wie sehen Vorher-/Nachher-Grafen aus? Diese Transparenz beschleunigt Support-Antworten und schafft Akzeptanz für Tarifwechsel, wenn Optimierungspotenzial ausgeschöpft ist. Ich etabliere Grenzwerte, ab denen wir aktiv werden (z. B. wiederkehrende Faults > N/Tag oder mediane Antwortzeit > X ms), und verknüpfe sie mit klaren Handlungspfaden – damit entstehen keine Endlos-Schleifen im Ticketing.
Häufige Fehlinterpretationen vermeiden
Ein paar Muster sehe ich regelmäßig: Steigende CPU ist nicht automatisch ein Hinweis auf „zu wenig CPU“ – oft arbeiten Caches nicht oder Queries sind ineffizient. Viele EP-Faults bedeuten nicht zwingend „mehr Traffic“ – Bots, fehlkonfigurierte Monitoring-Tools oder Heartbeats können die Ursache sein. MEM-Faults lassen sich nicht immer durch höheres memory_limit lösen – oft sind es zu viele gleichzeitige Prozesse. IO/IOPS-Peaks hängen nicht ausschließlich am Storage – Applikationsmuster lösen sie aus. Ich verifiziere Hypothesen daher stets mit korrelierten Diagrammen und, wenn möglich, mit kurzen Gegenproben (z. B. Cache für Teilbereich aktivieren und Verlauf erneut prüfen).
Testen, messen, nachschärfen
Jede Änderung bewerte ich mit klaren Messpunkten: vor/nach Aktivierung des Page-Caches, vor/nach Index-Ergänzung, vor/nach Worker-Anpassung. Dazu nutze ich LVE-Verlauf, Response-Zeit-Metriken und Fehlerraten (5xx/4xx). Wo möglich, führe ich A/B-Vergleiche in Randzeiten durch, um Rückwirkungen zu isolieren. Bleiben Faults bestehen, iteriere ich: Limit-Kombination feinjustieren, weitere Hotpaths profilieren, Batch-Größen der Jobs anpassen. Die Erfahrung zeigt: Zwei bis drei gezielte Schleifen liefern deutlich bessere Ergebnisse als eine große, pauschale Maßnahme.
Zusammenfassung: So lese ich CloudLinux Resource Usage Reports effizient
Ich bewerte CloudLinux-Daten immer dreistufig: Live, Historie, Faults. Die Kennzahlen SPEED, MEM, IO, IOPS, PNO und EP liefern mir die Landkarte für Ursachen und Wirkung. Mit lvetop sehe ich sofort, wer drückt; mit lveinfo und lvechart belege ich Muster über Tage. Aus wiederkehrenden Faults leite ich Caching, Query-Tuning, Limit-Anpassungen oder Tarifwechsel ab. Diese Methode senkt Supportaufwand, erhöht Reaktionssicherheit und macht Hosting-Performance transparent.


